Trong phòng thi, thời gian là giới hạn chính. Còn 35 phút, đã có model ảnh khá tốt nhưng bài văn bản chưa có bài nộp nào: nên thử thêm cho bài ảnh hay làm bài văn bản? Bài này học cách chia thời gian giữa các bài, khi nào nên dừng cải tiến một bài, và cách luôn có một bài nộp hợp lệ trước khi thử cái mới.
Ví dụ trong bài là một buổi luyện 180 phút gồm việc A về văn bản, B về ảnh và C về tìm kiếm có phản hồi. Với kỳ thi thật, các con số lấy theo thể lệ của kỳ thi đó.
Đọc một bài để biết cần hoàn thành điều gì
Trong lập trình thi đấu, đọc đề thường kết thúc bằng một thuật toán và độ phức tạp. Với AI, ta còn phải xác định quy trình chấm. Bài có thể yêu cầu một file dự đoán, một model đã lưu hoặc một notebook chạy từ đầu. Nếu chỉ nộp dự đoán, thời gian tạo file nằm ở phía ta. Nếu bộ chấm chạy notebook, khởi động, đọc dữ liệu và model, huấn luyện và suy luận có thể cùng nằm trong giới hạn thời gian chạy (runtime). Hai dạng đó dẫn tới hai kế hoạch rất khác.
Ghi một bảng ngắn trước khi viết model. Mỗi ô cần trả lời một câu có thể kiểm: nhãn xuất hiện ở file nào; mẫu mới có cùng người, cùng camera hoặc cùng thời điểm với train không; metric cần nhãn hay xác suất; tên file và thứ tự ID phải là gì. “GPU có sẵn” chưa đủ: cần biết bộ nhớ, số tiến trình, model được cấp và việc tải thêm có được phép không.
| Điều cần hiểu | Ví dụ trong buổi luyện | Quyết định đi theo |
|---|---|---|
| Đơn vị một mẫu | Một đoạn văn; nhiều đoạn thuộc cùng tài liệu | Chia theo tài liệu nếu cần tổng quát sang tài liệu mới |
| Metric | Log loss, càng thấp càng tốt | Lưu xác suất, không chỉ lưu nhãn |
| Dạng nộp | CSV id,probability |
Kiểm range, ID và thứ tự dòng |
| Runtime chấm | Giả định chỉ chạy inference | Đo đọc model và inference, không cộng nhầm thời gian luyện |
| Tài nguyên | CPU và dữ liệu có sẵn trên máy trong ví dụ | Chọn baseline không cần tải model |
Quy định thật luôn gắn với từng kỳ thi. IOAI 2026, Individual Contest: quy định chung nêu hai ngày, ba bài mỗi ngày, sáu giờ mỗi ngày. Phụ lục kỹ thuật đưa giới hạn đánh giá chung, nhưng đề từng bài có thể chỉ định giới hạn khác; repo công bố sau kỳ thi ghi runtime từng bài khác nhau. Vì vậy ta đọc đề cụ thể trước khi lập kế hoạch. Rules & Technical Appendix 2026, Individual Contest 2026.
Kỳ thi khác có yêu cầu khác. Ở USA-NA-AIO 2026, Vòng 2, mỗi bài mở yêu cầu nộp ba tệp: file dự đoán CSV, notebook chứa toàn bộ code và báo cáo mô tả model đã nộp cùng các hướng đã thử nhưng không dùng; có bài ghi rõ notebook không chạy được trên GPU L4 thì phần đó 0 điểm. Đề Vòng 1 còn ghi chất lượng lập luận là một tiêu chí chấm. Khi đó nhật ký thí nghiệm là nguyên liệu của bài làm, không chỉ là ghi chú riêng. Đề Vòng 2, Ngày 1, đề Vòng 1.
Hỏi nhanh
Đề chấm bằng cách chạy lại notebook từ đầu trên máy chấm, giới hạn 5 phút. Đội chỉ bấm giờ dòng model.predict(X_test), được 40 giây. Phép đo này còn thiếu gì?
Runtime gắn với quy trình chấm, không gắn với tên một hàm. Máy chấm chạy mọi cell, kể cả đọc dữ liệu, nạp model và train lại. Một notebook train mất 6 phút sẽ hết giờ trước khi tới được predict. Ghi CSV có tốn thời gian, nhưng không phải phần thiếu chính. Nhân theo số seed chỉ ước lượng phần predict của một ensemble.
Hỏi nhanh
Metric là log loss trên 100 mẫu, và scorer cắt xác suất vào . Đội nộp nhãn cứng 0/1 thay cho xác suất, và đúng 90 mẫu. Log loss xấp xỉ bao nhiêu?
Mỗi mẫu sai bị tính , còn mẫu đúng gần 0. Trung bình là . Nộp hằng 0.5 cho , dù không học gì. 0.10 là tỉ lệ lỗi, tức thang của accuracy. là log loss khi mọi mẫu được gán xác suất 0.9 cho lớp đúng, không phải khi nộp 0/1. Scorer ở đây đã cắt, nên không báo lỗi. Metric cần xác suất thì phải lưu xác suất ngay từ baseline.
Có baseline trước khi có tham vọng
Baseline đầu tiên trả lời hai câu: ta có hiểu metric không, và đường từ dữ liệu tới bài nộp có chạy được không? Với văn bản, TF-IDF cùng logistic regression thường là mốc dễ dựng; với embedding có sẵn, linear probe hoặc kNN là mốc để kiểm shape và nhãn. Baseline của ta dùng để kiểm quy trình; baseline do ban tổ chức cung cấp còn có thể tham gia cách tính điểm. Đừng nhập hai ý đó làm một.
Quy tắc chuẩn hóa ở mục 2.5 của IOAI 2026 Individual Contest dùng điểm baseline làm mốc thấp. Ta minh họa công thức bằng dữ liệu tự đặt, với metric càng cao càng tốt:
là metric của bài nộp, là metric baseline, là mốc cao trong công thức của kỳ thi. Cả ba phải cùng đơn vị. Nếu accuracy được lưu trong khoảng 0 đến 1 thì không đưa 85 vào chỗ cần 0.85. Công thức không khiến việc đo baseline trở nên vô ích: chạy baseline giúp tìm lỗi, còn đạt đúng baseline cho giá trị trong công thức.
Với metric càng thấp càng tốt như RMSE hay log loss, chỉ cần hiểu là giá trị tốt nhất thì công thức vẫn đúng chiều, vì . Phần cắt điểm âm, subtask hay trọng số giữa các phần thì phải đọc trong statement.
Code dưới tính lại hai trường hợp và kiểm rằng đạt đúng baseline cho 0:
import numpy as np

def normalized_score(raw, baseline, upper):
    assert upper > baseline
    return 100 * (raw - baseline) / (upper - baseline)

for name, baseline, upper, raw in [
    ("A", 0.58, 0.90, 0.70),
    ("B", 0.60, 0.90, 0.75),
]:
    print(name, f"{normalized_score(raw, baseline, upper):.2f}")
print("baseline", normalized_score(0.58, 0.58, 0.90))
A 37.50
B 50.00
baseline 0.0
Ở A, mức tăng được chia cho khoảng , cho điểm minh họa. Ở B, cho . Hai accuracy thô không so trực tiếp được nếu baseline và khoảng chuẩn hóa khác.
Mốc cao không phải lúc nào cũng biết trước. USA-NA-AIO 2026 Vòng 2 dùng cùng dạng tỉ lệ nhưng lấy là điểm tốt nhất trong mọi bài nộp; có bài còn lấy mốc tốt hơn giữa bài thí sinh tốt nhất và một model chuyên gia mà ban giám khảo giữ kín; bài tệ hơn baseline được 0 điểm. Đề Vòng 2, Ngày 1. Khi đó cùng một file nhận điểm khác nhau tùy bài tốt nhất của người khác.
Lúc lập kế hoạch ta chỉ có khoảng ước lượng của ; phần kiểm soát được là .
Hỏi nhanh
Với và , cải thiện metric từ 0.66 lên 0.70 làm tăng bao nhiêu?
. 4 điểm là quên chia cho khoảng chuẩn hóa . 40 điểm là , tức mức đang có chứ không phải phần tăng. 0.10 là quên nhân 100.
Chia thời gian theo bước có thể kiểm chứng
Nếu dành hết giờ cho training, ta đánh cược rằng mọi bước còn lại đều chạy ngay. Một kế hoạch có ích phải giữ thời gian để phát hiện cược đó sai. Trong buổi 180 phút, ta dành 30 phút đầu đọc đề và dựng đường nộp tối thiểu cho cả ba việc, dành 20 phút cuối chạy lại và kiểm file. Còn 130 phút cho cải thiện. Phần cuối lớn hay nhỏ tùy thời gian một lần chạy lại từ đầu: notebook cần 15 phút để chạy lại thì 20 phút đã sát.
Mỗi thí nghiệm cần một điểm dừng. Ví dụ “thử chuẩn hóa đặc trưng rồi đo trên split đang giữ” rõ hơn “tinh chỉnh tiếp model”.
Trước lúc chạy, viết giả thuyết: lỗi tập trung ở đoạn ngắn vì vector quá thưa; thay n-gram có thể giúp. Ghi split, metric, thời gian và thay đổi duy nhất. Sau lúc chạy, kết quả âm vẫn hữu ích: nó loại một hướng thử, miễn là ta không âm thầm đổi split để giữ kết luận mong muốn.
Để nhìn rõ việc phân bổ, ta đặt ba chuỗi thí nghiệm. Mỗi ô là ước lượng của đội lúc lập kế hoạch: tổng số phút và điểm chuẩn hóa tăng thêm so với baseline. Mức 2 của mỗi việc cần mức 1 trước; chi phí đã cộng dồn. Ở C, mức 1 chỉ là dựng bộ mô phỏng phản hồi trên máy, gần như chưa tăng điểm; mức 2 mới dùng bộ mô phỏng ấy để tìm kiếm.
| Việc | Mức 0 | Mức 1: phút, điểm tăng dự kiến | Mức 2: tổng phút, tổng điểm |
|---|---|---|---|
| A | Giữ baseline | 30, 10 | 60, 14 |
| B | Giữ baseline | 40, 14 | 80, 17 |
| C | Giữ baseline | 25, 2 | 60, 16 |
Ba lựa chọn mỗi việc cho kế hoạch: đây là knapsack nhóm, mỗi việc chọn đúng một mức. Với ba việc, duyệt hết là đủ nhanh. Ta so nó với cách chọn tham lam quen thuộc: lặp lại việc lấy bước kế tiếp có điểm mỗi phút cao nhất mà còn vừa ngân sách.
from itertools import product

options = {
    "A": [(0, 0), (30, 10), (60, 14)],
    "B": [(0, 0), (40, 14), (80, 17)],
    "C": [(0, 0), (25, 2), (60, 16)],
}

def plan_total(levels):
    chosen = [options[name][level]
              for name, level in zip(options, levels)]
    minutes = sum(cost for cost, gain in chosen)
    return minutes, sum(gain for cost, gain in chosen)

def best_plan(budget):
    plans = []
    for levels in product(range(3), repeat=3):
        minutes, gain = plan_total(levels)
        if minutes <= budget:
            plans.append((gain, -minutes, levels))
    gain, negative_minutes, levels = max(plans)
    return levels, -negative_minutes, gain

def greedy_plan(budget):
    levels = [0, 0, 0]
    while True:
        steps = []
        for i, name in enumerate(options):
            if levels[i] == 2:
                continue
            (c0, g0), (c1, g1) = options[name][levels[i]:levels[i] + 2]
            if plan_total(levels)[0] + c1 - c0 <= budget:
                steps.append(((g1 - g0) / (c1 - c0), i))
        if not steps:
            return tuple(levels), *plan_total(levels)
        levels[max(steps)[1]] += 1

print("duyệt hết", best_plan(130))
print("tham lam ", greedy_plan(130))
duyệt hết ((1, 1, 2), 130, 40)
tham lam ((2, 1, 1), 125, 30)
Mỗi bộ ba là mức của A, B, C, rồi tổng phút và tổng điểm. Duyệt hết chọn mức 1 cho A, mức 1 cho B và mức 2 cho C: phút, điểm dự kiến.
Tham lam lấy B rồi A (0.35 và 0.33 điểm mỗi phút), rồi thấy bước kế của C chỉ cho điểm mỗi phút, thua bước thứ hai của A (), nên dồn giờ vào A. Khi quay lại C thì chỉ còn đủ giờ cho mức 1, và kế hoạch dừng ở 125 phút, 30 điểm. Bước thứ hai của C đáng điểm mỗi phút, cao nhất bảng, nhưng muốn có nó phải trả bước đầu kém hấp dẫn.
Xếp theo điểm mỗi phút chỉ tối ưu khi các việc độc lập và chia nhỏ được; ở đây mỗi việc là chuỗi bước phụ thuộc nhau và không chia nhỏ được. Với nhiều việc hơn, thay duyệt hết bằng quy hoạch động theo số phút.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProÍch lợi dự kiến cần đi cùng rủi ro
Phòng thi không biết trước bảng trên. Một hướng mới có thể tăng điểm, có thể không tạo được bài nộp. Ta dùng một mô hình quyết định đơn giản:
là xác suất chủ quan thí nghiệm thành công, là mức tăng nếu thành công, là số phút. có đơn vị điểm dự kiến mỗi phút. Ví dụ sửa schema có thể tạo ít điểm model nhưng xác suất cao và cứu một bài nộp; thử một kiến trúc chưa dùng bao giờ có mức tăng lớn nhưng nhỏ. và là ước lượng chủ quan, nên dùng để so thứ tự giữa các bước, không cần chính xác đến chữ số thứ hai.
experiments = [
    ("fix-schema", 0.9, 8, 10),
    ("new-model", 0.3, 20, 40),
    ("another-seed", 0.7, 2, 20),
]
ranked = sorted(experiments,
                key=lambda item: item[1] * item[2] / item[3],
                reverse=True)
for name, probability, gain, minutes in ranked:
    value = probability * gain / minutes
    print(name, f"{value:.2f} expected-points/min")
fix-schema 0.72 expected-points/min
new-model 0.15 expected-points/min
another-seed 0.07 expected-points/min
Sửa schema đứng đầu với điểm dự kiến mỗi phút; model mới là ; seed thêm là . Nhưng sửa schema là bước bắt buộc nếu file đang sai, còn công thức chỉ hỗ trợ so sánh các bước tùy chọn. Không lấy một tỉ số để bỏ qua yêu cầu của đề, quyền sử dụng dữ liệu hay nguy cơ mất bài nộp cuối.
2 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProLượt nộp là một phép đo, không phải vòng tìm nhãn
Một lượt nộp tốt trả lời câu hỏi cụ thể. Nếu validation local tăng nhưng điểm phản hồi giảm, ta kiểm sự khác nhau giữa split, cách tính metric, thứ tự lớp và môi trường. Nếu thay năm yếu tố cùng lúc, phản hồi không giúp biết yếu tố nào có tác dụng.
Việc gửi nhiều dự đoán để suy ngược nhãn kín làm mất mục đích đánh giá và có thể vi phạm quy định; điều ta cần luyện là mô hình tổng quát, không phải đọc trộm đáp án từ scorer.
Ghi nhật ký như một thí nghiệm. Dòng “R03: đổi n-gram, giữ split S1, log loss giảm, runtime tăng ít” có thể kiểm lại; dòng “bản mới tốt nhất” thì không. Nhật ký ấy cũng là nguyên liệu cho phần báo cáo ở những kỳ thi chấm lập luận.
Điểm public chỉ tính trên một phần test, nên có nhiễu lấy mẫu. Để thấy nhiễu lớn đến đâu, giả sử test kín có 2000 dòng. Model A đúng 1600 dòng (accuracy 0.80), model B đúng 1620 dòng (0.81); hai model cùng đúng 1540 dòng, cùng sai 320 dòng, chỉ khác nhau ở 140 dòng. Ta rút ngẫu nhiên phần public 200 hoặc 1000 dòng nhiều lần, rồi đếm tỉ lệ public không thấy B tốt hơn.
rng = np.random.default_rng(0)
# 2000 dòng chấm kín; 1 = đoán đúng, 0 = đoán sai
correct_a = np.r_[np.ones(1540), np.ones(60), np.zeros(80), np.zeros(320)]
correct_b = np.r_[np.ones(1540), np.zeros(60), np.ones(80), np.zeros(320)]
print("hidden", correct_a.mean(), correct_b.mean())
for public_size in (200, 1000):
    gaps = []
    for _ in range(5000):
        rows = rng.choice(2000, size=public_size, replace=False)
        gaps.append(correct_b[rows].mean() - correct_a[rows].mean())
    gaps = np.array(gaps)
    print(public_size, f"A >= B: {np.mean(gaps <= 0):.2f}",
          f"std {gaps.std():.3f}")
hidden 0.8 0.81
200 A >= B: 0.33 std 0.018
1000 A >= B: 0.05 std 0.006
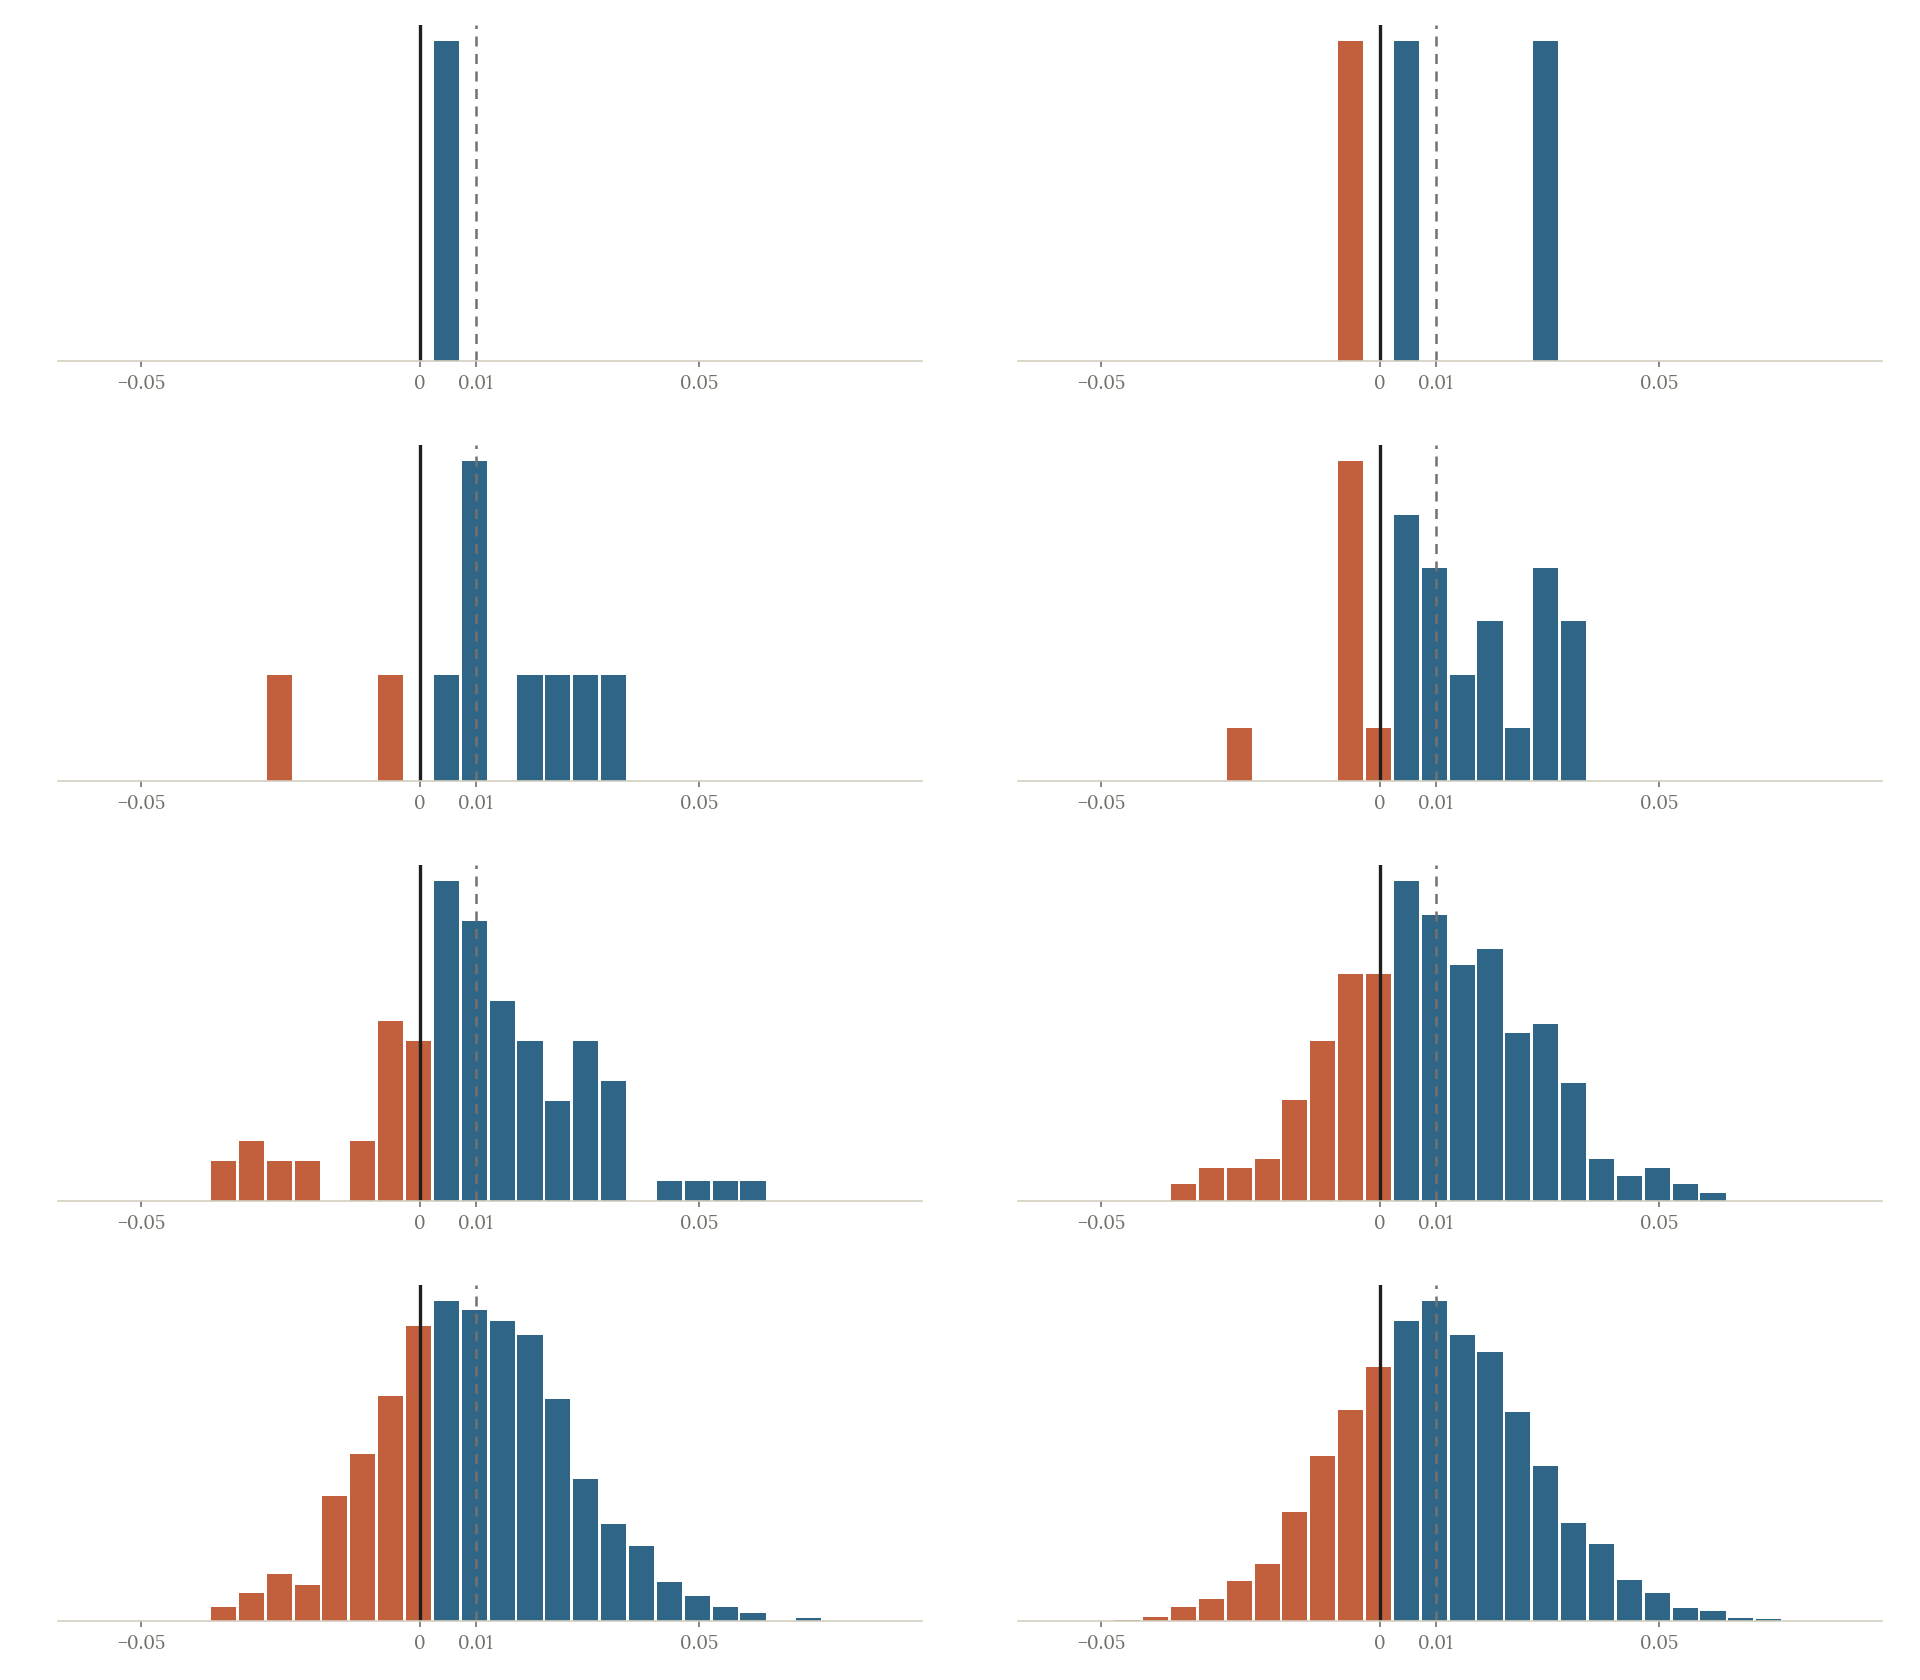
Với public 200 dòng, khoảng một phần ba số lần public xếp A ngang hoặc hơn B, dù trên toàn bộ test B hơn 0.01. Độ lệch chuẩn của chênh lệch public (0.018) lớn hơn chính chênh lệch thật. Public 1000 dòng chỉ xếp sai khoảng 5% số lần. Lý do nằm ở 140 dòng khác nhau: public 200 dòng chứa trung bình 14 dòng trong số đó.
Vì vậy hai bản chênh vài dòng trên public chưa chứng minh bản nào tốt hơn trên tập kín. Bản cuối nên được chọn bằng bằng chứng nhất quán trên validation hợp lệ; chọn bản có public cao nhất trong nhiều lượt nộp là chọn cả phần may mắn (bài 1.7).
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProGiữ đường nộp luôn hoạt động
Quay lại tình huống mở bài: còn 35 phút và bài văn bản chưa có file hợp lệ. Một bản tối thiểu ngang baseline cho , nên giá trị của nó không nằm ở điểm số lúc ấy mà ở chỗ mọi cải thiện của bài văn bản đều phải đi qua đường nộp này; không có file thì bài đó chắc chắn 0 điểm dù model tốt đến đâu. Seed thêm cho ảnh, theo bảng xếp hạng ở mục về ích lợi dự kiến, chỉ đáng khoảng 0.07 điểm dự kiến mỗi phút.
Thứ tự hợp lý là dựng và lưu bản văn bản hợp lệ trước, dùng phần còn lại để đưa nó vượt baseline, và chỉ chạy seed khi mọi việc đã có bản dự phòng.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProCode dưới ghi bảng dự đoán thành văn bản CSV rồi đọc lại đúng như bộ chấm sẽ đọc. ID được đọc như chuỗi để không mất số 0 ở đầu.
import pandas as pd
from io import StringIO

expected_ids = ["001", "007", "010"]
submission = pd.DataFrame({
    "id": expected_ids,
    "probability": [0.15, 0.80, 0.55],
})
csv_text = submission.to_csv(index=False, lineterminator="\n")
readback = pd.read_csv(StringIO(csv_text),
                       dtype={"id": str})
assert readback.columns.tolist() == ["id", "probability"]
assert readback["id"].tolist() == expected_ids
assert readback["id"].is_unique
assert np.isfinite(readback["probability"]).all()
assert readback["probability"].between(0, 1).all()
print(csv_text.rstrip())
print("readback", readback.shape, "OK")
id,probability
001,0.15
007,0.8
010,0.55
readback (3, 2) OK
Dòng 001 còn nguyên và bảng có ba hàng, hai cột. Shape đúng chưa đủ: xác suất phải hữu hạn và nằm trong miền hợp lệ. Bài nhiều lớp còn cần kiểm thứ tự cột lớp và tổng từng hàng. Đọc lại từ văn bản CSV bắt được những lỗi mà kiểm biến trong RAM bỏ qua, như mất số 0 đầu hay thừa cột index; khi thi, ghi ra đúng tệp sẽ nộp rồi đọc lại chính tệp đó.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProKhi đi thi
- Ghi yêu cầu của từng bài trước khi viết model: metric, tệp nộp, giới hạn thời gian, tài nguyên được dùng.
- Có bài nộp hợp lệ cho mọi bài trước khi tối ưu bài nào.
- Đo thời gian chạy ở hai kích thước để tách phần cố định khỏi phần theo số mẫu, rồi chừa khoảng đệm.
Tóm tắt
- Đọc kỹ yêu cầu của từng bài: metric, tệp nộp, runtime, tài nguyên được dùng.
- Có một đường nộp chạy được cho mọi bài trước khi cải thiện.
- Công thức chuẩn hóa cho biết một mức tăng metric đáng bao nhiêu điểm; thời gian, xác suất thành công và sự phụ thuộc giữa các bước quyết định làm gì trước. Với vài việc, duyệt hết các kế hoạch để tránh bẫy tham lam.
- Điểm public có nhiễu; chọn bản cuối bằng validation hợp lệ.
- Giữ thời gian cuối để chạy lại từ đầu và kiểm file nộp.
Kiểm tra cuối bài
Câu 1
Phần quy định chung của một kỳ thi nêu giới hạn chạy 20 phút cho mọi bài, trừ khi statement quy định khác. Statement của bài B ghi 5 phút. Notebook của đội chạy 12 phút trên một máy giống máy chấm. Kết luận thế nào?
Quy định chung đã tự ghi ngoại lệ: statement nói khác thì theo statement. 12 phút vượt 5 phút, nên bài B không đạt, dù dưới 20 phút. Runtime năm trước không phải hợp đồng của năm nay. Cách sửa là giảm phần chạy trong notebook, như nạp model đã lưu nếu luật cho phép, bớt epoch, hay bớt model trong ensemble, rồi đo lại cả notebook.
Câu 2
Đo inference trên đúng máy chấm: 500 mẫu mất 40 giây, 2000 mẫu mất 70 giây. Test có 10 000 mẫu, giới hạn 300 giây. Giả sử thời gian gồm một phần cố định cộng một phần tỉ lệ với số mẫu. Dự báo nào hợp lý?
Hai điểm đo cho độ dốc giây mỗi mẫu, và phần cố định giây. Vậy giây. Nhân tỉ lệ từ một lần đo là coi phần cố định, như khởi động hay nạp model, lặp lại theo từng nhóm mẫu, nên ra 350 hoặc 800. Trung bình hai lần đo không phải dự báo cho 10 000 mẫu. Khoảng đệm 70 giây vẫn nên được kiểm bằng một lần chạy đủ kích thước, vì bộ nhớ có thể không tăng tuyến tính.
Câu 3
Bài hồi quy chấm lỗi trung bình, càng thấp càng tốt. Điểm phần thi là , với , trong đó là lỗi của một model mà ban giám khảo giữ kín. Lỗi lớn hơn baseline thì được 0 điểm. Biết , , bài tốt nhất của thí sinh có lỗi 0.26, còn đội đạt . Đội được bao nhiêu điểm?
, nên điểm là . 75 là lấy mốc 0.26 của thí sinh mà quên model của chuyên gia. 40 là phần khoảng cách còn lại tới mốc, , không phải phần đã đi được. 0 là đọc nhầm chiều: với lỗi, nghĩa là tốt hơn baseline. Đứng đầu bảng thí sinh cũng chưa chắc được 100 điểm, vì mốc trên nằm ngoài tầm nhìn.
7 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProĐọc thêm
- IOAI 2026 - Rules & Technical Appendix, mục 2.1, 2.5-2.6 và Appendix. Đọc để phân biệt lịch thi, cách tính điểm, phản hồi và giới hạn chung của năm 2026.
- IOAI 2026 - Individual Contest. Chọn một statement để đối chiếu runtime và dạng nộp; đó là hợp đồng riêng của từng bài.
- USA-NA-AIO 2026 - đề Vòng 2, Ngày 1, các mục Submission và Final Competition Score của từng bài. Đọc để thấy một hợp đồng đầy đủ: tệp phải nộp, GPU bắt buộc, điểm tính theo baseline và bài tốt nhất.
- James và cộng sự - An Introduction to Statistical Learning with Applications in Python, chương 5. Đọc về resampling để hiểu vì sao một validation nhỏ không thể quyết định mọi thí nghiệm.
- scikit-learn 1.7 - Cross-validation. Đọc cách giữ đánh giá độc lập với chọn tham số.