Âm thanh lưu trong máy là một dãy số: biên độ sóng âm đo hàng nghìn lần mỗi giây. Nhìn dãy số đó thì rất khó biết đó là tiếng chuông hay tiếng nói. Bài này học sample rate, STFT để tìm các tần số trong từng đoạn ngắn của âm, và spectrogram, hình cho thấy tần số thay đổi theo thời gian, là dạng đầu vào thường dùng cho model âm thanh. Ta tự tạo một âm đổi cao độ giữa chừng để kiểm spectrogram có cho thấy đúng điều đó không.
Từ dao động đến dãy số
Microphone đo biến thiên áp suất theo thời gian, rồi thiết bị chuyển thành số. Waveform là dãy biên độ , trong đó là chỉ số mẫu, bắt đầu từ 0. Sample rate cho biết mỗi giây có bao nhiêu mẫu, đơn vị Hz, tức mẫu/giây. Thời điểm mẫu thứ là giây. Một file có mẫu đại diện khoảng thời gian ; mẫu cuối nằm tại , ngay trước đầu khoảng tiếp theo.
Đoạn 3 giây ở 16 000 Hz một kênh có 48 000 mẫu; lưu 16 bit mỗi mẫu thì mỗi giây tốn 32 000 byte. Âm cao hơn nghĩa là dao động có tần số lớn hơn; tai người nghe được khoảng từ 20 Hz đến 20 000 Hz.
Biên độ float là số tương đối, không phải áp suất đo bằng pascal. WAV PCM 16-bit lưu số nguyên từ đến ; chia cho để đưa về khoảng , nếu quên thì biên độ lớn gấp hàng chục nghìn lần.
File stereo có hai kênh, đọc ra mảng (N, 2) hoặc (2, N) tùy thư viện; thời lượng tính theo trục mẫu, không theo tổng số phần tử. Lấy trung bình hai kênh là một cách downmix, nhưng hai kênh trái pha sẽ triệt tiêu nhau.
Ta dùng Hz, một giây gồm 2000 mẫu. Nửa đầu là sine 200 Hz, nửa sau là sine 600 Hz, nên ta biết trước một biểu diễn đúng phải cho thấy gì: 200 Hz trong nửa giây đầu, 600 Hz trong nửa giây sau. Biên độ 0.7 và 0.4 giúp phân biệt thêm độ mạnh của hai đoạn.
import numpy as np

sample_rate = 2000
num_samples = 2000
time = np.arange(num_samples) / sample_rate
waveform = np.where(
    time < 0.5,
    0.7 * np.sin(2 * np.pi * 200 * time),
    0.4 * np.sin(2 * np.pi * 600 * time),
)
duration = len(waveform) / sample_rate
interval_ms = 1000 / sample_rate
print(waveform.shape)
print(f"thời lượng = {duration:.3f} s")
print(f"khoảng mẫu = {interval_ms:.3f} ms")
(2000,)
thời lượng = 1.000 s
khoảng mẫu = 0.500 ms
Mỗi mẫu cách nhau 0.5 ms. Một chu kỳ 200 Hz dài giây, nên có 10 mẫu trong một chu kỳ; với 600 Hz chỉ khoảng 3.33 mẫu. Hình dưới phóng to 20 ms, vì vẽ cả một giây thì đường dao động rất khó đọc.
Hỏi nhanh
File WAV stereo 16 kHz được đọc thành mảng shape (48000, 2), tức 48 000 mẫu cho mỗi kênh. File dài bao nhiêu giây?
Thời lượng tính theo trục mẫu: giây. 6 giây là chia tổng 96 000 phần tử cho sample rate, như thể hai kênh là hai đoạn nối tiếp nhau. 1.5 giây là chia thêm cho số kênh. là lấy nhầm trục kênh làm trục thời gian, lỗi hay gặp khi thư viện trả về (2, N) còn code lại giả định (N, 2).
Hỏi nhanh
Microphone phải của một bản ghi stereo bị đấu ngược cực, nên kênh phải đúng bằng kênh trái đổi dấu. Downmix bằng cách lấy trung bình hai kênh thì được gì?
Tại mọi mẫu, . Bản mono thành im lặng, dù từng kênh vẫn có âm. Trung bình chỉ giữ dạng sóng khi hai kênh gần cùng pha. Gấp đôi là cộng lại mà quên dấu trừ. Hai kênh có biên độ bằng nhau, nên không kênh nào át kênh nào. Trước khi downmix, hãy so năng lượng của bản mono với từng kênh. Đôi khi chỉ cần giữ một kênh là đủ.
Vì sao không lấy mẫu thưa tùy ý?
Hai dao động liên tục khác nhau có thể đi qua đúng những chấm lấy mẫu giống nhau. Khi đó thuật toán nhận các chấm không thể biết dao động gốc là cái nào. Hiện tượng này là aliasing (chồng phổ).
Để phục hồi một tín hiệu lý tưởng chỉ có tần số dưới , ta cần . Mốc gọi là tần số Nyquist; ngay tại mốc ấy, một sine có pha đặc biệt còn có thể cho toàn số 0. Trong thiết bị thật, cần bộ lọc và khoảng chuyển tiếp, nên không thiết kế sát biên.
Thông tin quan trọng của giọng nói nằm dưới khoảng 8 kHz, nên 16 kHz là đủ; vì vậy nhiều model tiếng nói học ở 16 kHz, và file 44.1 kHz phải được resample về đúng 16 kHz trước khi đưa vào.
Với Hz, cosine 350 Hz và cosine 650 Hz cho cùng dãy số: . Ta kiểm trên 20 mẫu; cosine được chọn để hai dãy giống nhau trực tiếp, không cần đổi dấu.
alias_rate = 1000
sample_index = np.arange(20)
low_tone = np.cos(2 * np.pi * 350 * sample_index / alias_rate)
high_tone = np.cos(2 * np.pi * 650 * sample_index / alias_rate)
print(np.allclose(low_tone, high_tone))
True
Kết quả True có nghĩa là dữ liệu đầu vào đã mất khả năng phân biệt hai tần số; model mạnh hơn cũng không lấy lại được thông tin bị bỏ từ trước. Tổng quát, một thành phần nằm giữa và hiện ra ở , như thể bị gập qua mốc Nyquist.
Lỗi này dễ gặp nhất khi giảm sample rate. Lấy một mẫu trong hai (waveform[::2]) đưa tín hiệu về 1000 Hz, Nyquist mới là 500 Hz, nên đoạn 600 Hz của ta sẽ hiện ra ở Hz. resample_poly của SciPy lọc thông thấp (low-pass) trước khi giữ ít mẫu hơn. Ta so biên độ tại 400 Hz trong nửa sau của hai kết quả, nơi bản gốc chỉ có 600 Hz:
from scipy.signal import resample_poly

half_rate = sample_rate // 2
naive = waveform[::2]
filtered = resample_poly(waveform, up=1, down=2)
for name, signal in [("bỏ mẫu", naive), ("có lọc", filtered)]:
    tail = signal[len(signal) // 2:]
    amplitude = np.abs(np.fft.rfft(tail)) * 2 / len(tail)
    freqs = np.fft.rfftfreq(len(tail), d=1 / half_rate)
    print(f"{name}: {len(signal)} mẫu, biên độ ở 400 Hz = {amplitude[freqs == 400][0]:.3f}")
bỏ mẫu: 1000 mẫu, biên độ ở 400 Hz = 0.400
có lọc: 1000 mẫu, biên độ ở 400 Hz = 0.000
Hai kết quả cùng có 1000 mẫu. Bản bỏ mẫu chứa một âm 400 Hz biên độ 0.4, đúng bằng biên độ của đoạn 600 Hz, dù bản ghi không hề có âm 400 Hz. Bản có lọc mất đoạn 600 Hz, vì 1000 Hz không giữ được nó, nhưng không bịa ra âm mới; đoạn 200 Hz nằm dưới Nyquist mới nên được giữ. Mất một dải tần là điều phải chấp nhận khi giảm sample rate; âm giả trộn vào dải còn lại thì không.
Đổi sample rate trong biến hoặc header không phải resample. Nếu gắn nhãn 4000 Hz cho mảng 2000 mẫu, phần mềm phát nó trong 0.5 giây, nhanh và cao hơn. Muốn giữ đúng một giây ở 4000 Hz, phải tạo 4000 mẫu mới:
new_rate = 4000
resampled = resample_poly(waveform, up=2, down=1)
print(f"đổi metadata: {len(waveform) / new_rate:.3f} s")
print(f"resample: {len(resampled) / new_rate:.3f} s")
đổi metadata: 0.500 s
resample: 1.000 s
Dòng đầu đổi ý nghĩa của trục thời gian; dòng sau chỉ đổi mật độ mẫu. Ở 4000 Hz, mảng mới biểu diễn được tới 2000 Hz, nhưng upsampling không bổ sung âm cao mà bản ghi cũ chưa từng có: dải 1000-2000 Hz của bản mới gần như trống.
Hỏi nhanh
Thu âm ở 8000 Hz mà không có bộ lọc chống aliasing, trong khi trong phòng có tiếng rít 5000 Hz. Trên spectrogram của bản ghi, tiếng rít hiện ra ở đâu?
5000 nằm giữa và , nên hiện ra ở Hz, và trộn lẫn với âm thật cùng tần số. Trục tần số của bản ghi chỉ tới 4000 Hz, nên không thể có 5000 Hz. 1000 Hz là lấy , tức gập sai mốc. “Không thấy” chỉ đúng khi có bộ lọc trước lúc lấy mẫu.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProSTFT: xem những tần số nào xuất hiện ở từng lúc
FFT biến một đoạn waveform thành các hệ số theo tần số. Nếu FFT toàn một giây, ta thấy cả 200 Hz và 600 Hz nhưng không biết chúng xuất hiện trước hay sau. Short-time Fourier transform (STFT) khắc phục bằng cách lấy từng frame ngắn, FFT từng frame, rồi xếp kết quả theo thời gian.
Ta chọn độ dài cửa sổ (window length) mẫu, tức 100 ms; bước nhảy (hop) mẫu, tức sau 50 ms lại bắt đầu frame mới. Frame liền nhau chồng lấp 100 mẫu. Không padding thì số frame là .
Hop điều khiển mật độ cột thời gian; window length mới là độ dài tín hiệu được dùng để tính mỗi cột. Với tiếng nói ở 16 kHz, cấu hình hay gặp là window 25 ms (400 mẫu) và hop 10 ms (160 mẫu).
Nhiều thư viện mặc định center=True: đệm mẫu ở mỗi đầu để frame có tâm tại mẫu , khi đó . Hai quy ước lệch nhau vài frame, đủ làm sai shape khi ghép với nhãn theo thời gian.
Trước FFT, nhân frame với một cửa sổ (window). Hann window làm hai đầu nhỏ dần, giảm gián đoạn giả khi FFT coi đoạn tín hiệu được lặp lại. Ta dùng bản Hann tuần hoàn , . Đổi window làm thay đổi độ rộng đỉnh phổ, nên không thể xem nó là trang trí. Mỗi hệ số STFT là
là frame, là bin tần số, trong số mũ là đơn vị ảo. Công thức chỉ là tổng các mẫu sau khi cân trọng số, so với những dao động chuẩn. Chưa cần tự tính số phức; rfft tính phần tần số không âm cho tín hiệu thực.
Với , có bin, từ 0 đến 1000 Hz, cách nhau Hz. Đó là khoảng cách bin; khả năng tách hai đỉnh còn phụ thuộc window và độ dài đoạn, không chỉ bước trên trục. Ở 16 kHz với FFT 512 mẫu, các bin cách nhau Hz; cấu hình 25 ms, 10 ms trên 1 giây cho frame.
from scipy.signal.windows import hann
from numpy.lib.stride_tricks import sliding_window_view

def stft_power(signal, rate, window_size=200, hop=100):
    frames = sliding_window_view(signal, window_size)[::hop]
    window = hann(window_size, sym=False)
    spectrum = np.fft.rfft(frames * window, axis=1)
    power = (np.abs(spectrum) / window.sum()) ** 2
    frequencies = np.fft.rfftfreq(window_size, d=1 / rate)
    centers = (np.arange(len(frames)) * hop + window_size / 2) / rate
    return power.T, frequencies, centers

power, frequencies, centers = stft_power(waveform, sample_rate)
print(power.shape)
peaks = np.argmax(power[:, [0, -1]], axis=0)
print(frequencies[peaks])
print(centers[[0, -1]].round(2))
(101, 19)
[200. 600.]
[0.05 0.95]
Ma trận có shape (101, 19): hàng là tần số, cột là thời gian. Hai đỉnh ở frame đầu và cuối phải là 200 và 600 Hz; nếu đổi hai trục mà vẫn gán nhãn như cũ, hình sẽ sai dù code vẽ không báo lỗi. Ta chia biên độ phổ cho tổng window để thang số dễ đọc, rồi bình phương. power ở đây là bình phương biên độ tương đối, không phải mật độ phổ công suất có đơn vị watt/Hz.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản Pro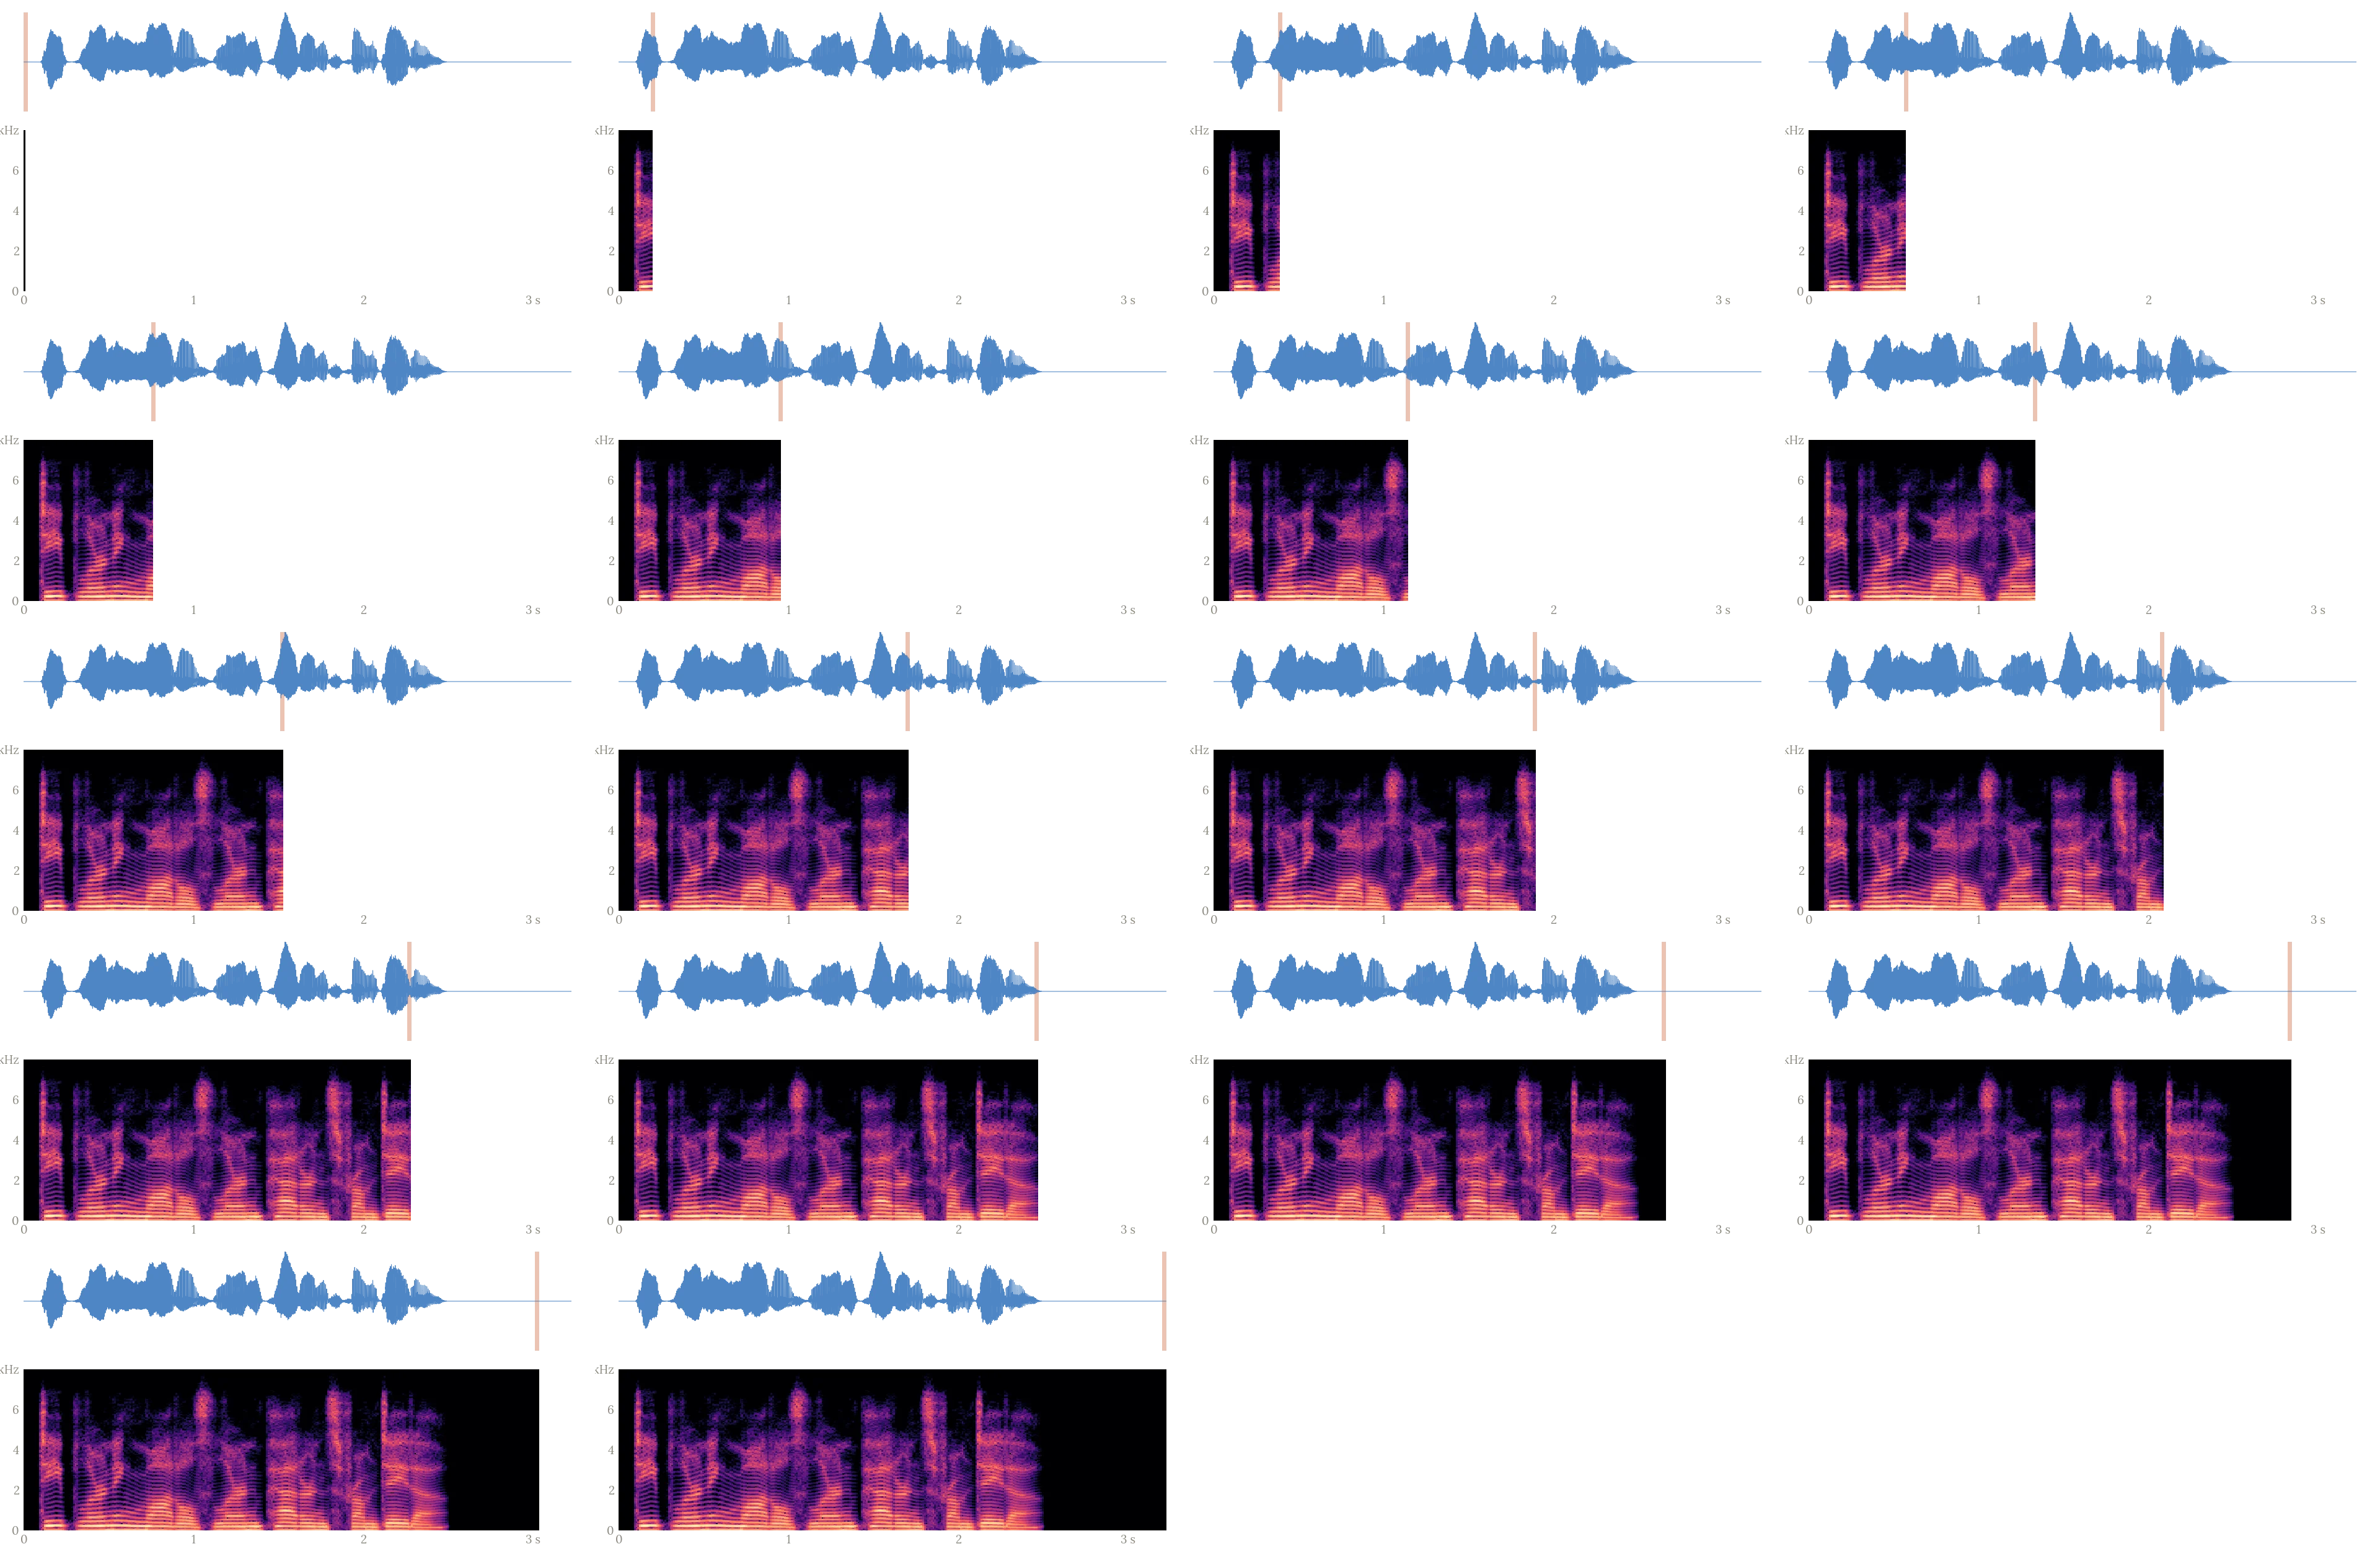
Window dài cho nhiều chu kỳ hơn để phân biệt tần số gần nhau, nhưng gộp thay đổi trong thời gian dài hơn. Window ngắn định vị tiếng gõ nhanh hơn, nhưng các đỉnh tần số rộng hơn. Tiếng Việt có thanh điệu: cùng một âm tiết, đường cao độ khác nhau là từ khác nhau, nên model nhận dạng phải giữ được thông tin cao độ.
Zero-padding trước FFT tăng số điểm vẽ trên trục tần số, không tăng thời gian quan sát và không tự tách hai âm quá gần. ShortTimeFFT của SciPy là lựa chọn thư viện cho quy trình có STFT/ISTFT; khi đối chiếu, phải khớp window, padding, tâm frame và scaling.
2 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProMel và log-mel: gộp vùng tần số, nén thang số
Một spectrogram có hàng trăm bin; ta có thể gộp chúng bằng các bộ lọc tam giác. Mel filter bank đặt các bộ lọc trên một thang tần số gần với cách nghe cao độ, thay vì đều theo Hz. Có nhiều quy ước mel; bài này chọn công thức HTK
có đơn vị Hz, là tọa độ mel. Ta đặt 22 điểm đều theo mel, đổi lại sang Hz, tạo 20 tam giác giữa từng bộ ba điểm. Mel band ở frame là . có shape (20, 101), nên phép nhân cho (20, 19). Model tiếng nói thường dùng 80 hoặc 128 band trên dải tới 8 kHz; bài dùng 20 band vì trục chỉ tới 1000 Hz.
Tam giác trong bài có đỉnh bằng 1, không chuẩn hóa diện tích; kết quả không nhất thiết bằng mặc định Slaney của librosa. Tài liệu mel của librosa giải thích khác biệt này.
def mel_filter_bank(frequency_grid, num_bands):
    max_mel = 2595 * np.log10(1 + frequency_grid[-1] / 700)
    mel_edges = np.linspace(0, max_mel, num_bands + 2)
    hz_edges = 700 * (10 ** (mel_edges / 2595) - 1)
    filters = np.zeros((num_bands, len(frequency_grid)))
    for band in range(num_bands):
        left, middle, right = hz_edges[band:band + 3]
        rising = (frequency_grid - left) / (middle - left)
        falling = (right - frequency_grid) / (right - middle)
        filters[band] = np.maximum(0, np.minimum(rising, falling))
    return filters

filters = mel_filter_bank(frequencies, num_bands=20)
mel_power = filters @ power
reference_power = max(float(mel_power.max()), 1e-12)
log_mel = 10 * np.log10(np.maximum(mel_power, 1e-12) / reference_power)
print(filters.shape, log_mel.shape)
print(np.round([log_mel.min(), log_mel.max()], 1))
print(np.isfinite(log_mel).all())
(20, 101) (20, 19)
[-112.1 0. ]
True
Log làm các vùng yếu dễ nhìn hơn và giảm chênh lệch thang số. Ta dùng vì là đại lượng bình phương biên độ; nếu lấy log của biên độ trực tiếp thì dùng hệ số 20. Mốc của hình là mel power lớn nhất của chính clip này, nên 0 dB nghĩa là ngang đỉnh clip, không phải mức âm thanh tuyệt đối. Chặn dưới trước log tránh -inf ở im lặng. Pretrained model có thể dùng log tự nhiên, dải động hay mốc khác; phải dùng processor của nó, không thay bằng công thức này rồi giữ nguyên tên.
MFCC, đặc trưng kinh điển của tiếng nói, đi thêm một bước: lấy log-mel rồi biến đổi cosine rời rạc (DCT) và giữ khoảng 13 hệ số đầu, những hệ số tóm hình dạng của phổ. Nhiều model học sâu ngày nay dùng thẳng log-mel.
2 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProTính thử một band: ba bin có power , bộ lọc tam giác có trọng số . Power sau gộp là . Nếu mốc power là 5 thì band này bằng dB; band khác có power 0.5 thì bằng dB. Đây là tỉ số power, không phải “âm lượng giảm 10 lần” theo cảm giác nghe.
Chuẩn hóa waveform và file im lặng
Peak normalization chia cho biên độ lớn nhất để clip vừa một dải số; RMS đo mức dao động điển hình, .
Chuẩn hóa mỗi clip có thể xóa thông tin âm lượng hữu ích. Một máy đang chạy yếu và một máy chạy mạnh có thể khác chính ở mức dao động ấy. Ta thử peak normalization, kèm bảo vệ file im lặng:
def peak_normalize(signal):
    peak = float(np.max(np.abs(signal)))
    return signal / max(peak, 1e-8)

tiny_wave = np.array([0.0, 0.2, -0.4, 0.2])
normalized = peak_normalize(tiny_wave)
print(normalized.round(2))
print(peak_normalize(np.zeros(4)))
print(f"RMS trước = {np.sqrt(np.mean(tiny_wave ** 2)):.3f}")
[ 0. 0.5 -1. 0.5]
[0. 0. 0. 0.]
RMS trước = 0.245
Ta được ; RMS trước bằng . File im lặng giữ toàn 0. Chuẩn hóa đặc trưng bằng mean/std của tập train ở bài 7.2 có mục đích khác: làm thang đầu vào của bộ phân loại ổn định. Hai thao tác không thay thế nhau.
Câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProAugmentation
Nếu nhãn là “tiếng chuông”, giảm âm lượng vừa phải có thể giữ nhãn, nhưng thêm nhiễu quá lớn khiến chuông không còn nghe được. Nếu nhãn là cao độ nốt nhạc, pitch shift làm thay đổi nhãn. Nếu nhãn là câu nói, crop mất từ sẽ làm transcript cũ không còn đúng. Phải hỏi “sau biến đổi, đáp án có còn là đáp án cũ?” trước khi chọn phép biến đổi.
Trộn tiếng ồn quán cà phê vào bản ghi sạch dạy model bền với môi trường ồn. Phát nhanh 1.1 lần giúp model quen người nói nhanh, nhưng cũng làm giọng cao lên, nên chỉ hợp khi nhãn không phụ thuộc cao độ.
Time masking và frequency masking trên log-mel là hai thành phần của SpecAugment. Chúng che một vùng biểu diễn trong lúc train, để mô hình bớt lệ thuộc vào một mảnh nhỏ. Mức che phải vừa với thời lượng và nhiệm vụ; không áp ngẫu nhiên vào validation.
Nếu đầu vào đã chuẩn hóa về mean 0, điền 0 là điền giá trị trung bình, còn trên thang dB tương đối 0 là đỉnh clip. Cùng một dòng array[...] = 0 có thể mang hai nghĩa rất khác.
2 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProKhi đi thi
- Đọc header của mọi file trước model đầu tiên: sample rate, số kênh, thời lượng; đếm clip hỏng và clip im lặng.
- Dùng checkpoint thì resample về đúng sample rate của nó và dùng processor đi kèm.
- Chia theo bản ghi gốc trước khi cắt đoạn.
Tóm tắt
- Waveform cần đi cùng sample rate: . Aliasing xảy ra trước mô hình; giảm sample rate phải lọc trước, tăng sample rate không thêm âm cao.
- STFT cắt frame, nhân window rồi FFT. Window và hop trả lời hai câu hỏi khác nhau về thời gian.
- Spectrogram giữ thời gian và tần số; mel gộp tần số, log nén thang power. Quy ước và mốc log phải được ghi rõ.
- Chuẩn hóa và augmentation cần giữ thông tin liên quan đến nhãn, có bảo vệ im lặng và có cấu hình tái lập.
Kiểm tra cuối bài
Câu 1
Đề phân loại tiếng chim, và nhiều loài chỉ khác nhau ở các nốt 9-11 kHz. Dữ liệu ghi ở 44.1 kHz, còn checkpoint audio có sẵn nhận 16 kHz. Resample đúng chuẩn về 16 kHz rồi fine-tune thì sao?
Ở 16 kHz, Nyquist là 8 kHz. Resample đúng chuẩn lọc bỏ mọi thứ trên khoảng 8 kHz, nên bằng chứng phân biệt loài biến mất trước khi vào model. Chỉ khi bỏ mẫu mà không lọc, dải 9-11 kHz mới gập về 5-7 kHz, và khi đó nó trộn với âm thật ở dải ấy. Upsample sau đó không tạo lại được thứ đã bị lọc. Hướng hợp lý là tự tính log-mel ở 32 kHz hoặc 44.1 kHz cho một model riêng, hoặc dùng checkpoint train ở sample rate cao, rồi so trên validation với baseline 16 kHz.
Câu 2
Một tập dữ liệu trộn bản ghi điện thoại 8 kHz với bản ghi studio 44.1 kHz, còn checkpoint nhận 16 kHz. Đưa hai nguồn về 16 kHz thế nào cho đúng?
Downsampling giảm số mẫu, và phải lọc thông thấp trước, nếu không âm trên 8 kHz sẽ gập vào dải còn lại. Hơn nữa, Hz, không phải 16 kHz. Upsampling chỉ làm mảng khớp với đầu vào mà model cần. Bản ghi 8 kHz chưa từng chứa gì trên 4 kHz, nên dải ấy vẫn trống. Vì hai nguồn khác dải tần, nên xem riêng điểm validation theo từng nguồn.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.3
Câu 3
Clip 1 giây ở 16 kHz, window 400 mẫu, hop 160 mẫu. Số frame STFT khi không padding, và khi center=True, tức đệm 200 mẫu mỗi đầu, lần lượt là bao nhiêu?
Số vị trí của một cửa sổ trượt là , đúng công thức của convolution một chiều với kernel , stride và padding . Không padding thì được . Với thì được , và torch.stft với center=True cho đúng shape (201, 101). 97 là quên cộng 1. 100 là lấy mà quên frame đầu. Khi ghép nhãn theo frame, lệch ba frame giữa hai quy ước cũng đủ làm sai shape.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.2(b)
7 câu hỏi nhanh dành cho tài khoản Pro
Mở khóa bằng tài khoản ProĐọc thêm
- Julius O. Smith - Spectral Audio Signal Processing. Đọc các mục DFT, window và STFT để hiểu vì sao độ dài frame và hình cửa sổ ảnh hưởng phổ.
- SciPy -
ShortTimeFFTvàresample_poly. Tra hợp đồng trục, scaling và low-pass filter khi dùng thư viện. - librosa - mel frequencies. Đối chiếu HTK và Slaney trước khi so hai log-mel.
- Park và cộng sự - SpecAugment. Đọc cách che theo thời gian và theo tần số trên đặc trưng; chọn mức che theo nhiệm vụ cụ thể.