Nếu biết đầy đủ bản đồ và thời gian đi từng đoạn hành lang, robot ở bài trước không cần học: chỉ cần tìm đường như trong lập trình thi đấu. Bài này học ba loại bài toán tìm kiếm và suy luận trong AI: tìm đường rẻ nhất (A*), chơi trò chơi có đối thủ (minimax), và kiểm một kết luận có chắc chắn đúng từ các điều kiện đã biết (CSP, logic mệnh đề). Đây cũng là AI, dù không học từ dữ liệu.
Trạng thái đúng trước, thuật toán sau
Một bài toán tìm kiếm có trạng thái đầu, các hành động hợp lệ, quy tắc sinh trạng thái mới, phép kiểm đích và chi phí.
Nếu hai lịch sử tới cùng vị trí dẫn tới khả năng hành động giống nhau, vị trí có thể làm trạng thái. Nếu robot phải nhặt chìa khóa mới mở được cửa, cần thêm thông tin đã có chìa hay chưa. Đánh dấu visited[position] lúc ấy sẽ gộp hai tình huống khác nhau và có thể xóa mất đáp án.
Đồ thị của ta có bốn đỉnh. Từ S có thể tới B với giá 1 hoặc A với giá 2; từ B tới G giá 10, từ A tới G giá 2. Cạnh có hướng, chi phí tính bằng giây, mọi chi phí dương.
BFS mở rộng theo số cạnh nên tối ưu khi mọi cạnh có cùng chi phí. Dijkstra mở rộng theo chi phí đã đi và cần cạnh không âm. A* thêm một ước lượng chi phí còn lại , mở rộng theo
Ở đây , , đều có đơn vị giây. Cộng số bước với số giây không có nghĩa nếu chưa quy đổi. Greedy best-first search chỉ dùng ; nó có thể lao tới một đỉnh trông gần đích dù đã đi qua đoạn rất đắt. A* giữ cả chi phí đã trả.
Ta để B đứng trước A trong danh sách cạnh. Hai đường đều có 2 cạnh, nên BFS trả đường qua B; đây là lời giải ít cạnh nhất nhưng không ít giây nhất. Code dưới đây cài BFS trên đúng đồ thị này rồi tính số giây của đường nó trả về.
from collections import deque
import heapq
import math

graph = {
    "S": [("B", 1), ("A", 2)],
    "A": [("G", 2)],
    "B": [("G", 10)],
    "G": [],
}

def path_cost(path):
    total = 0
    for source, target in zip(path, path[1:]):
        total += next(cost for node, cost in graph[source] if node == target)
    return total

def bfs_path(source, target):
    queue = deque([[source]])
    seen = {source}
    while queue:
        path = queue.popleft()
        if path[-1] == target:
            return path
        for node, _ in graph[path[-1]]:
            if node not in seen:
                seen.add(node)
                queue.append(path + [node])
    return None

bfs_answer = bfs_path("S", "G")
print("BFS:", bfs_answer, "chi phí:", path_cost(bfs_answer))
BFS: ['S', 'B', 'G'] chi phí: 11
Đường dài 11 giây không phải lỗi của BFS; ta đã hỏi nó sai đại lượng. Nếu mọi cạnh là 1 giây thì tối thiểu số cạnh cũng là tối thiểu thời gian.
Hỏi nhanh
Robot tới cùng một ô hai lần: một lần đã nhặt chìa khóa, một lần chưa. Có nên gộp hai lần đó thành một trạng thái không?
Trạng thái phải giữ đủ thông tin để quyết định các bước hợp lệ về sau: có chìa thì qua được cửa, chưa có thì không. Đổi thuật toán không chữa được một mô hình trạng thái thiếu thông tin. Ngược lại, tách mọi lịch sử thành trạng thái riêng làm số trạng thái bùng nổ. Hai lần tới cùng ô với cùng tình trạng chìa khóa thì vẫn gộp được.
Hỏi nhanh
Đồ thị có cạnh 1 giây và cạnh 2 giây. Một bạn muốn giữ BFS. Sửa thế nào để BFS cho ra đúng đường ít giây nhất?
Sau khi tách, mọi cạnh có cùng giá, nên số cạnh bằng số giây, và BFS cho đường tối ưu. Cộng đúng chi phí khi in không đổi được đường mà BFS đã chọn. Thứ tự danh sách kề chỉ đổi cách phá hòa giữa các đường có cùng số cạnh. Ở ví dụ, cạnh 1 giây từ S tới B đã đứng trước mà BFS vẫn trả về đường 11 giây. Đổi thời điểm đánh dấu thì vẫn mở theo số cạnh. Khi chi phí cạnh có nhiều giá trị khác nhau, dùng Dijkstra gọn hơn tách cạnh.
DFS và IDS: khi bộ nhớ là giới hạn
BFS lấy nút ra từ hàng đợi (queue) nên mở theo từng tầng. DFS lấy từ ngăn xếp (stack), đi hết một nhánh rồi mới quay lui. Hai cách khác nhau ở thứ tự mở, kéo theo khác nhau về bộ nhớ và về chất lượng lời giải.
Trên cây có hệ số nhánh và lời giải nông nhất ở độ sâu , BFS phải giữ cả tầng biên, cỡ nút. DFS chỉ giữ đường đi từ gốc cùng các nút anh em chưa mở dọc đường đó, cỡ với là độ sâu lớn nhất. Với , , BFS có thể phải giữ nút, còn DFS chỉ vài chục.
Đổi lại, DFS không tối ưu: nó có thể lao xuống một nhánh sâu và mất rất lâu mới quay sang nhánh có đích nông. Trên đồ thị hữu hạn có đánh dấu đã thăm, DFS vẫn tìm được đích; trên đồ thị vô hạn, hay khi không đánh dấu mà đồ thị có vòng, nó có thể đi mãi.
Iterative deepening search (IDS) lấy ưu điểm của cả hai: chạy DFS với giới hạn độ sâu 0, 1, 2, … cho tới khi gặp đích. Bộ nhớ như DFS. Vì giới hạn tăng từng bậc nên đích được gặp ở tầng nông nhất, như BFS. Các tầng trên bị mở lại nhiều lần, nhưng tầng cuối chiếm phần lớn số nút, nên tổng công chỉ hơn BFS một hằng số. Còn uniform-cost search (UCS) trong sách AI chính là Dijkstra: mở nút có nhỏ nhất.
Ta đo trên cây đầy đủ có 3 nhánh mỗi nút, sâu 6, đếm số nút được lấy ra và số nút lớn nhất phải giữ cùng lúc. Một đích nằm ở lá phải cùng, một đích nằm ở độ sâu 2.
BRANCH, DEPTH = 3, 6

def children(node):
    return [] if len(node) == DEPTH else [node + (k,) for k in range(BRANCH)]

def bfs_count(goal):
    queue, peak, opened = deque([()]), 1, 0
    while queue:
        node = queue.popleft()
        opened += 1
        if node == goal:
            return opened, peak
        queue.extend(children(node))
        peak = max(peak, len(queue))

def dfs_count(goal):
    stack, peak, opened = [()], 1, 0
    while stack:
        node = stack.pop()
        opened += 1
        if node == goal:
            return opened, peak
        stack.extend(reversed(children(node)))
        peak = max(peak, len(stack))

def ids_count(goal):
    opened, peak = 0, 1
    for limit in range(DEPTH + 1):
        stack = [()]
        while stack:
            node = stack.pop()
            opened += 1
            if node == goal:
                return opened, peak
            if len(node) < limit:
                stack.extend(reversed(children(node)))
                peak = max(peak, len(stack))

for goal in [(2,) * DEPTH, (1, 0)]:
    print(f"đích {goal}:", end="")
    for name, search in [("BFS", bfs_count), ("DFS", dfs_count), ("IDS", ids_count)]:
        opened, peak = search(goal)
        print(f"  {name} mở {opened}, giữ {peak}", end="")
    print()
đích (2, 2, 2, 2, 2, 2): BFS mở 1093, giữ 729 DFS mở 1093, giữ 13 IDS mở 1636, giữ 13
đích (1, 0): BFS mở 8, giữ 15 DFS mở 367, giữ 13 IDS mở 12, giữ 5
Với đích ở lá cuối, cả BFS và DFS đều mở hết 1093 nút, nhưng BFS phải giữ cả tầng lá, 729 nút, còn DFS chỉ giữ 13. Với đích nông, DFS lạc vào nhánh 0 và mở 367 nút trước khi quay sang, còn BFS chỉ mở 8. IDS mở nhiều hơn BFS khoảng một nửa ở ca đầu, nhưng ở cả hai ca chỉ giữ ít nút như DFS.
Hỏi nhanh
Cây có hệ số nhánh , đích nông nhất ở độ sâu , cây sâu tới , máy chỉ đủ bộ nhớ cho vài nghìn nút. Cần tìm đường ít cạnh nhất. Nên dùng gì?
BFS cho đường ít cạnh nhất, nhưng biên ở độ sâu 6 có tới nút, không vừa bộ nhớ. DFS vừa bộ nhớ nhưng có thể trả về một đích ở sâu 20 trước. IDS thử lần lượt giới hạn 0, 1, …, 6, nên gặp đích ở độ sâu 6 trước mọi đích sâu hơn, mà mỗi lần chạy chỉ giữ cỡ nút. DFS giới hạn 20 vẫn là DFS, chưa chắc ra đích nông nhất.
A*: cần một lời hứa về heuristic
A* ưu tiên mở đỉnh có nhỏ nhất, với là chi phí đã đi và là ước lượng chi phí còn lại (heuristic). Heuristic gọi là admissible (chấp nhận được) khi không ước lượng quá chi phí thật nhỏ nhất còn lại: , với .
Trên đồ thị này, ta chọn , , , . Đó chính là chi phí còn lại thật nên chắc chắn admissible. Ở bài lớn, biết ngay thường khó ngang bài gốc; heuristic hữu ích phải tính rẻ hơn.
Ví dụ quen thuộc là khoảng cách Manhattan trên lưới chỉ đi bốn hướng, mỗi bước tốn ít nhất một đơn vị, không có dịch chuyển tức thời. Bỏ tường làm bài dễ hơn; đường ngắn nhất khi bỏ tường không thể đắt hơn đường có tường. Vì vậy khoảng cách ấy là một cận dưới (lower bound).
Nếu đề có cạnh dịch chuyển hoặc bước đường chéo giá rẻ, chứng minh này phải xem lại.
Hỏi nhanh
Robot đi được 8 hướng như quân vua, mỗi bước, kể cả bước chéo, tốn 1 giây, và không có tường. Heuristic nào vừa admissible vừa sát nhất?
Tới ô lệch chỉ cần 3 bước chéo. Manhattan cho 6, Euclid cho , đều vượt chi phí thật, nên không admissible. Mỗi bước giảm và đi nhiều nhất 1, nên cần ít nhất bước, và không có tường thì đúng bằng số đó. cũng là một lower bound, nhưng yếu hơn, nên A* phải mở thêm đỉnh.
Một điều kiện mạnh hơn là consistency:
Heuristic consistent (nhất quán) làm không giảm dọc đường; khi đó A* có thể đóng một trạng thái ngay sau lần đầu lấy nó ra khỏi heap. Nếu chỉ có admissibility, ta phải cho phép mở lại trạng thái khi tìm được nhỏ hơn. Code dưới đây không dùng một tập closed khóa vĩnh viễn, nên vẫn xử lý cập nhật đó.
Tính tay tại S: , . Sau khi mở S, A có , ; B có , . A được lấy ra trước, sinh G với , . G tiếp theo được lấy ra, cho đường 4 giây. Chỉ dừng khi lấy đích ra khỏi heap, không dừng ngay khi một cạnh đầu tiên sinh được đích.
def astar(source, target, heuristic):
    best_cost = {source: 0}
    parent = {source: None}
    heap = [(heuristic[source], 0, source)]
    expanded = []
    while heap:
        _, cost, node = heapq.heappop(heap)
        if cost != best_cost[node]:       # bỏ mục heap đã lỗi thời
            continue
        expanded.append(node)
        if node == target:
            path = []
            while node is not None:
                path.append(node)
                node = parent[node]
            return cost, path[::-1], expanded
        for next_node, edge_cost in graph[node]:
            assert edge_cost >= 0
            candidate = cost + edge_cost
            if candidate < best_cost.get(next_node, math.inf):
                best_cost[next_node] = candidate
                parent[next_node] = node
                priority = candidate + heuristic[next_node]
                heapq.heappush(heap, (priority, candidate, next_node))
    return math.inf, None, expanded

h_good = {"S": 4, "A": 2, "B": 10, "G": 0}
h_zero = {node: 0 for node in graph}
h_bad = {"S": 0, "A": 100, "B": 0, "G": 0}
for name, heuristic in [("Dijkstra", h_zero), ("A*", h_good), ("A* h sai", h_bad)]:
    cost, path, expanded = astar("S", "G", heuristic)
    print(f"{name}: cost={cost}, path={path}, mở={expanded}")
Dijkstra: cost=4, path=['S', 'A', 'G'], mở=['S', 'B', 'A', 'G']
A*: cost=4, path=['S', 'A', 'G'], mở=['S', 'A', 'G']
A* h sai: cost=11, path=['S', 'B', 'G'], mở=['S', 'B', 'G']
Dijkstra là A với . Heuristic đúng giúp tránh mở B trong ví dụ này. Heuristic sai gán 100 cho A, khiến đường qua A bị trì hoãn; G qua B được lấy ra với chi phí 11 và thuật toán dừng. Không được suy ra A luôn nhanh hơn Dijkstra: heuristic tốn thời gian, có thể yếu, và nhiều đỉnh có cùng làm thứ tự phá hòa ảnh hưởng số lần mở.
Vì đồ thị hữu hạn và cạnh dương, một đường ngắn nhất không cần lặp đỉnh. Ta viết oracle vét cạn mọi đường đơn. Nó chậm trên đồ thị lớn nhưng độc lập với heap và heuristic, thích hợp để kiểm ví dụ nhỏ như code trâu trong CP.
def exhaustive_cost(source, target, seen=None):
    seen = {source} if seen is None else seen
    if source == target:
        return 0
    candidates = []
    for node, cost in graph[source]:
        if node not in seen:
            tail = exhaustive_cost(node, target, seen | {node})
            candidates.append(cost + tail)
    return min(candidates, default=math.inf)

truth = {node: exhaustive_cost(node, "G") for node in graph}
assert all(0 <= h_good[node] <= truth[node] for node in graph)
assert all(h_good[u] <= cost + h_good[v] for u in graph for v, cost in graph[u])
assert astar("S", "G", h_good)[0] == truth["S"] == 4
violations = [node for node in graph if h_bad[node] > truth[node]]
print("Chi phí còn lại thật:", truth)
print("Heuristic sai vượt lower bound tại:", violations)
Chi phí còn lại thật: {'S': 4, 'A': 2, 'B': 10, 'G': 0}
Heuristic sai vượt lower bound tại: ['A']
Nhìn danh sách vi phạm: A là bằng chứng cụ thể mất admissibility. Trên bài lớn, kiểm một ít mẫu không thay thế được chứng minh lower bound cho mọi trạng thái. Trong phạm vi đồ thị nhỏ này, ta đã kiểm đủ các đỉnh và cạnh.
Hỏi nhanh
Sửa bản Dijkstra, tức , của bài để dừng ngay khi sinh ra G, thay vì khi lấy G ra khỏi heap. Trên đồ thị S, A, B, G, nó trả về chi phí bao nhiêu?
Mở S thì được B với và A với . B ra trước vì có nhỏ hơn, sinh ra G với , và bản sửa dừng ngay. Đường qua A chỉ tốn 4, nhưng A chưa kịp được mở. 10 là riêng cạnh từ B tới G, quên phần đã đi. 2 là số cạnh. Bản đúng đẩy G vào heap với 11, mở A, cập nhật G thành 4, rồi mới lấy G ra.
Khi heuristic là một model và thời gian có hạn
Trong bài thi AI, ước lượng chi phí còn lại có khi đến từ một model: một mạng nhìn ảnh bản đồ rồi dự đoán số bước còn lại, hay một hàm đánh giá học từ các lời giải cũ. Model như vậy sai theo cả hai phía. Chỗ nó ước lượng thấp chỉ làm A* mở thêm đỉnh; chỗ nó ước lượng cao có thể đẩy lùi một đường tốt, như ở trên.
Bảo đảm tối ưu mất, nhưng còn một cận. Nếu ở mọi đỉnh với một hằng , A* (bản cho mở lại như trên) trả về đường có chi phí không quá , trong đó là chi phí tối ưu. Lý do: chừng nào đích chưa được lấy ra, trên một đường tối ưu luôn có một đỉnh nằm trong heap với đã bằng chi phí tối ưu từ nguồn tới , nên
Đích được lấy ra trước , nên chi phí của nó ( vì tại đích) không vượt . Weighted A* dùng chủ động điều này: lấy admissible rồi ưu tiên theo với . Thuật toán lao về phía đích và mở ít đỉnh hơn, đổi lại chỉ bảo đảm chi phí không quá .
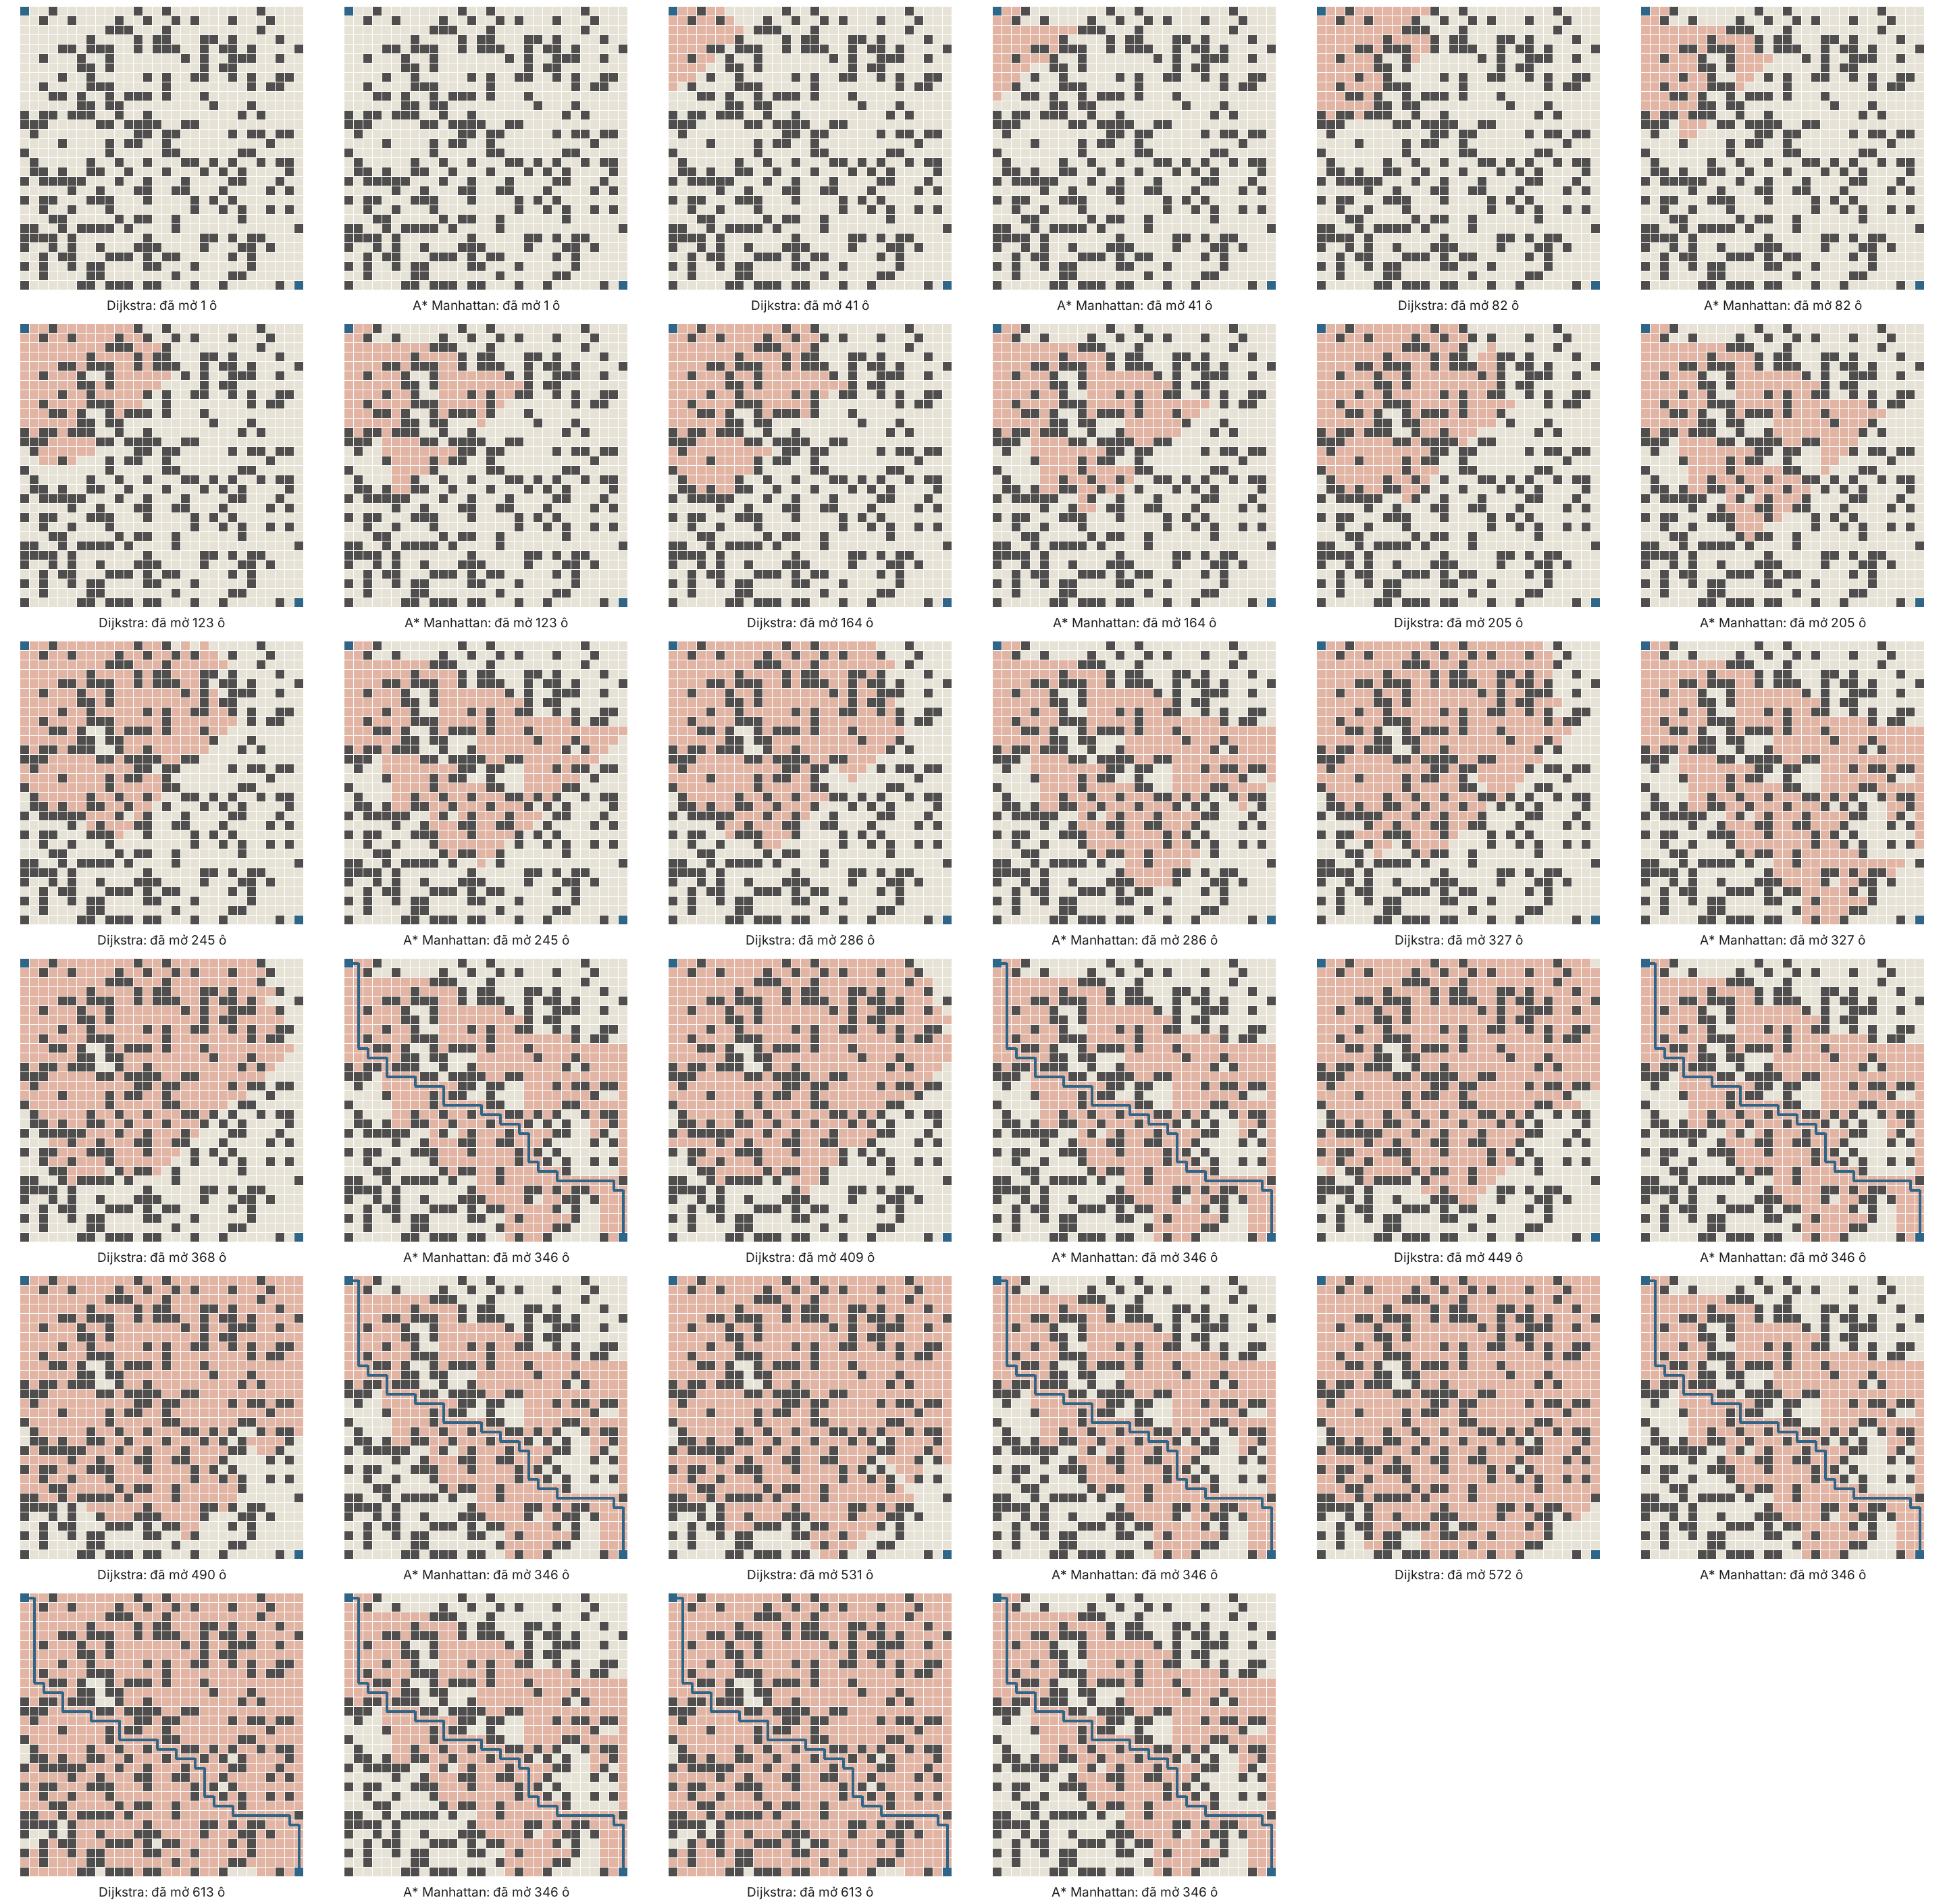
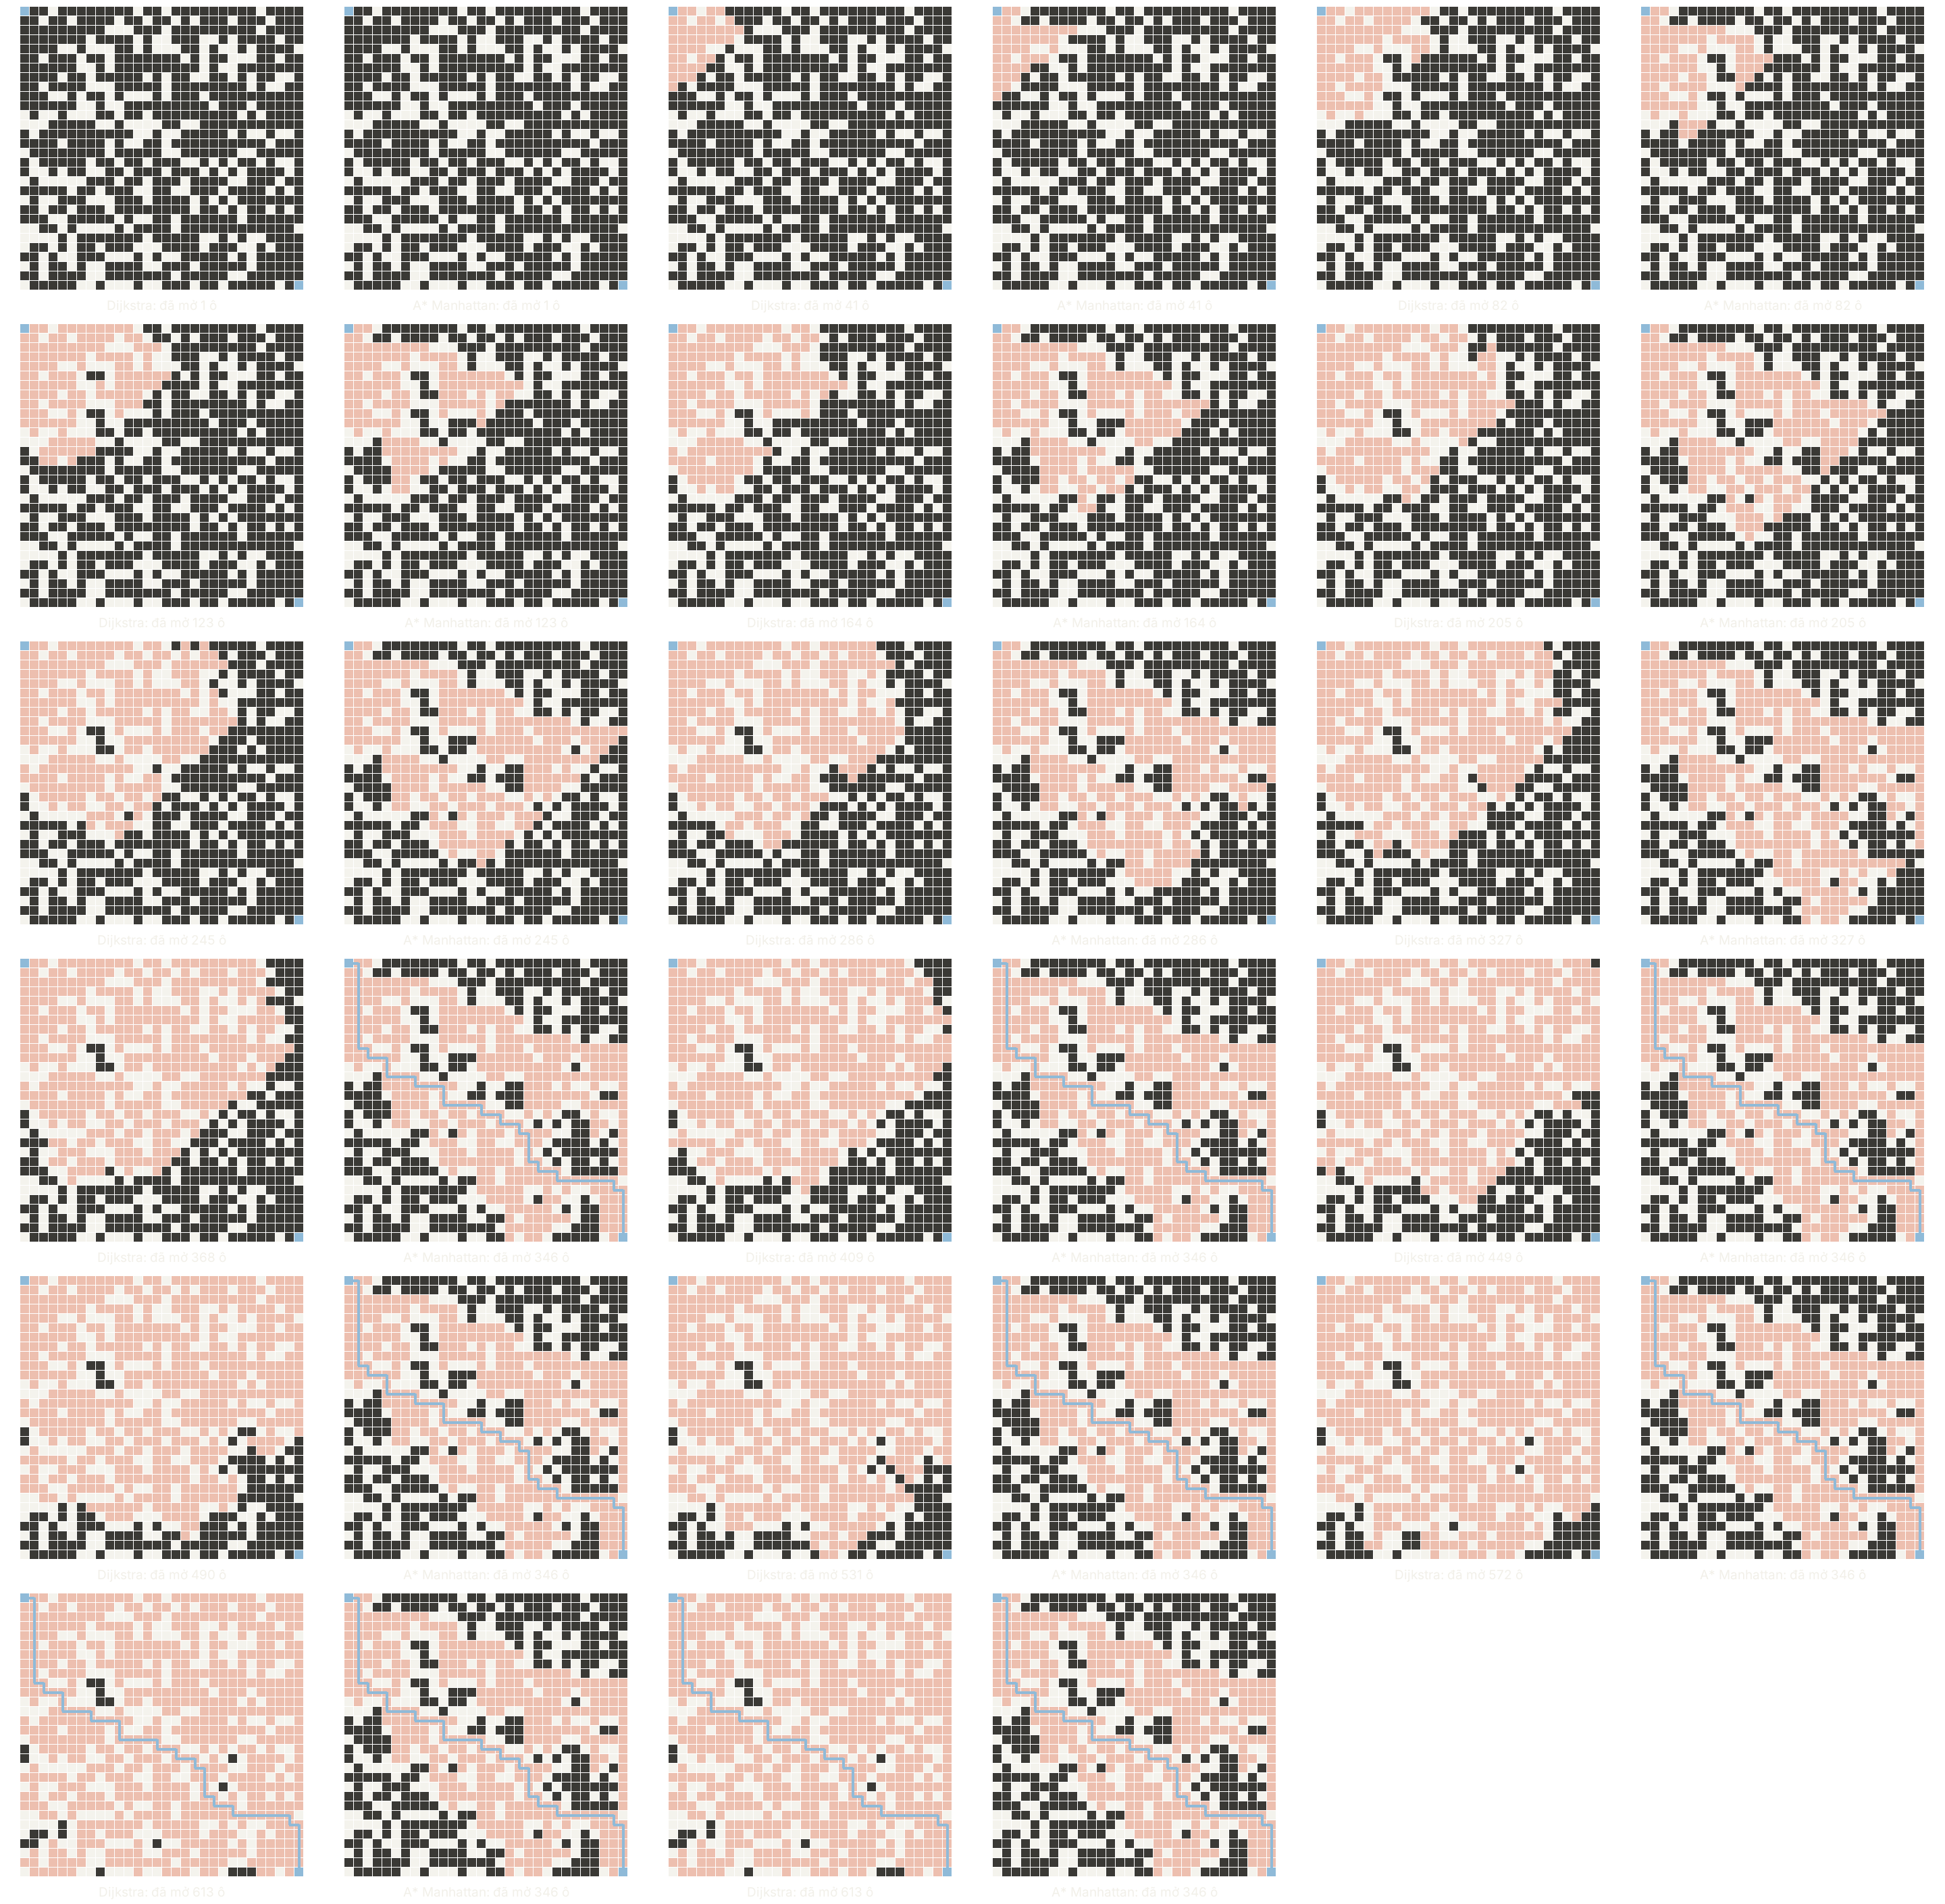
Ta thử trên 20 bản đồ lưới , mỗi ô là tường với xác suất 0.3, đi bốn hướng, mỗi bước giá 1, từ góc trên trái tới góc dưới phải. BFS ngược từ đích cho chi phí còn lại thật của mọi ô. Để có một “model” với sai số biết trước, ta nhân của từng ô với một hệ số ngẫu nhiên trong : dự đoán thấp hơn thật tới 30% và cao hơn tới 40%, nên theo cận trên, đường tìm được dài không quá 1.4 lần tối ưu. Weighted A* dùng Manhattan với .
import random

N = 30
START, GOAL = (0, 0), (N - 1, N - 1)

def neighbors(cell, walls):
    r, c = cell
    for nr, nc in [(r + 1, c), (r - 1, c), (r, c + 1), (r, c - 1)]:
        if 0 <= nr < N and 0 <= nc < N and (nr, nc) not in walls:
            yield (nr, nc)

def cost_to_goal(walls):                 # BFS ngược từ đích: h* của mọi ô
    dist = {GOAL: 0}
    queue = deque([GOAL])
    while queue:
        cell = queue.popleft()
        for nxt in neighbors(cell, walls):
            if nxt not in dist:
                dist[nxt] = dist[cell] + 1
                queue.append(nxt)
    return dist

def random_map(seed):
    rng = random.Random(seed)
    while True:                          # bốc lại tới khi START tới được GOAL
        walls = {(r, c) for r in range(N) for c in range(N) if rng.random() < 0.3}
        walls -= {START, GOAL}
        dist = cost_to_goal(walls)
        if START in dist:
            return walls, dist

def grid_astar(walls, h, weight=1):
    best = {START: 0}
    heap = [(weight * h(START), 0, START)]
    expanded = 0
    while heap:
        _, cost, cell = heapq.heappop(heap)
        if cost != best[cell]:
            continue
        expanded += 1
        if cell == GOAL:
            return cost, expanded
        for nxt in neighbors(cell, walls):
            if cost + 1 < best.get(nxt, math.inf):
                best[nxt] = cost + 1
                heapq.heappush(heap, (cost + 1 + weight * h(nxt), cost + 1, nxt))
    return math.inf, expanded

def manhattan(cell):
    return abs(cell[0] - GOAL[0]) + abs(cell[1] - GOAL[1])

results = {"Dijkstra": [], "A* Manhattan": [], "A* model": [], "Weighted A* w=2": []}
for seed in range(20):
    walls, dist = random_map(seed)
    rng = random.Random(1000 + seed)
    factor = {cell: rng.uniform(0.7, 1.4) for cell in dist}   # sai số -30% đến +40%
    def model(cell):
        return dist[cell] * factor[cell]
    setups = [("Dijkstra", lambda cell: 0, 1), ("A* Manhattan", manhattan, 1),
              ("A* model", model, 1), ("Weighted A* w=2", manhattan, 2)]
    for name, h, weight in setups:
        cost, expanded = grid_astar(walls, h, weight)
        results[name].append((cost / dist[START], expanded))

for name, rows in results.items():
    ratios = [ratio for ratio, _ in rows]
    longer = sum(ratio > 1 for ratio in ratios)
    mean_expanded = sum(expanded for _, expanded in rows) / len(rows)
    print(f"{name:15s}  dài hơn tối ưu {longer:2d}/20  tệ nhất x{max(ratios):.3f}  "
          f"mở trung bình {mean_expanded:.1f}")
assert max(r for r, _ in results["A* Manhattan"]) == 1
assert max(r for r, _ in results["A* model"]) <= 1.4
assert max(r for r, _ in results["Weighted A* w=2"]) <= 2
Dijkstra dài hơn tối ưu 0/20 tệ nhất x1.000 mở trung bình 594.8
A* Manhattan dài hơn tối ưu 0/20 tệ nhất x1.000 mở trung bình 276.9
A* model dài hơn tối ưu 9/20 tệ nhất x1.103 mở trung bình 142.4
Weighted A* w=2 dài hơn tối ưu 14/20 tệ nhất x1.310 mở trung bình 115.0
Đọc từng dòng:
- Manhattan đúng cả 20 bản đồ và mở trung bình 276.9 ô, chưa tới một nửa 594.8 ô của Dijkstra.
- Model mở 142.4 ô, khoảng một nửa Manhattan, nhưng 9 trong 20 bản đồ cho đường dài hơn tối ưu, tệ nhất 1.103 lần.
- Weighted A* mở ít nhất, 115.0 ô, với 14 trong 20 bản đồ dài hơn, tệ nhất 1.310 lần.
Hai dòng sau đều nằm dưới cận của mình (1.4 và 2); trên các bản đồ này, đường thực tế còn tốt hơn cận khá nhiều. Muốn đáp án tối ưu chính xác thì chỉ dòng Manhattan dùng được; muốn đổi một chút chất lượng lấy tốc độ thì hai dòng sau cho biết giá phải trả. Số bản đồ bị dài hơn tối ưu còn dao động theo bản đồ được bốc; điều đáng nhớ là thứ tự: heuristic chứng minh được thì tối ưu, model và mở ít đỉnh hơn nhưng có lúc sai.
Hỏi nhanh
Weighted A* dùng Manhattan với , trả về một đường hợp lệ dài 54 bước, và chưa chạy thuật toán nào khác. Ta biết gì về độ dài tối ưu ?
Cận cho , nên . Đường dài 54 là hợp lệ, nên đường tối ưu không dài hơn, tức . Không có gì bảo đảm 54 đã là tối ưu. là dùng cận theo chiều ngược.
Hỏi nhanh
Đề yêu cầu in đúng độ dài đường ngắn nhất, sai là 0 điểm, và thời gian đủ cho Dijkstra. Theo bảng 20 bản đồ, nên dùng heuristic nào?
Manhattan là một lower bound đã chứng minh được trên lưới bốn hướng, nên A* tối ưu ở cả 20 bản đồ, và chỉ mở 276.9 ô so với 594.8 của Dijkstra. Model mở ít hơn, nhưng sai ở 9 trên 20 bản đồ, còn sai ở 14. Với đề chấm đúng tối ưu, mỗi lần sai là mất trọn điểm. Bỏ heuristic thì vẫn đúng nhưng phí công. Admissibility của Manhattan là điều chứng minh được, không phải điều phải tin.
Khi đề giới hạn thời gian, tìm kiếm nên chạy kiểu anytime (lúc nào cũng có đáp án): tìm nhanh một lời giải hợp lệ, chẳng hạn bằng weighted A* với lớn, lưu lại, rồi chạy tiếp với nhỏ dần tới 1 nếu còn giờ; hết giờ thì nộp lời giải tốt nhất đang có.
Beam search ở bài 6.4 là một cách giới hạn ngân sách khác: mỗi độ sâu chỉ giữ trạng thái tốt nhất, bộ nhớ cố định, nhưng có thể loại mất lời giải tối ưu, thậm chí mọi lời giải. Trước khi chọn, đo số trạng thái mở được mỗi giây trên test lớn nhất.
Tìm kiếm cục bộ: chỉ cần một trạng thái tốt
Có bài chỉ hỏi trạng thái cuối, không hỏi đường đi: đặt 8 quân hậu không ăn nhau, xếp thời khóa biểu ít trùng tiết nhất. Tìm kiếm cục bộ (local search) giữ một trạng thái hoàn chỉnh rồi sửa dần, nên gần như không tốn bộ nhớ.
Hill climbing (leo đồi) mỗi bước chuyển sang trạng thái láng giềng tốt nhất và dừng khi không láng giềng nào tốt hơn. Chỗ dừng có thể chỉ là một cực đại địa phương (local maximum): xung quanh đều kém hơn, nhưng ở xa còn chỗ tốt hơn.
Hai cách thoát hay dùng. Random restart chạy lại hill climbing từ nhiều điểm ngẫu nhiên và giữ kết quả tốt nhất. Simulated annealing (luyện kim mô phỏng) chọn một láng giềng ngẫu nhiên: tốt hơn thì nhận, xấu hơn một lượng thì vẫn nhận với xác suất . Nhiệt độ giảm dần, nên lúc đầu dễ nhảy qua thung lũng, về sau gần như chỉ còn nhận bước tốt. Genetic algorithm (giải thuật di truyền) giữ cả một quần thể lời giải, chọn lọc các lời giải tốt, lai ghép và đột biến chúng để sinh thế hệ sau.
Trạng thái của bài 8 quân hậu là hàng của quân hậu ở mỗi cột; điểm là số cặp hậu ăn nhau, cần đưa về 0. Ta chạy hai cách từ cùng 100 điểm xuất phát ngẫu nhiên.
N_QUEENS = 8

def attacks(rows):
    return sum(rows[i] == rows[j] or abs(rows[i] - rows[j]) == j - i
               for i in range(N_QUEENS) for j in range(i + 1, N_QUEENS))

def hill_climb(rows):
    while True:
        best, best_rows = attacks(rows), None
        for col in range(N_QUEENS):
            for row in range(N_QUEENS):
                if row != rows[col]:
                    cand = rows[:col] + [row] + rows[col + 1:]
                    if attacks(cand) < best:
                        best, best_rows = attacks(cand), cand
        if best_rows is None:            # không láng giềng nào tốt hơn
            return rows
        rows = best_rows

def annealing(rows, gen, steps=4000, t0=2.0):
    cur = attacks(rows)
    for k in range(steps):
        if cur == 0:
            break
        temperature = t0 * (1 - k / steps) + 1e-9
        col, row = gen.randrange(N_QUEENS), gen.randrange(N_QUEENS)
        cand = rows[:col] + [row] + rows[col + 1:]
        worse = attacks(cand) - cur      # dương là xấu đi
        if worse <= 0 or gen.random() < math.exp(-worse / temperature):
            rows, cur = cand, cur + worse
    return rows

gen = random.Random(0)
starts = [[gen.randrange(N_QUEENS) for _ in range(N_QUEENS)] for _ in range(100)]
climbed = sum(attacks(hill_climb(r)) == 0 for r in starts)
annealed = sum(attacks(annealing(r, random.Random(i))) == 0 for i, r in enumerate(starts))
print(f"Hill climbing giải được {climbed}/100, simulated annealing giải được {annealed}/100")
Hill climbing giải được 18/100, simulated annealing giải được 91/100
Hill climbing kẹt ở phần lớn điểm xuất phát: trạng thái còn một hai cặp hậu ăn nhau, mà dời một quân nào cũng không giảm được. Simulated annealing chấp nhận những bước làm tăng số cặp ăn nhau lúc đầu, nhờ vậy ra khỏi các chỗ kẹt đó. Với random restart, chạy lại hill climbing trung bình khoảng 7 lần là gặp một lần giải được.
Hỏi nhanh
Simulated annealing đang ở nhiệt độ và xét một bước làm điểm phạt tăng thêm 2. Xác suất nhận bước đó là bao nhiêu? Ở thì sao?
, còn . Nhiệt độ cao thì dễ nhận bước xấu để thoát chỗ kẹt, nhiệt độ thấp thì gần như chỉ còn leo đồi. Nếu không bao giờ nhận bước xấu thì đó là hill climbing.
Khi người khác chọn bước tiếp theo: minimax
Tìm đường giả sử environment làm theo quy tắc; chơi cờ còn có đối thủ chọn hành động để giảm điểm của ta. Với trò chơi hai người, tất định, thông tin đầy đủ, tổng lợi ích bằng 0, minimax đánh giá theo giả thiết đối thủ cũng chơi tối ưu.
Xét cây sâu hai lượt. Ta chọn nhánh A hoặc B; sau đó đối thủ chọn một lá. Nhánh A có điểm 3 và 5, nhánh B có điểm 2 và 9; mọi điểm đo từ góc nhìn của ta. Đối thủ ở A chọn 3, ở B chọn 2. Ta nên chọn A vì .
Nếu là điểm ở lá terminal, định nghĩa đệ quy là ở lượt MAX và ở lượt MIN. Đừng chọn lá lớn nhất của toàn cây: đường tới lá đó có thể đòi đối thủ hợp tác.
def minimax(tree, maximizing=True):
    if isinstance(tree, (int, float)):
        return tree
    child_values = [minimax(child, not maximizing) for child in tree]
    return max(child_values) if maximizing else min(child_values)

game_tree = [[3, 5], [2, 9]]
branch_values = [minimax(branch, maximizing=False) for branch in game_tree]
print("Giá trị hai nhánh:", branch_values)
print("Minimax:", minimax(game_tree), "chọn A:", branch_values[0] > branch_values[1])
assert minimax(game_tree) == 3
Giá trị hai nhánh: [3, 2]
Minimax: 3 chọn A: True
Hỏi nhanh
Gốc là MAX, có hai nhánh MIN. Nhánh A có lá 4 và 6, nhánh B có lá 2 và 9. Vì sao MAX không chọn B để nhắm tới 9?
Minimax tính và , rồi MAX lấy 4. Nhắm tới lá 9 là giả định đối thủ hợp tác với mình. Lấy trung bình là mô hình một đối thủ chọn ngẫu nhiên, không phải đối thủ tối ưu. MIN ở A chọn 4 chứ không chọn 6, vì đối thủ muốn giảm điểm của MAX.
Alpha-beta pruning bỏ những nhánh đã chắc chắn không thay đổi quyết định minimax. Trong cây trên, xét A trước thì MAX đã bảo đảm được 3. Sang B, lá đầu là 2 nên MIN ở B sẽ trả không quá 2, kém hơn 3; lá 9 không cần đọc. Giá trị minimax giữ nguyên, còn thứ tự xét nước đi quyết định cắt được bao nhiêu: xét nước tốt trước thì cắt nhiều hơn.
Với cây đầy đủ hệ số nhánh và độ sâu , minimax có thể phải xét lá. Vì vậy game lớn thường dùng giới hạn độ sâu và evaluation function. Khi cắt trước terminal, giá trị lá chỉ là ước lượng, nên không còn bảo đảm kết quả của cây trò chơi đầy đủ.
Hỏi nhanh
Gốc là MAX, có ba nhánh MIN, xét từ trái sang phải. A có lá 6 và 4, B có lá 3 và 8, C có lá 5 và 1. Alpha-beta không cần đọc lá nào?
A cho 4, nên MAX có ít nhất 4. Ở B, lá 3 đã không quá 4, nên bỏ qua lá 8. Ở C, lá 5 còn lớn hơn 4, và MIN có thể xuống thấp hơn, nên phải đọc lá 1. Sau đó C cho 1. Lá 4 phải đọc, vì lúc xét A chưa có mốc nào. Giá trị ở gốc là 4, đúng như minimax đầy đủ.
Nếu có xúc xắc, tầng chance lấy kỳ vọng theo xác suất chứ không lấy min. Nếu đối thủ không phải người chơi đối kháng tối ưu, giả thiết minimax cũng cần cân nhắc. Ta phải xác định mô hình tương tác trước khi chọn phép gộp giá trị.
Evaluation function ở độ sâu cắt có thể là một model học từ ván đấu. Với game có hệ số nhánh rất lớn như cờ vây, Monte Carlo tree search (MCTS) không mở đều mọi nhánh mà dồn ngân sách mô phỏng vào nhánh hứa hẹn. Mỗi lượt mô phỏng đi từ gốc xuống; tại mỗi nút, chọn con có
lớn nhất, với là điểm trung bình của con theo góc nhìn người chọn nước ở nút cha, là số lần thăm con đó, là số lần thăm nút cha; con chưa thăm được thử trước.
Tới nút chưa mở thì mở rộng, đánh giá bằng một ván chơi ngẫu nhiên tới cuối hoặc bằng một model, rồi cộng kết quả ngược lên mọi nút trên đường đã đi. Số hạng thứ nhất khai thác nhánh đang tốt, số hạng thứ hai ưu tiên nhánh còn ít được thử. Hết ngân sách thì chọn nước ở gốc được thăm nhiều nhất.
AlphaZero thay ván chơi ngẫu nhiên bằng value network và dùng policy network để ưu tiên nước đi.
Ràng buộc: không phải mọi bài đều hỏi đường đi
Nhà trường cần xếp ba nhóm A, B, C vào hai phòng 0 và 1. A và B phải khác phòng, B và C phải khác phòng; A được ấn định ở phòng 0. Ta không quan tâm thứ tự thao tác xếp, chỉ quan tâm bộ gán cuối có hợp lệ không.
Đây là bài toán thỏa mãn ràng buộc (constraint satisfaction problem, CSP): biến là phòng của mỗi nhóm, domain là , constraints là , , . Tính tay: buộc ; từ đó . A và C dùng chung phòng được vì đề không cấm. Tự thêm sẽ làm một đề có nghiệm thành vô nghiệm.
Quay lui gán từng biến và bỏ ngay nhánh đã vi phạm một điều kiện có đủ biến. Đây là pruning bằng tính hợp lệ; khác heuristic ước lượng chi phí của A*. Ta cài trên đúng ba biến rồi so với vét cạn toàn bộ bộ gán.
from itertools import product

variables = ["A", "B", "C"]
edges = [("A", "B"), ("B", "C")]

def consistent(assignment):
    if "A" in assignment and assignment["A"] != 0:
        return False
    for left, right in edges:
        if left in assignment and right in assignment:
            if assignment[left] == assignment[right]:
                return False
    return True

def backtrack(assignment):
    if len(assignment) == len(variables):
        return [assignment.copy()]
    variable = variables[len(assignment)]
    answers = []
    for room in [0, 1]:
        assignment[variable] = room
        if consistent(assignment):
            answers.extend(backtrack(assignment))
        del assignment[variable]
    return answers

csp_answers = backtrack({})
oracle_answers = []
for rooms in product([0, 1], repeat=3):
    A, B, C = rooms
    if A == 0 and A != B and B != C:
        oracle_answers.append(dict(zip(variables, rooms)))
assert csp_answers == oracle_answers
print("Nghiệm CSP:", csp_answers)
print("Khớp vét cạn:", csp_answers == oracle_answers)
Nghiệm CSP: [{'A': 0, 'B': 1, 'C': 0}]
Khớp vét cạn: True
Với nhiều biến, minimum remaining values (MRV) chọn biến còn ít giá trị hợp lệ nhất để sớm gặp nhánh thất bại. Forward checking loại khỏi domain các giá trị đã xung đột với biến mới gán. Những kỹ thuật này giảm công tìm, nhưng domain và constraints vẫn phải mô tả đúng bài; chúng không tạo thêm một điều kiện mà đề không có.
Hỏi nhanh
Thêm nhóm D phải khác phòng với cả A và B, vẫn chỉ có hai phòng, và . Quay lui gán theo thứ tự A, B, C, D, có forward checking. Vô nghiệm được phát hiện sớm nhất vào lúc nào?
Gán loại 0 khỏi domain của B và của D. Gán loại 1 khỏi domain của C và của D. D hết giá trị, nên nhánh này bị bỏ ngay, chưa cần gán C. Quay lui thuần thì phải tới D mới thấy. vi phạm , và đề không có ràng buộc nào giữa C và D. A và B đã chiếm cả hai phòng, nên bài vô nghiệm dù xếp C thế nào.
Forward checking chỉ nhìn từ biến vừa gán sang các láng giềng. Arc consistency xét mọi cặp: cung nhất quán khi với mỗi giá trị còn lại của , domain của còn ít nhất một giá trị đi kèm thỏa ràng buộc. Thuật toán AC-3 làm như sau:
- Đưa mọi cung của mọi ràng buộc vào hàng đợi.
- Lấy một cung ra, chạy REVISE: xóa khỏi domain của các giá trị không có giá trị đi kèm trong domain của .
- Nếu domain của vừa bị xóa bớt, đưa lại vào hàng đợi các cung từ những láng giềng khác của .
- Lặp tới khi hàng đợi rỗng, hoặc có domain rỗng, tức bài vô nghiệm.
AC-3 thường chạy trước hoặc xen giữa các bước quay lui để thu nhỏ domain. Nó chỉ kiểm từng cặp biến, nên domain còn nguyên chưa chứng tỏ bài có nghiệm.
def ac3(domains, arcs):
    domains = {v: set(d) for v, d in domains.items()}
    queue = deque(arcs)
    while queue:
        x, y = queue.popleft()
        # mọi ràng buộc ở đây là ≠
        removed = {a for a in domains[x] if not any(a != b for b in domains[y])}
        if removed:
            domains[x] -= removed
            if not domains[x]:
                return None                      # domain rỗng: vô nghiệm
            queue.extend((z, x) for z, w in arcs if w == x and z != y)
    return domains

def both_ways(pairs):
    return [(a, b) for a, b in pairs] + [(b, a) for a, b in pairs]

rooms = {"A": {0}, "B": {0, 1}, "C": {0, 1}}
print("Chuỗi A ≠ B ≠ C, A = 0:", ac3(rooms, both_ways([("A", "B"), ("B", "C")])))
triangle = {"X": {0, 1}, "Y": {0, 1}, "Z": {0, 1}}
triangle_arcs = both_ways([("X", "Y"), ("Y", "Z"), ("Z", "X")])
print("Tam giác X, Y, Z đôi một khác:", ac3(triangle, triangle_arcs))
Chuỗi A ≠ B ≠ C, A = 0: {'A': {0}, 'B': {1}, 'C': {0}}
Tam giác X, Y, Z đôi một khác: {'X': {0, 1}, 'Y': {0, 1}, 'Z': {0, 1}}
Ở bài xếp phòng, AC-3 tự suy ra đúng nghiệm duy nhất mà chưa cần quay lui. Ở tam giác, mỗi cặp riêng lẻ đều thỏa được, nên AC-3 không xóa gì. Nhưng ba biến đôi một khác nhau mà chỉ có hai giá trị thì vô nghiệm. Phải quay lui mới phát hiện được điều đó.
Hỏi nhanh
Hai biến có domain với ràng buộc . Sau AC-3, domain của và là gì?
Cung : không có , nên bị xóa. Cung : không có , nên bị xóa. Mọi giá trị còn lại đều có giá trị đi kèm, chẳng hạn đi với . AC-3 không ép thành một nghiệm duy nhất, vì các cặp , , đều hợp lệ. Chỉ xóa theo một chiều là quên cung .
Từ một nghiệm tới một kết luận logic
Tìm được một bộ gán hợp lệ trả lời câu hỏi “có thể xếp thế nào?”. Muốn kết luận “C bắt buộc ở phòng 0”, cần kiểm mọi bộ gán hợp lệ.
Đặt : A ở phòng 0; : B ở phòng 0; : C ở phòng 0. Vì mỗi nhóm có đúng hai lựa chọn, điều kiện khác phòng tương đương XOR: một mệnh đề đúng, mệnh đề còn lại sai. Knowledge base (KB) là
nghĩa là “và”, là “không”, là XOR. Ta cũng dùng (“hoặc”) và (“nếu P thì Q”); mệnh đề kéo theo chỉ sai khi P đúng mà Q sai, nên tương đương . Ta viết (KB suy ra R) nếu mọi phép gán làm KB đúng cũng làm đúng; mỗi phép gán như vậy gọi là một model của KB. “Đúng trong một nghiệm” yếu hơn “đúng trong mọi nghiệm”.
Khi bỏ điều kiện , vẫn có cách xếp hợp lệ với C ở phòng 1, nên kết luận trước không còn được suy ra.
worlds = list(product([False, True], repeat=3))
models = [(P, Q, R) for P, Q, R in worlds if P and (P != Q) and (Q != R)]
models_without_P = [(P, Q, R) for P, Q, R in worlds if (P != Q) and (Q != R)]
assert models                  # kiểm KB có nghiệm trước khi diễn giải
entails_R = all(R for P, Q, R in models)
counterexamples = [world for world in models_without_P if not world[2]]
print("Models của KB:", models)
print("KB suy ra R:", entails_R)
print("Bỏ P, phản ví dụ cho R:", counterexamples)
assert entails_R and counterexamples
Models của KB: [(True, False, True)]
KB suy ra R: True
Bỏ P, phản ví dụ cho R: [(False, True, False)]
all trên danh sách rỗng của Python trả True. Trong logic cổ điển, KB mâu thuẫn cũng suy ra mọi mệnh đề theo định nghĩa entailment, vì không còn model phản ví dụ. Với hệ thống xếp phòng, điều ta cần báo trước là không có cách xếp hợp lệ, không diễn giải đó thành bằng chứng C ở phòng 0. Vì vậy kiểm satisfiability trước khi đọc kết luận.
Hỏi nhanh
Quay lui tìm được một cách xếp hợp lệ có C ở phòng 0. Đã chứng minh được C luôn ở phòng 0 chưa?
Entailment xét mọi model của KB. Một cách xếp hợp lệ, tức một witness, chỉ cho thấy KB thỏa được, và C ở phòng 0 là có thể xảy ra. Thêm vài nghiệm cùng tính chất vẫn chưa đủ. Phải loại hết khả năng C ở phòng 1, chẳng hạn bằng vét cạn, hoặc chứng minh vô nghiệm.
Hỏi nhanh
Luật nói: nếu trời mưa thì sân ướt, tức . Quan sát thấy sân ướt. Với , có không?
KB có hai model, với là (đúng, đúng) và (sai, đúng). Model thứ hai là phản ví dụ cho M, vì sân có thể ướt do lý do khác. Đây là lỗi “khẳng định hệ quả”. KB thỏa được nên không mâu thuẫn. Nếu nó mâu thuẫn thì theo định nghĩa, nó lại suy ra được mọi mệnh đề.
CNF và resolution: chứng minh mà không liệt kê hết
Bảng chân trị với mệnh đề có dòng. Resolution chứng minh bằng phản chứng, không cần liệt kê:
- Thêm , phủ định điều cần chứng minh, vào KB.
- Đưa về dạng chuẩn tắc hội (CNF): một phép “và” của các clause, mỗi clause là phép “hoặc” của các literal ( hoặc ).
- Lặp luật resolution: từ hai clause chứa một cặp literal đối nhau, như và , sinh clause .
- Sinh được clause rỗng là có mâu thuẫn, vậy . Không sinh thêm được clause mới nào thì .
Đưa về CNF có ba bước: thay bằng ; đẩy vào trong bằng De Morgan, ; rồi phân phối vào . Chẳng hạn thành .
Thử với và . Phủ định cho , nên tập clause là , , , . Mỗi clause là một tập literal; -x là phủ định của x.
def resolve(c1, c2):
    out = []
    for lit in c1:
        if -lit in c2:
            out.append(frozenset((c1 - {lit}) | (c2 - {-lit})))
    return out

def refute(clauses):
    clauses = {frozenset(c) for c in clauses}
    while True:
        new = set()
        for c1 in clauses:
            for c2 in clauses:
                for r in resolve(c1, c2):
                    if not r:
                        return True              # clause rỗng: mâu thuẫn
                    new.add(r)
        if new <= clauses:
            return False                         # không sinh thêm được gì
        clauses |= new

P_, Q_, R_ = 1, 2, 3
kb = [{P_, Q_}, {-P_, R_}]
print("KB ⊨ Q ∨ R:", refute(kb + [{-Q_}, {-R_}]))
print("KB ⊨ Q:", refute(kb + [{-Q_}]))
KB ⊨ Q ∨ R: True
KB ⊨ Q: False
Đường tới mâu thuẫn ở dòng đầu: với cho ; với cho ; với cho clause rỗng. Dòng thứ hai không bao giờ ra clause rỗng, khớp với câu kiểm tra cuối bài: KB suy ra nhưng không suy ra .
Logic mệnh đề chỉ có các câu đúng hoặc sai. Logic vị từ (first-order logic) thêm đối tượng, quan hệ, biến và lượng từ: nghĩa là mọi con mèo đều là thú có vú, nghĩa là có ít nhất một con mèo. Từ và , muốn áp luật kéo theo thì phải tìm một phép thế cho biến làm hai literal trùng nhau: biến thành . Việc tìm phép thế này gọi là unification (hợp nhất). Có phép thế rồi, Modus Ponens (từ và suy ra ) cho . Resolution trên logic vị từ cũng dùng unification theo cách đó.
Hỏi nhanh
Câu viết thành CNF là gì?
là . De Morgan cho , đã là một clause. Phương án đầu là CNF của , khi chỉ cần một trong hai điều kiện đúng là đủ. Hai phương án còn lại đổi nghĩa của câu.
Khi đi thi
- Viết rõ trạng thái gồm những gì và đơn vị chi phí trước khi code.
- Đề chấm đúng tối ưu thì dùng A với heuristic admissible; chấm theo chất lượng thì weighted A hay beam search cũng được.
- Luôn giữ sẵn một lời giải hợp lệ, rồi cải thiện trong thời gian còn lại.
Tóm tắt
- Tìm kiếm cần trạng thái đủ thông tin và đúng đại lượng chi phí. BFS, Dijkstra, A* khác nhau ở thứ tự mở rộng.
- BFS giữ cả tầng biên, cỡ nút; DFS chỉ giữ đường đang đi, cỡ , nhưng không tối ưu; IDS có bộ nhớ của DFS mà vẫn gặp đích nông nhất.
- Tìm kiếm cục bộ sửa dần một trạng thái; hill climbing kẹt ở cực đại địa phương, random restart và simulated annealing giúp thoát ra.
- A* dùng ; lower bound và cách xử lý đường tốt hơn giữ bảo đảm tối ưu. Heuristic quá lớn có thể cho đáp án sai.
- Heuristic từ model hay weighted A* đổi bảo đảm tối ưu lấy tốc độ: nếu thì chi phí không quá . Khi thời gian có hạn, giữ sẵn một lời giải hợp lệ rồi cải thiện dần.
- Minimax xét phản ứng của đối thủ; giá trị của một nhánh không phải lá lớn nhất trong nhánh đó. Alpha-beta bỏ nhánh mà giữ giá trị; MCTS dồn ngân sách mô phỏng vào nhánh hứa hẹn.
- CSP tìm phép gán thỏa mọi ràng buộc. AC-3 xóa các giá trị không có giá trị đi kèm ở láng giềng, nhưng chỉ kiểm từng cặp biến. Suy diễn () kiểm kết luận trên mọi model của KB; cần nhận ra KB vô nghiệm trước khi diễn giải.
- Resolution chứng minh bằng cách đưa về CNF rồi tìm clause rỗng. Logic vị từ cần unification để khớp biến trước khi áp luật.
Kiểm tra cuối bài
Câu 1
Robot quay được bốn hướng, và mỗi hành động là quay trái, quay phải, hay tiến một ô, đều tốn 1. Robot đang đứng quay lên phía bắc, còn đích nằm thẳng về phía đông, cách 6 ô, trên một hàng không có tường. Heuristic là số ô còn lại tới đích, tức 6, bỏ qua việc quay. Chọn nhận định đúng về , và về chi phí tối ưu của kế hoạch bắt đầu bằng quay trái.
Chi phí thật từ trạng thái đầu là 7, gồm một lần quay phải rồi 6 lần tiến. Vì nên admissible, dù không sát vì bỏ qua lần quay. Quay trái trước thì robot quay về phía tây, phải quay thêm hai lần mới hướng về đông, nên tốn . Hướng nằm trong trạng thái, nên hai lần ở cùng một ô nhưng khác hướng là hai đỉnh khác nhau, và một lần quay sai làm mất đúng hai hành động. 7 là chi phí của kế hoạch tốt nhất, bắt đầu bằng quay phải. 8 là quên một trong hai lần quay bù.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.4
Câu 2
Đồ thị có cạnh âm: giá 2, giá 3, giá , giá 1. Dijkstra đóng đỉnh ngay khi lấy nó ra khỏi heap sẽ trả về chi phí bằng bao nhiêu, và chi phí nhỏ nhất thật là bao nhiêu?
Lấy S ra thì đẩy A với 2 và B với 3. Lấy A ra với 2 và đóng nó lại, đẩy G với 3. Khi lấy B ra, đường chỉ tốn , nhưng A đã đóng nên bị bỏ qua, và G ra với 3. Đường thật là , tốn . Dijkstra dựa trên giả thiết thêm cạnh chỉ làm chi phí tăng, nên đỉnh ở đầu heap đã là tối ưu. Cạnh âm phá vỡ giả thiết ấy. Khi có cạnh âm thì cần một thuật toán khác, chẳng hạn Bellman-Ford.
Câu 3
Heuristic admissible ở mọi đỉnh, nhưng có một cạnh giá 1 với và . Một bản A* đóng vĩnh viễn mỗi đỉnh ngay khi lấy nó ra khỏi heap. Nhận định nào đúng?
Consistency đòi , mà ở đây . Khi đó có thể giảm dọc theo đường đi, và một đỉnh có thể được lấy ra lần đầu với chưa phải tốt nhất. Khóa nó lại thì đường rẻ hơn tới sau sẽ bị bỏ. Admissible vẫn đủ cho bản cho phép mở lại, như code của bài, nhưng không đủ cho bản đóng vĩnh viễn. là viết điều kiện theo chiều ngược. Còn admissibility thì đề đã cho sẵn.
Câu 4
Lưới , đi bốn hướng, mỗi bước giá 1, có thêm một cổng một chiều: đứng ở ô có thể dịch tới với giá 1. Đích là , và là khoảng cách Manhattan. Heuristic nào vẫn là lower bound ở mọi ô ?
Một đường tới G hoặc không dùng cổng, khi đó dài ít nhất . Hoặc có dùng cổng: trước lần dịch đầu phải đi tới P, ít nhất , cộng 1 cho lần dịch, và sau lần dịch cuối phải đi từ Q tới G, ít nhất . Lấy min của hai trường hợp thì được một lower bound. Tại , , nhưng đường thật chỉ dài . Vì vậy Manhattan, một nửa của nó là 8, và phép max đều vượt chi phí thật.
Câu 5
Từ trạng thái B có hai hành động. Sang A thì nhận thưởng 50, và giá trị của A hội tụ về 40. Sang C thì nhận thưởng 30, và giá trị của C hội tụ về 100. Với , value iteration bắt đầu từ ở mọi trạng thái. Hành động tốt nhất ở B sau lần cập nhật đầu tiên, và sau khi các giá trị đã hội tụ, lần lượt là gì?
Lúc đầu mọi , nên chỉ có thưởng tức thời được tính: , chọn A. Khi hội tụ, sang A cho , sang C cho , nên chọn C, và . Chọn theo thưởng tức thời cũng là tham lam như greedy best-first, bỏ qua phần còn lại của đường. Chọn C ngay từ đầu cần giá trị tương lai mà lúc đó chưa tính. Giữ A khi hội tụ là bỏ qua . Đảo thứ tự thì sai cả hai bước.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q4.3
Câu 6
Đề game: sau nước đi của ta, bot đối thủ chọn ngẫu nhiên đều giữa hai nước, và điểm là trung bình qua 1000 ván. Nhánh A dẫn tới lá 5 hoặc 7, nhánh B dẫn tới lá 2 hoặc 12, đều là điểm của ta. Nên chọn nhánh nào?
Bot chọn ngẫu nhiên, nên nút của nó là một tầng chance. A có kỳ vọng , còn B có . Minimax giả định đối thủ tối ưu, nên chọn A vì bảo đảm được 5. Cách ấy an toàn hơn trong một ván, nhưng cho điểm trung bình thấp hơn ở đề này. Lá 12 không phải lý do: nếu B dẫn tới 2 hoặc 9 thì kỳ vọng chỉ là 5.5, lại kém A.
Câu 7
MCTS ở gốc đã chạy 20 lượt mô phỏng. Nước A được thăm 10 lần, điểm trung bình 0.6. Nước B được thăm 2 lần, trung bình 0.5. Nước C được thăm 8 lần, trung bình 0.3. Con được chọn theo , với . Lượt mô phỏng tiếp theo đi vào nhánh nào, và nếu hết ngân sách ngay lúc này thì nộp nước nào?
. A được , B được , C được . B mới thử 2 lần, nên số hạng khám phá lớn, và B được chọn. Khi nộp thì không cần khám phá nữa. Hãy chọn nước được thăm nhiều nhất là A, cũng là nước có trung bình cao nhất trên nhiều mẫu nhất. Trung bình 0.5 của B chỉ dựa trên 2 lượt, nên còn rất nhiễu.
Câu 8
Xếp bốn nhóm A, B, C, D vào ba phòng, sao cho các cặp kề nhau trên vòng A-B-C-D-A khác phòng: , , , . Có bao nhiêu cách xếp?
A có 3 cách, B có 2 cách. Nếu , có 1 cách, thì D chỉ cần khác A, có 2 cách. Nếu C khác cả A và B, có 1 cách, thì D phải khác C và khác A, là hai phòng khác nhau, nên còn 1 cách. Tổng cộng . Vét cạn bộ gán cũng đếm ra 18. 24 là , quên rằng D còn bị ràng buộc với A. 12 là cho D luôn chỉ còn một phòng, quên trường hợp . 81 là bỏ qua mọi ràng buộc.
Câu 9
. Kết luận nào được suy ra từ KB?
Nếu P đúng thì mệnh đề thứ hai buộc R đúng. Nếu P sai thì mệnh đề thứ nhất buộc Q đúng. Vậy trong mọi model, đều đúng. Liệt kê , với 1 là đúng, thì KB có 4 model là , , và . Model có Q sai, và model có R sai, nên Q và R riêng lẻ đều không được suy ra. Có nhiều model không cản entailment, chỉ cần kết luận đúng trong tất cả các model.
Câu 10
Đề tìm đường giới hạn mỗi test 2 giây. Điểm bằng độ dài tối ưu chia cho độ dài đường nộp, và không nộp được đường hợp lệ thì 0 điểm. Thử trên máy, A* với Manhattan xong trong 2 giây ở 70% số test, còn lại thì hết giờ. Chiến lược nào hợp lý nhất?
Đây là tìm kiếm kiểu anytime. Weighted A với lớn cho sớm một đường hợp lệ, dài không quá lần tối ưu, rồi lưu lại. Sau đó chạy tiếp với nhỏ dần, tới nếu kịp. Hết giờ thì nộp đường tốt nhất đang có. Test dễ vẫn đạt tối ưu, còn test khó vẫn có điểm. Chỉ chạy A là bỏ trắng 30% số test. Greedy hay beam độ rộng 1 có thể ra đường dài, có khi không tìm được đường nào, và bỏ phí thời gian còn lại lẽ ra dùng để cải thiện.
Đọc thêm
- Russell, Norvig - Artificial Intelligence: A Modern Approach, tài liệu của tác giả. Đọc các phần search, adversarial search, CSP và logic; số chương thay đổi theo edition.
- AIMA - Informed search. Đọc phần , admissibility, consistency và tạo heuristic từ bài toán được nới lỏng.
- AIMA - Game playing. Dùng để đọc minimax, alpha-beta và giới hạn của evaluation ở độ sâu cắt.
- Silver và cộng sự (2018) - A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play, Science. AlphaZero: MCTS dùng policy network để ưu tiên nước đi và value network thay ván chơi ngẫu nhiên.
- AIMA - Constraint satisfaction và Logical agents. Đọc domain, forward checking và định nghĩa entailment để phân biệt nghiệm với kết luận bắt buộc.