Muốn phân loại văn bản, ví dụ nhận xét sau buổi học là khen hay chê, trước hết phải biến câu thành số. Tokenization cắt câu thành các đơn vị nhỏ (từ, mảnh của từ hoặc ký tự); sau đó mỗi câu được biểu diễn bằng số lần xuất hiện của từng token. Bài này học các cách cắt token, dựng một baseline phân loại, rồi xem các câu baseline đoán sai để biết nó thiếu gì.
Một khoảng trắng chưa chắc là một ranh giới từ
Trong C++, đọc bằng cin >> s lấy các mảnh ngăn bởi khoảng trắng. Ta có thể làm tương tự bằng split(), nhưng với câu “học sinh học máy”, kết quả học, sinh, học, máy là bốn âm tiết. Khi nói về người học và lĩnh vực AI, “học sinh” và “học máy” thường là hai đơn vị từ vựng. Tách từ tiếng Việt cần xét ngữ cảnh; không thể ghép mọi cặp âm tiết bằng một quy tắc cố định.
Token là đơn vị mà một hệ thống xử lý, không nhất thiết là từ trong ngôn ngữ học. Tokenizer có thể dùng từ, ký tự, byte hoặc subword (mảnh dưới từ). Cùng một câu sẽ có số token khác nhau dưới các tokenizer khác nhau.
Ký hiệu chỉ chuỗi token có độ dài ; mỗi token được tra thành một ID nguyên trong từ vựng . ID là địa chỉ trong bảng, không phải mức độ hay dở: token ID 100 không “lớn nghĩa” hơn ID 20.
Ta chuẩn hóa Unicode về NFC trước khi đếm. Hai chuỗi trông giống hệt nhau có thể khác nhau ở mức mã: chữ “ọ” có thể là một ký tự dựng sẵn, hoặc chữ “o” theo sau là dấu nặng kết hợp U+0323. NFC gộp cách viết thứ hai về cách thứ nhất và vẫn giữ dấu; tự xóa dấu sẽ làm “ma”, “má”, “mà” mất khác biệt.
Viết thường cũng là một lựa chọn theo nhiệm vụ: phù hợp với baseline nhận xét ở đây, nhưng có thể làm mất thông tin tên riêng trong NER ở bài 6.3.
Bước cắt văn bản thành token gọi là tách token (tokenization); dấu câu thường thành token riêng. Đổi “ko” thành “không”, “dc” thành “được”, hay đưa “Hà Nội” và “hà nội” về cùng một dạng, là chuẩn hóa văn bản. Tiếng Trung, tiếng Nhật không có khoảng trắng giữa các từ nên tách còn khó hơn; với tiếng Việt, chuỗi như “học sinh học sinh học” có nhiều cách ghép âm tiết thành từ, phải dựa vào ngữ cảnh.
import unicodedata
import numpy as np

def normalize_text(text):
    text = unicodedata.normalize("NFC", text)
    return " ".join(text.lower().split())

sentence = "Học sinh học máy"
print(normalize_text(sentence).split())
nfc = unicodedata.normalize("NFC", "ho\u0323c")
print(nfc == "học")
['học', 'sinh', 'học', 'máy']
True
Dòng đầu là bốn âm tiết cắt theo khoảng trắng, chưa phải kết quả tách từ. Dòng thứ hai cho thấy chữ “o” cộng dấu nặng rời, sau NFC, trùng với “học” gõ sẵn. Với model pretrained, phải dùng đúng tokenizer và quy trình chuẩn hóa đi kèm model. Chẳng hạn, PhoBERT nhận văn bản đã tách từ, các âm tiết trong một từ nối bằng dấu gạch dưới (học_sinh); các model đa ngôn ngữ như mBERT hay XLM-R nhận văn bản thô và tự cắt subword.
Hỏi nhanh
"học sinh".split() trả về hai mảnh. Từ đó ta rút ra được điều gì?
Khoảng trắng tiếng Việt ngăn các âm tiết, còn “học sinh” là một từ gồm hai âm tiết. Tách từ cần ngữ cảnh và đúng quy trình của tokenizer. Bỏ dấu không giải quyết được ranh giới từ, lại còn làm mất nghĩa. Nối bằng _ là quy ước của PhoBERT sau bước tách từ, không phải yêu cầu chung của mọi model.
Hỏi nhanh
Chuỗi b in ra trông như “học”, nhưng b == "học" lại là False, và [hex(ord(ch)) for ch in b] cho ['0x68', '0x6f', '0x323', '0x63']. Trước khi đếm token, nên xử lý thế nào?
0x323 là dấu nặng kết hợp, đứng sau chữ “o”. Vì vậy b có 4 ký tự, còn “học” gõ sẵn chỉ có 3. NFC gộp “o” và dấu nặng thành “ọ”, nên hai chuỗi trùng nhau mà vẫn giữ dấu. Xóa 0x323 biến “học” thành “hoc”. Bỏ dấu cả hai chuỗi làm “ma”, “má”, “mà” trùng nhau. lower() không đụng tới cách ghép dấu.
Subword: từ lạ được ghép từ những mảnh quen
Một từ vựng chứa mọi tên riêng, từ mới và lỗi gõ sẽ rất lớn. Chỉ dùng ký tự thì từ vựng nhỏ, nhưng chuỗi dài. Subword dung hòa hai điều: giữ các mảnh thường gặp thành token, chia những từ ít gặp thành nhiều mảnh.
BPE (byte-pair encoding) bắt đầu từ các ký tự, đếm cặp token kề nhau trên train, gộp cặp có tần suất cao nhất thành một token mới, rồi lặp lại cho đến khi từ vựng đủ kích thước. Tần suất tính có trọng số theo số lần từ xuất hiện.
Để nhìn thuật toán mà không vướng dấu, dùng ba từ tiếng Anh do ta tự tạo corpus: low xuất hiện 3 lần, lower 2 lần, new 1 lần. Cặp l,o và o,w đều có 5 lần. Ta quy định phá hòa theo thứ tự từ điển, vì vậy bước đầu gộp l,o.
Tokenizer của GPT-2 chạy cùng thuật toán trên byte UTF-8 thay vì ký tự (byte-level BPE): 256 giá trị byte là từ vựng gốc, nên chuỗi nào cũng mã hóa được mà không cần token unknown.
from collections import Counter

word_counts = {"low": 3, "lower": 2, "new": 1}
pieces = {word: list(word) for word in word_counts}
pair_counts = Counter()
for word, tokens in pieces.items():
    for left, right in zip(tokens, tokens[1:]):
        pair_counts[(left, right)] += word_counts[word]

best_pair = sorted(pair_counts, key=lambda pair: (-pair_counts[pair], pair))[0]

def merge_pair(tokens, pair):
    merged = []
    i = 0
    while i < len(tokens):
        if i + 1 < len(tokens) and (tokens[i], tokens[i + 1]) == pair:
            merged.append(tokens[i] + tokens[i + 1])
            i += 2
        else:
            merged.append(tokens[i])
            i += 1
    return merged

print(best_pair, pair_counts[best_pair])
for word in word_counts:
    print(word, merge_pair(pieces[word], best_pair))
('l', 'o') 5
low ['lo', 'w']
lower ['lo', 'w', 'e', 'r']
new ['n', 'e', 'w']
Đối chiếu con số 5 bằng tay: cả low và lower chứa l,o, nên . Nếu đếm mỗi loại từ một lần, cặp này chỉ còn 2 và thứ tự gộp có thể đổi: từ phổ biến mất ưu thế. Mỗi bước gộp thêm một token vào từ vựng và một luật vào danh sách. Khi mã hóa câu mới, tokenizer áp các luật đã học theo đúng thứ tự; validation và test chỉ được mã hóa, không được học thêm luật.
Hỏi nhanh
Sau bước gộp l,o, corpus gồm lo w 3 lần, lo w e r 2 lần, và n e w 1 lần. Bước BPE thứ hai gộp cặp nào?
lo,w có trong low 3 lần và lower 2 lần, nên đếm được 5. w,e và e,r chỉ có 2, còn n,e và e,w có 1. Sau bước một, o không còn đứng riêng trong low và lower, nên cặp o,w đã biến mất. Đếm lại nó là quên cập nhật corpus sau khi gộp. Hai luật (l,o) và (lo,w) biến low thành một token.
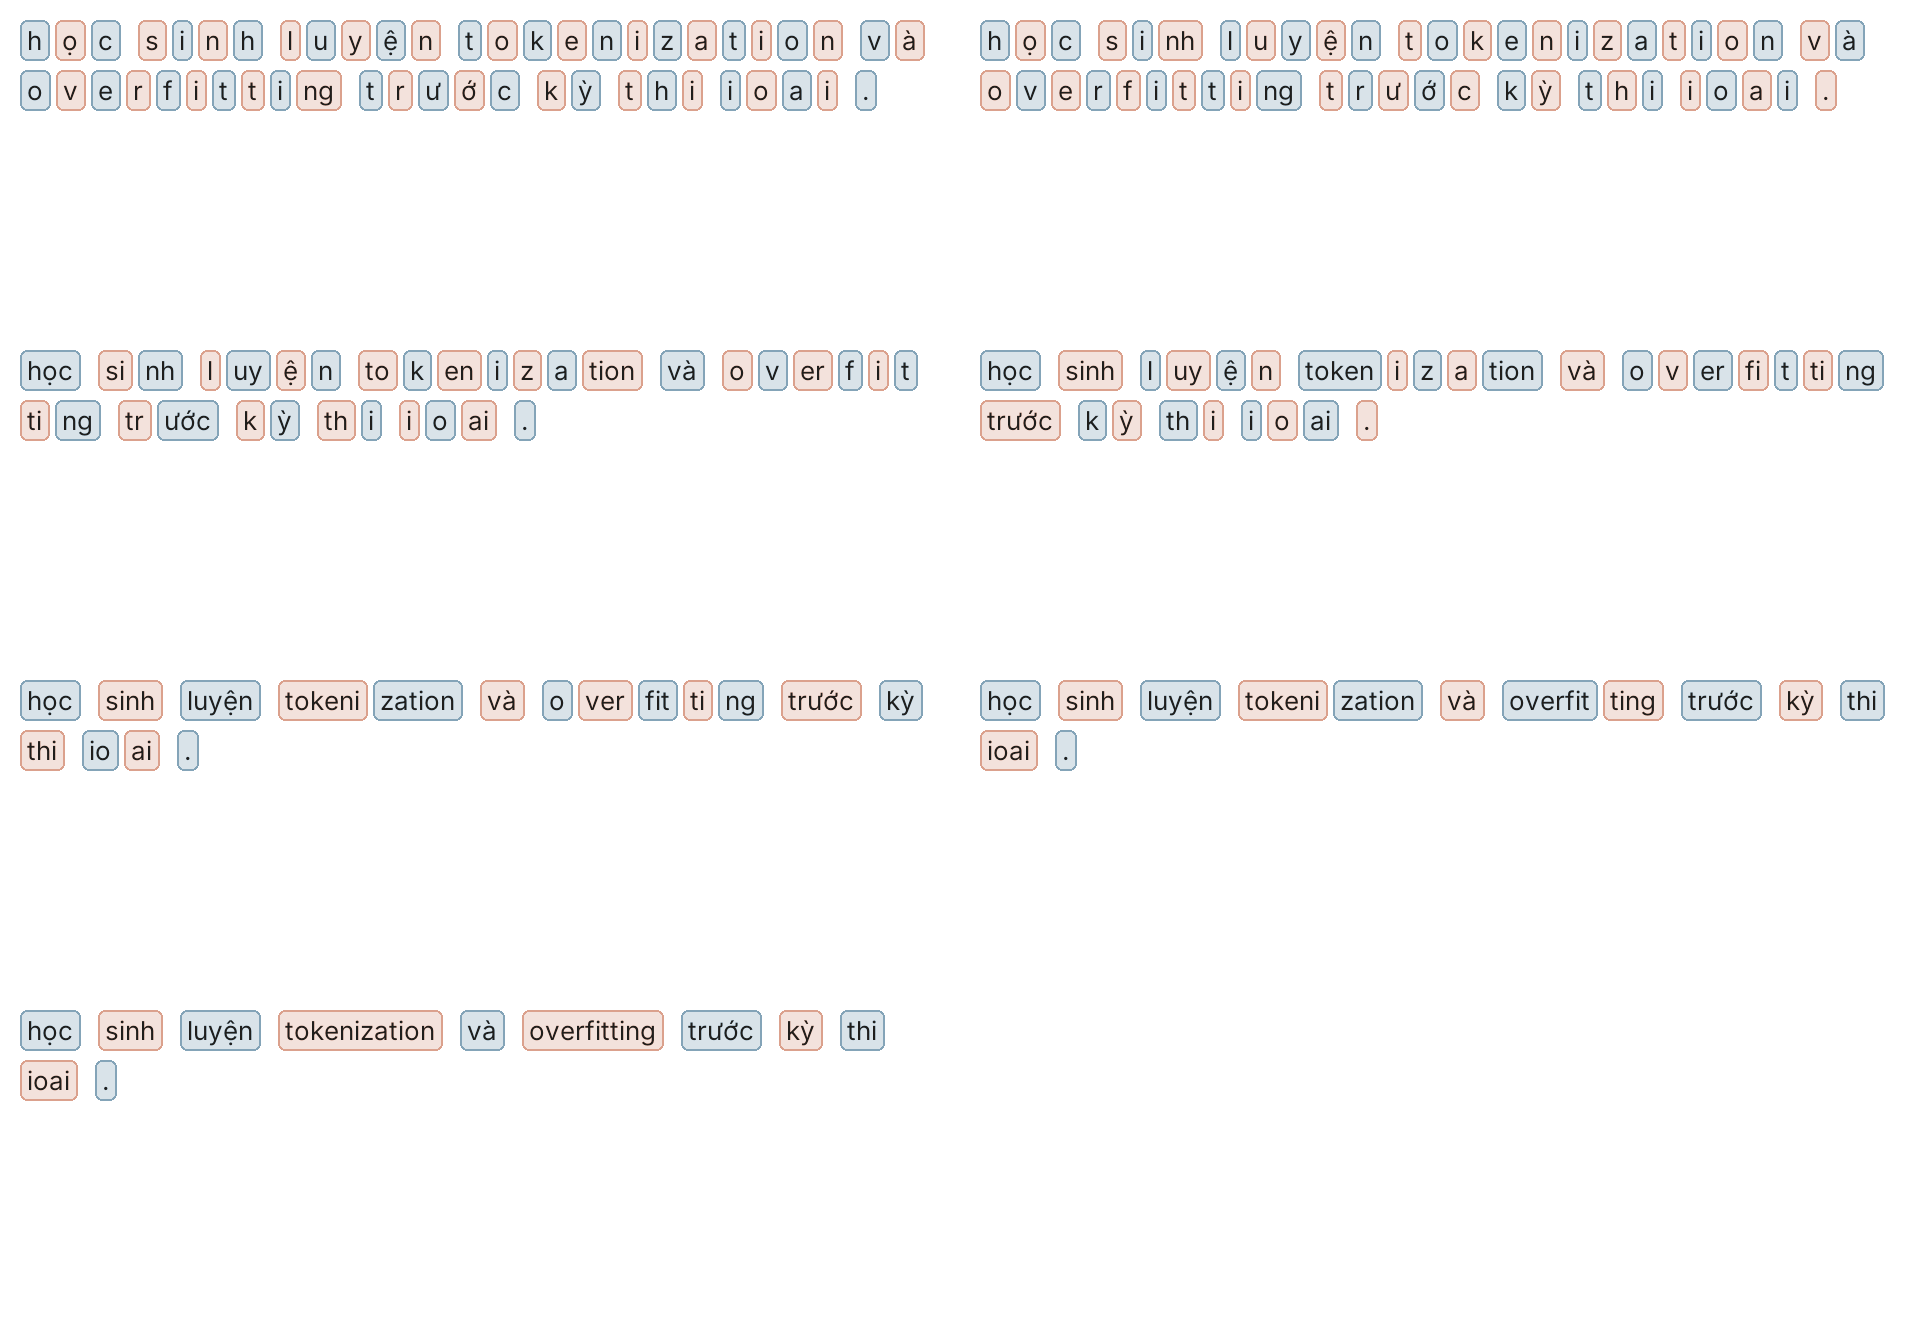
WordPiece, tokenizer của BERT, cũng học một từ vựng subword nhưng khác BPE ở hai chỗ:
- Khi học, nó không chọn cặp xuất hiện nhiều nhất mà chọn cặp có điểm cao nhất ( là tần suất), tức ưu tiên hai mảnh hiếm khi đứng riêng.
- Khi mã hóa, nó chỉ dùng từ vựng cuối, không dùng luật gộp: lấy mảnh dài nhất có trong từ vựng khớp đầu từ, rồi lặp lại với phần còn lại. Tiền tố
##đánh dấu mảnh nối tiếp. Nếu đến một chỗ không mảnh nào khớp, cả từ thành[UNK].
Cùng một từ có thể bị hai tokenizer cắt khác nhau, nên với model pretrained, in token thật do tokenizer của model trả về thay vì đoán từ tên model.
Gặp từ hiếm, tokenizer subword không bỏ đi mà tách thành nhiều mảnh quen; dấu ## của WordPiece đánh dấu mảnh nối tiếp phần trước của cùng một từ, như play + ##ing. BPE mức byte không bao giờ cần [UNK], vì chuỗi nào cũng là một dãy byte;
Tokenization giải thích vài lỗi lạ của mô hình ngôn ngữ. Model thấy “strawberry” là vài mảnh chứ không thấy từng chữ cái, nên đếm chữ r dễ sai; số dài bị cắt thành những mảnh không theo hàng đơn vị, nên cộng số dài khó. Tokenizer học chủ yếu trên tiếng Anh tách tiếng Việt vụn hơn: cùng một nội dung có thể tốn gấp đôi số token, tức gấp đôi chi phí và chỗ trong ngữ cảnh.
Hỏi nhanh
Từ vựng WordPiece chỉ có un, una, ##able và [UNK]. Mã hóa từ unable thì được gì?
Mảnh dài nhất khớp với đầu từ là una, dài hơn un. Phần còn lại là ble, cần ##ble, ##bl hoặc ##b, nhưng không mảnh nào có trong từ vựng, nên cả từ thành [UNK]. Cách cắt un cộng ##able có tồn tại, nhưng thuật toán tham lam không quay lui để thử. ##ble, ##b và ##le không có trong từ vựng, nên hai kết quả còn lại không thể xuất hiện.
Từ chuỗi token đến TF-IDF
Baseline cổ điển không cần subword: ta đếm âm tiết hoặc cụm âm tiết xuất hiện trong nhận xét. Bag-of-words đặt mỗi mục từ thành một cột; mỗi câu thành một hàng. Nó giữ tần suất nhưng bỏ vị trí. Vì thế “An giúp Bình” và “Bình giúp An” có cùng vector unigram. Bigram (hai token liền nhau) khôi phục một phần thứ tự, nhưng vẫn không biểu diễn toàn bộ cấu trúc câu.
TF-IDF giảm trọng số của những mục xuất hiện ở quá nhiều câu. Với cấu hình mặc định làm trơn IDF của scikit-learn, nếu có câu train và mục xuất hiện trong câu, ta dùng
Trước chuẩn hóa, đặc trưng là số lần xuất hiện nhân IDF. Sau đó, mặc định mỗi hàng được chuẩn hóa có độ dài L2 bằng 1 nếu khác vector 0. Từ lặp nhiều được nhấn mạnh trong câu, từ quá phổ biến được giảm tương đối. Không có “hiểu nghĩa” nào tự xuất hiện từ công thức này: hai từ đồng nghĩa khác chữ vẫn ở hai cột.
Vài thuật ngữ đi kèm:
- Kho văn bản dùng làm dữ liệu gọi là corpus; mỗi tài liệu thành một vector, nên 12 tài liệu cho 12 vector.
- Những từ rất phổ biến như “là”, “và”, “của” gọi là từ dừng (stopword); bỏ chúng thu nhỏ từ vựng và bớt nhiễu, nhưng phải cẩn thận với từ mang nghĩa như “không”.
Ở dạng gốc không làm trơn, tf là số lần xuất hiện chia độ dài văn bản và : “mèo” xuất hiện 3 lần trong bài 150 từ có tf 0.02; “và” có mặt trong cả 1000 văn bản có idf nên TF-IDF bằng 0. Lấy những mục có TF-IDF cao nhất của một bài cũng là cách đơn giản để trích từ khóa.
Hỏi nhanh
Sau TF-IDF có chuẩn hóa L2 mặc định, nhận xét “hay” và nhận xét “hay hay hay” cho ra hai vector thế nào?
Cả hai chỉ có một ô khác 0, ở cột “hay”. Trước khi chuẩn hóa, ô ấy là và . Chia cho độ dài thì cả hai đều thành 1 ở cột đó. Số lần lặp chỉ có tác dụng tương đối giữa các mục trong cùng một câu. IDF đếm số câu chứa mục, không đếm số lần lặp trong câu.
Với phân loại nhị phân, logistic regression cho điểm , rồi xác suất . Ở đây nhãn 1 là nhận xét tích cực và nhãn 0 là nhận xét tiêu cực. Thư viện học bằng loss phân loại và regularization. Ta đã học logistic regression ở chương 2; điểm mới là được rút từ văn bản.
Một baseline cổ điển khác là Naive Bayes đa thức (multinomial). Nó giả định các token độc lập với nhau khi đã biết nhãn, nên xác suất của cả câu là tích xác suất từng token:
Ở đây là số lần mục có trong câu, là tổng số lần mục xuất hiện trong các câu train nhãn , còn (thường bằng 1, gọi là làm trơn Laplace) giữ cho mục chưa gặp ở một lớp không có xác suất 0: từ “trúng thưởng” chưa từng có trong 100 từ của các thư thường, từ vựng 50 mục, có xác suất trong lớp ấy. Học chỉ là đếm, nên Naive Bayes chạy rất nhanh và thường mạnh khi ít dữ liệu.
Giả định độc lập sai với văn bản: “theo” gần như luôn đi cùng “dõi”, nên cùng một bằng chứng bị cộng hai lần và xác suất bị đẩy về gần 0 hoặc 1. Hiệu log-xác suất của hai lớp là tổng có trọng số của các , nên Naive Bayes cũng là một bộ phân loại tuyến tính trên vector đếm.
Tính thử TF-IDF và logistic regression trên một train có ba câu: “hay dễ”, “hay rõ”, “khó”. Mục “hay” xuất hiện trong hai câu nên IDF bằng ; “dễ” xuất hiện trong một câu nên bằng . Vector chưa chuẩn hóa của “hay dễ” trên hai cột này là . Độ dài của nó xấp xỉ 2.127, nên sau chuẩn hóa là . Tích vô hướng với trọng số giả định và bias 0 cho , tức . Trọng số được chọn để luyện tính, không lấy từ baseline.
raw = np.array([np.log(4 / 3) + 1, np.log(4 / 2) + 1])
unit = raw / np.linalg.norm(raw)
z_hand = unit @ np.array([1.0, -1.0])
print("idf:", raw.round(3))
print("tfidf:", unit.round(3))
print("p:", round(1 / (1 + np.exp(-z_hand)), 3))
idf: [1.288 1.693]
tfidf: [0.605 0.796]
p: 0.452
Code cho đúng ba số đã tính tay. Nếu “hay” có mặt ở cả ba câu, IDF của nó là : mục phổ biến chỉ bị giảm tương đối, không bị xóa khỏi biểu diễn.
Hỏi nhanh
Giữ IDF như trên, trọng số giả định là và bias bằng 0. Câu “hay hay dễ” cho xấp xỉ bao nhiêu?
Vector chưa chuẩn hóa là , độ dài khoảng 3.083. Sau chuẩn hóa còn . Khi đó và . Lặp “hay” làm vector nghiêng về cột “hay”, nên khác 0.452. Chuẩn hóa chỉ xóa hiệu ứng lặp khi mọi mục trong câu lặp cùng số lần. 0.707 là kết quả khi quên chuẩn hóa, lúc đó .
Dựng baseline trên dữ liệu nhỏ
Đoán một nhận xét là khen hay chê gọi là phân tích cảm xúc (sentiment analysis); xếp câu “cho mình đặt bàn 4 người lúc 7 giờ” vào nhóm “đặt chỗ” là phân loại ý định. Cả hai đều là phân loại văn bản. Ta tự viết 12 câu train và 6 câu validation, không tải dữ liệu.
Sáu câu đủ để soi từng lỗi nhưng quá ít để so hai model: mỗi câu đổi accuracy . Validation cố ý chứa hai câu phủ định để tìm giới hạn của biểu diễn. Các câu cùng nhãn không được mặc định là độc lập nếu chúng là bản sao hoặc cùng một người viết.
from sklearn.pipeline import Pipeline
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score, confusion_matrix

train_texts = [
    "bài học hay dễ hiểu", "nội dung rõ ràng bổ ích",
    "bài giảng tốt dễ theo dõi", "ví dụ hay hữu ích",
    "khóa học thú vị", "lời giải rõ ràng",
    "bài học khó hiểu nhàm chán", "nội dung kém rối",
    "bài giảng tệ khó theo dõi", "ví dụ sai vô ích",
    "khóa học nhàm chán", "lời giải rối sai",
]
train_labels = np.array([1] * 6 + [0] * 6)
valid_texts = [
    "bài học hay", "lời giải sai", "bài giảng không hay",
    "ví dụ rõ ràng", "nội dung rối", "khóa học không tệ",
]
valid_labels = np.array([1, 0, 0, 1, 0, 1])

baseline = Pipeline([
    ("tfidf", TfidfVectorizer(preprocessor=normalize_text, ngram_range=(1, 2))),
    ("classifier", LogisticRegression(C=4.0, random_state=0, max_iter=1000)),
])
baseline.fit(train_texts, train_labels)
valid_pred = baseline.predict(valid_texts)
print("shape train:", baseline["tfidf"].transform(train_texts).shape)
print("accuracy:", f"{accuracy_score(valid_labels, valid_pred):.3f}")
print("macro-F1:", f"{f1_score(valid_labels, valid_pred, average='macro'):.3f}")
print(confusion_matrix(valid_labels, valid_pred, labels=[0, 1]))
shape train: (12, 69)
accuracy: 0.667
macro-F1: 0.667
[[2 1]
[1 2]]
Shape (12, 69) nghĩa là 12 câu train và 69 mục: 31 âm tiết cùng 38 bigram đã gặp trong train. Confusion matrix có hàng là nhãn thật, cột là nhãn đoán, theo thứ tự [0, 1]. Hai ô đường chéo là số câu đúng, hai ô còn lại chỉ hướng nhầm.
Accuracy đếm tổng số đúng chia 6; macro-F1 lấy trung bình F1 của hai lớp để mỗi lớp có vai trò ngang nhau. Trên dữ liệu lệch lớp, accuracy cao vẫn có thể che một lớp bị bỏ qua.
Trong Pipeline, TF-IDF được fit trên train, rồi dùng cùng vocabulary và IDF khi gọi predict(valid_texts). Ta không gọi fit_transform riêng trên validation: thứ tự cột có thể đổi và thống kê của validation sẽ lọt vào thí nghiệm. Có cuộc thi cho phép fit vectorizer trên cả văn bản test không nhãn; khi luật cho phép, cách làm ấy phải áp dụng như nhau cho mọi thí nghiệm để các điểm còn so được với nhau.
Hỏi nhanh
Ta muốn chạy 5-fold cross-validation cho baseline trên cả 18 câu có nhãn. Làm cách nào thì điểm mới tin được?
cross_val_score fit lại toàn bộ Pipeline trên phần train của mỗi fold, nên vocabulary và IDF chỉ đến từ phần đó. Fit trên cả 18 câu thì fold validation góp cả cột lẫn IDF. Chẳng hạn khi hai câu có “không” cùng rơi vào fold validation, cột “không” vẫn tồn tại, và IDF của nó lấy từ chính những câu đang chấm. Fit riêng trên validation làm lệch thứ tự cột. Vectorizer fit trên 12 câu train đã thấy những câu sẽ nằm trong các fold validation, nên vẫn rò.
Đọc câu sai trước khi tăng độ phức tạp
Ta cần xem từng nhận xét, thay vì chỉ nhìn một điểm tổng. Cột xác suất dưới đây là xác suất model gán cho nhãn 1, không phải xác suất rằng model “hiểu câu”.
positive_index = list(baseline["classifier"].classes_).index(1)
positive_prob = baseline.predict_proba(valid_texts)[:, positive_index]
for text, true, pred, prob in zip(valid_texts, valid_labels, valid_pred, positive_prob):
    print(f"thật={true} đoán={pred} p1={prob:.3f} | {text}")
print("'không' có trong vocabulary:", "không" in baseline["tfidf"].vocabulary_)
thật=1 đoán=1 p1=0.651 | bài học hay
thật=0 đoán=0 p1=0.407 | lời giải sai
thật=0 đoán=1 p1=0.597 | bài giảng không hay
thật=1 đoán=1 p1=0.700 | ví dụ rõ ràng
thật=0 đoán=0 p1=0.370 | nội dung rối
thật=1 đoán=0 p1=0.448 | khóa học không tệ
'không' có trong vocabulary: False
Hai câu chứa “không” cần được xem xét. Từ này không có trên train nên bị bỏ trong biểu diễn; không hay không thể được nhận diện bằng bigram đã học. Model còn nhìn thấy “hay” hoặc “tệ”, rồi suy ra hướng ngược với nghĩa cả câu. Baseline đã có bigram, nhưng một bigram chỉ thành cột khi đã xuất hiện trong train. Nói chung, từ chưa gặp ở train không có cột nên TF-IDF bỏ qua nó khi transform.
Danh sách stopword chứa “không” còn tệ hơn: “phim không hay” thành “phim hay”, đổi hẳn nghĩa. Những câu mỉa mai như “giao hàng nhanh ghê, đúng 3 tuần là tới” cần model đọc được ngữ cảnh như ở bài 6.3.
Liệu một bộ phân loại khác có cứu được? Giữ nguyên dữ liệu, thay logistic regression bằng Naive Bayes trên vector đếm:
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB

naive_bayes = Pipeline([
    ("count", CountVectorizer(preprocessor=normalize_text, ngram_range=(1, 2))),
    ("classifier", MultinomialNB(alpha=1.0)),
])
naive_bayes.fit(train_texts, train_labels)
print("NB đoán:", naive_bayes.predict(valid_texts))
print("thật:   ", valid_labels)
NB đoán: [1 0 1 1 0 0]
thật: [1 0 0 1 0 1]
Naive Bayes sai đúng hai câu có “không”: hai bộ phân loại khác nhau, một đọc TF-IDF, một đọc vector đếm, nhưng cùng một vocabulary đã mất từ phủ định, nên nhầm như nhau. Cách cải thiện bắt đầu từ biểu diễn và dữ liệu: thêm câu phủ định đủ đa dạng vào train, đánh giá trên người viết hoặc chủ đề chưa thấy, rồi mới cân nhắc model ngữ cảnh ở bài 6.3.
Hỏi nhanh
Cả logistic regression lẫn Naive Bayes đều đoán ngược hai câu có chữ “không”. Bước tiếp theo nào nhắm đúng nguyên nhân?
Hai model khác nhau cùng sai ở cùng hai câu, nên lỗi nhiều khả năng nằm ở phần biểu diễn chung. “Không” chưa có cột, nên mọi classifier phía sau đều không thấy nó. Xem các feature còn lại, chẳng hạn bằng baseline["tfidf"].inverse_transform(...), sẽ xác nhận điều đó trước khi tốn công đổi model. Hạ threshold không đúng hướng: “khóa học không tệ” cần lên lớp 1, còn “bài giảng không hay” cần xuống lớp 0. C chỉ đổi mức regularization, không tạo cột cho từ chưa gặp.
Khi đi thi
- Dựng TF-IDF cùng logistic regression trước: vài giây trên CPU là có mốc và một file nộp hợp lệ.
- Chia validation giống cách tạo test, theo người viết hay theo thời gian nếu cần; loại bản trùng trước khi chia.
- Với model pretrained, đếm độ dài bằng đúng tokenizer của nó trước khi chọn
max_length.
Tóm tắt
- Token là đơn vị của tokenizer; tiếng Việt có khoảng trắng giữa âm tiết nên phải kiểm ranh giới từ.
- BPE học luật gộp theo tần suất có trọng số và áp lại đúng thứ tự; WordPiece mã hóa tham lam bằng mảnh dài nhất, không khớp thì
[UNK]. - TF-IDF là biểu diễn từ vựng; logistic regression và Naive Bayes là bộ phân loại tuyến tính đọc nó; cả pipeline fit trên train.
- Điểm tổng đi cùng câu sai và confusion matrix; hai model cùng sai một câu thì xem biểu diễn và dữ liệu trước khi đổi model. Phủ định, từ lạ và bản trùng là những phép thử cần có.
Kiểm tra cuối bài
Câu 1
Bình luận sản phẩm có nhiều tên hãng mới và lỗi gõ như “đẹppp”. Tokenizer theo từ đã có 300 nghìn mục mà test vẫn đầy từ lạ. Chuyển sang subword như BPE hay WordPiece thì được lợi chính ở đâu?
Subword giữ những mảnh thường gặp thành token, và chia từ hiếm thành nhiều mảnh. Vì vậy “đẹppp” vẫn thành vài mảnh đã biết, thay vì một [UNK]. Vài chục nghìn mảnh thay được cho hàng trăm nghìn từ. Các từ cùng gốc như play và playing dùng chung mảnh play. Chuỗi subword thường dài hơn chuỗi từ, không ngắn hơn. BPE và WordPiece đều phải học từ vựng trên corpus. Thuật toán không phụ thuộc ngôn ngữ: học trên corpus tiếng Việt thì cho ra mảnh tiếng Việt.
Câu 2
Đề giới hạn mỗi bình luận 128 token, đếm theo tokenizer của model cho sẵn. Đếm bằng split() thì bình luận dài nhất có 110 âm tiết. Bình luận ấy có vừa giới hạn không?
Tokenizer cắt văn bản thành từ hoặc subword theo từ vựng của nó, rồi thêm các token đặc biệt như [CLS] và [SEP]. Tokenizer đa ngôn ngữ có thể chia một âm tiết tiếng Việt có dấu thành nhiều mảnh, nên 110 âm tiết có thể vượt 128 token. Tokenizer tách theo từ thì lại có thể cho ít token hơn. Tokenizer mức ký tự là một loại riêng, không phải mặc định. Phần vượt giới hạn thường bị cắt ở cuối, có khi đúng chỗ chứa ý chính.
Câu 3
Corpus là list từ ["bun"]*5 + ["sun", "sing", "king", "ring"]. Một bạn đếm các cặp ký tự kề nhau trong vòng for word in set(corpus), và phá hòa theo thứ tự từ điển. Bước gộp BPE đầu tiên đúng ra là gì, và code này gộp gì?
Đếm có trọng số thì u,n có trong bun 5 lần và sun 1 lần, tổng là 6. i,n và n,g mỗi cặp 3 lần. set khử các bản lặp, nên mỗi loại từ chỉ góp 1. u,n còn 2, còn i,n và n,g vẫn là 3, hòa nhau, và phá hòa chọn i,n. Đếm theo loại từ là đổi luôn bài toán: từ phổ biến nhất mất ưu thế. Cách đúng là dùng Counter(corpus), rồi nhân tần suất vào từng cặp như code trong bài.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 5.1-5.2
Câu 4
Đây là hàm mã hóa câu cho một model sinh văn bản.
tokens = [BOS] + [vocab.get(w, UNK) for w in text.split()] + [EOS]
if len(tokens) < max_len:
    tokens += [PAD] * (max_len - len(tokens))
else:
    tokens = tokens[:max_len]
Với max_len = 8 và một câu 9 từ, lỗi nghiêm trọng nhất là gì?
Chuỗi đủ có token. tokens[:8] giữ BOS và 7 từ đầu, bỏ 2 từ cuối cùng với EOS. Với mọi câu dài, model không thấy dấu kết thúc, nên học sai ranh giới chuỗi, và khi sinh có thể không biết dừng. Cách sửa là cắt phần nội dung còn max_len - 2 token, rồi mới thêm BOS và EOS. Việc PAD không được tính vào loss là do attention mask và nhãn -100 lo, ở bước tạo label, không phải lỗi của hàm này. Tokenizer theo từ là một lựa chọn thiết kế, không làm hỏng chuỗi. Câu ngắn vẫn được pad đủ max_len.
Phỏng theoNOAI 2026 Singapore · Chung kết · Câu 19
Câu 5
Một đội lọc tin nhắn rác bằng Naive Bayes trên bag-of-words. Hai từ “khuyến” và “mãi” gần như luôn đi cùng nhau, nhưng mô hình tính chúng như hai bằng chứng độc lập. Hệ quả là gì?
Giả định độc lập biến xác suất của cả câu thành tích xác suất của từng token, nên việc học chỉ là đếm và chạy rất nhanh. Cặp “khuyến mãi” được cộng log-xác suất hai lần, nên xác suất bị đẩy về gần 0 hoặc gần 1. Nhưng phân loại chỉ cần biết lớp nào có điểm cao hơn, và thứ tự ấy thường vẫn đúng. Từ hay đi cùng nhau là đặc điểm của ngôn ngữ, tách từ không làm chúng độc lập. Naive Bayes không học tương tác. Thêm bigram chỉ thêm cột, và các cột vẫn bị coi là độc lập. Nó học bằng cách đếm trên dữ liệu có nhãn.
Câu 6
Vectorizer fit trên train có ba cột [dở, hay, tệ]. Một vectorizer khác fit riêng trên validation cho [dở, hay, ổn]. Shape đều đúng ba cột. Vì sao không đưa ma trận validation này vào classifier cũ được?
Model học hệ số theo vị trí cột. Hệ số âm học cho “tệ” ở cột thứ ba giờ nhân với giá trị TF-IDF của “ổn”, nên câu khen bị kéo về lớp chê. IDF cũng tính trên validation chứ không phải trên train. Ma trận TF-IDF vẫn đầy số 0. Classifier nhị phân nhận bao nhiêu cột cũng được, và số câu của hai tập không cần bằng nhau. Hãy dùng transform của vectorizer đã fit trên train, hoặc gói hai bước vào Pipeline.
Câu 7
Validation có nhiều lỗi gõ như “hayyy”, “haay”, không có trong vocabulary từ của train. Nên thử đổi biểu diễn theo hướng nào trước?
Char n-gram chia từ thành các mảnh ký tự, nên “hayyy” và “hay” có chung những mảnh như ha và hay. Với char_wb từ 2 tới 4 ký tự fit trên 12 câu train của bài, “hayyy” bật 7 cột đã học, còn vectorizer theo từ cho ra vector 0. N-gram theo từ dài hơn vẫn dựa trên từ nguyên vẹn, nên từ gõ sai vẫn bị bỏ. Đổi C không tạo cột cho từ lạ. Bỏ dấu không cứu được “hayyy”, lại làm mất khác biệt giữa “ma” và “má”.
Câu 8
Lớp cần tìm là nhận xét chê, nhãn 0, chiếm 20% validation. Đội báo f1_score(y_true, y_pred) bằng 0.93. Con số này đo gì?
f1_score nhị phân mặc định pos_label=1, nên 0.93 là F1 của lớp khen, chiếm 80% và là lớp dễ. Muốn đo khả năng bắt nhận xét chê, hãy gọi f1_score(y_true, y_pred, pos_label=0), hoặc dùng average=None để xem từng lớp. Nếu đề chấm macro-F1 thì dùng average="macro". Hàm này không tự lấy trung bình hai lớp, và cũng không tính accuracy.
Câu 9
Mỗi học sinh viết khoảng 20 nhận xét với văn phong riêng. Split ngẫu nhiên cho macro-F1 0.91, còn GroupKFold theo học sinh cho 0.74. Test là nhận xét của một khóa học sinh mới. Nên báo và chọn model theo số nào?
Split ngẫu nhiên đặt câu của cùng một người ở cả hai phía. Model nhận ra văn phong, cụm từ quen, thậm chí câu chép lại, nên điểm phản ánh khả năng nhớ người viết. Test gồm người mới, giống với GroupKFold theo học sinh. Với cùng số fold, hai cách chia dùng lượng train như nhau, nên chênh lệch không đến từ lượng dữ liệu. Lấy trung bình hai con số hay trừ một khoảng cố định đều không đo đúng tình huống của test.
Câu 10
Câu validation “quá đỉnh luôn” có mọi từ nằm ngoài vocabulary TF-IDF. Logistic regression đã học có bias . Model trả về xác suất lớp 1 bằng bao nhiêu?
Không mục nào khớp, nên vector TF-IDF toàn số 0, và scikit-learn để nguyên vector 0 khi chuẩn hóa L2. Khi đó , và . Model chỉ còn bias, tức đoán theo xu hướng chung của train. Không có lỗi, cũng không chia đều. Hãy đếm tỉ lệ câu validation và test thành vector 0. Tỉ lệ ấy cao nghĩa là biểu diễn đang bỏ quá nhiều chữ.
Đọc thêm
- Jurafsky, Martin - Speech and Language Processing, Words and Tokens và Text Classification. Đọc để nối token với đặc trưng và nhiệm vụ phân loại.
- Sennrich và cộng sự - Neural Machine Translation of Rare Words with Subword Units. Nguồn gốc ứng dụng BPE cho từ hiếm trong NLP.
- Hugging Face - BPE, WordPiece. Xem sự khác nhau giữa học vocabulary và mã hóa câu mới.
- scikit-learn - Text feature extraction. Kiểm chính xác IDF, chuẩn hóa và
token_patterncủa thư viện. - VinAI - PhoBERT. Đọc yêu cầu tách từ tiếng Việt trước khi dùng tokenizer này.