Vision Transformer (ViT) đưa Transformer từ văn bản sang ảnh: cắt ảnh thành các mảnh vuông nhỏ (patch), biến mỗi mảnh thành một vector, rồi coi các vector đó như các token trong câu. Nhờ attention, mỗi mảnh lấy được thông tin từ mọi mảnh khác ngay ở lớp đầu, trong khi CNN phải qua nhiều lớp mới nối được hai vùng xa nhau. Bài này đưa một ảnh nhỏ qua từng bước của ViT, và học cách mạng biết vị trí của mỗi mảnh.
Patch là một đơn vị đọc ảnh
Patch là khối điểm ảnh không chồng lấn. Với ảnh có kênh, patch , nếu hai chiều chia hết cho thì số patch là , mỗi patch có số. Ta trải mỗi patch thành vector rồi nhân cùng một ma trận để có vector chiều. là chiều biểu diễn được chọn, không phải số pixel.
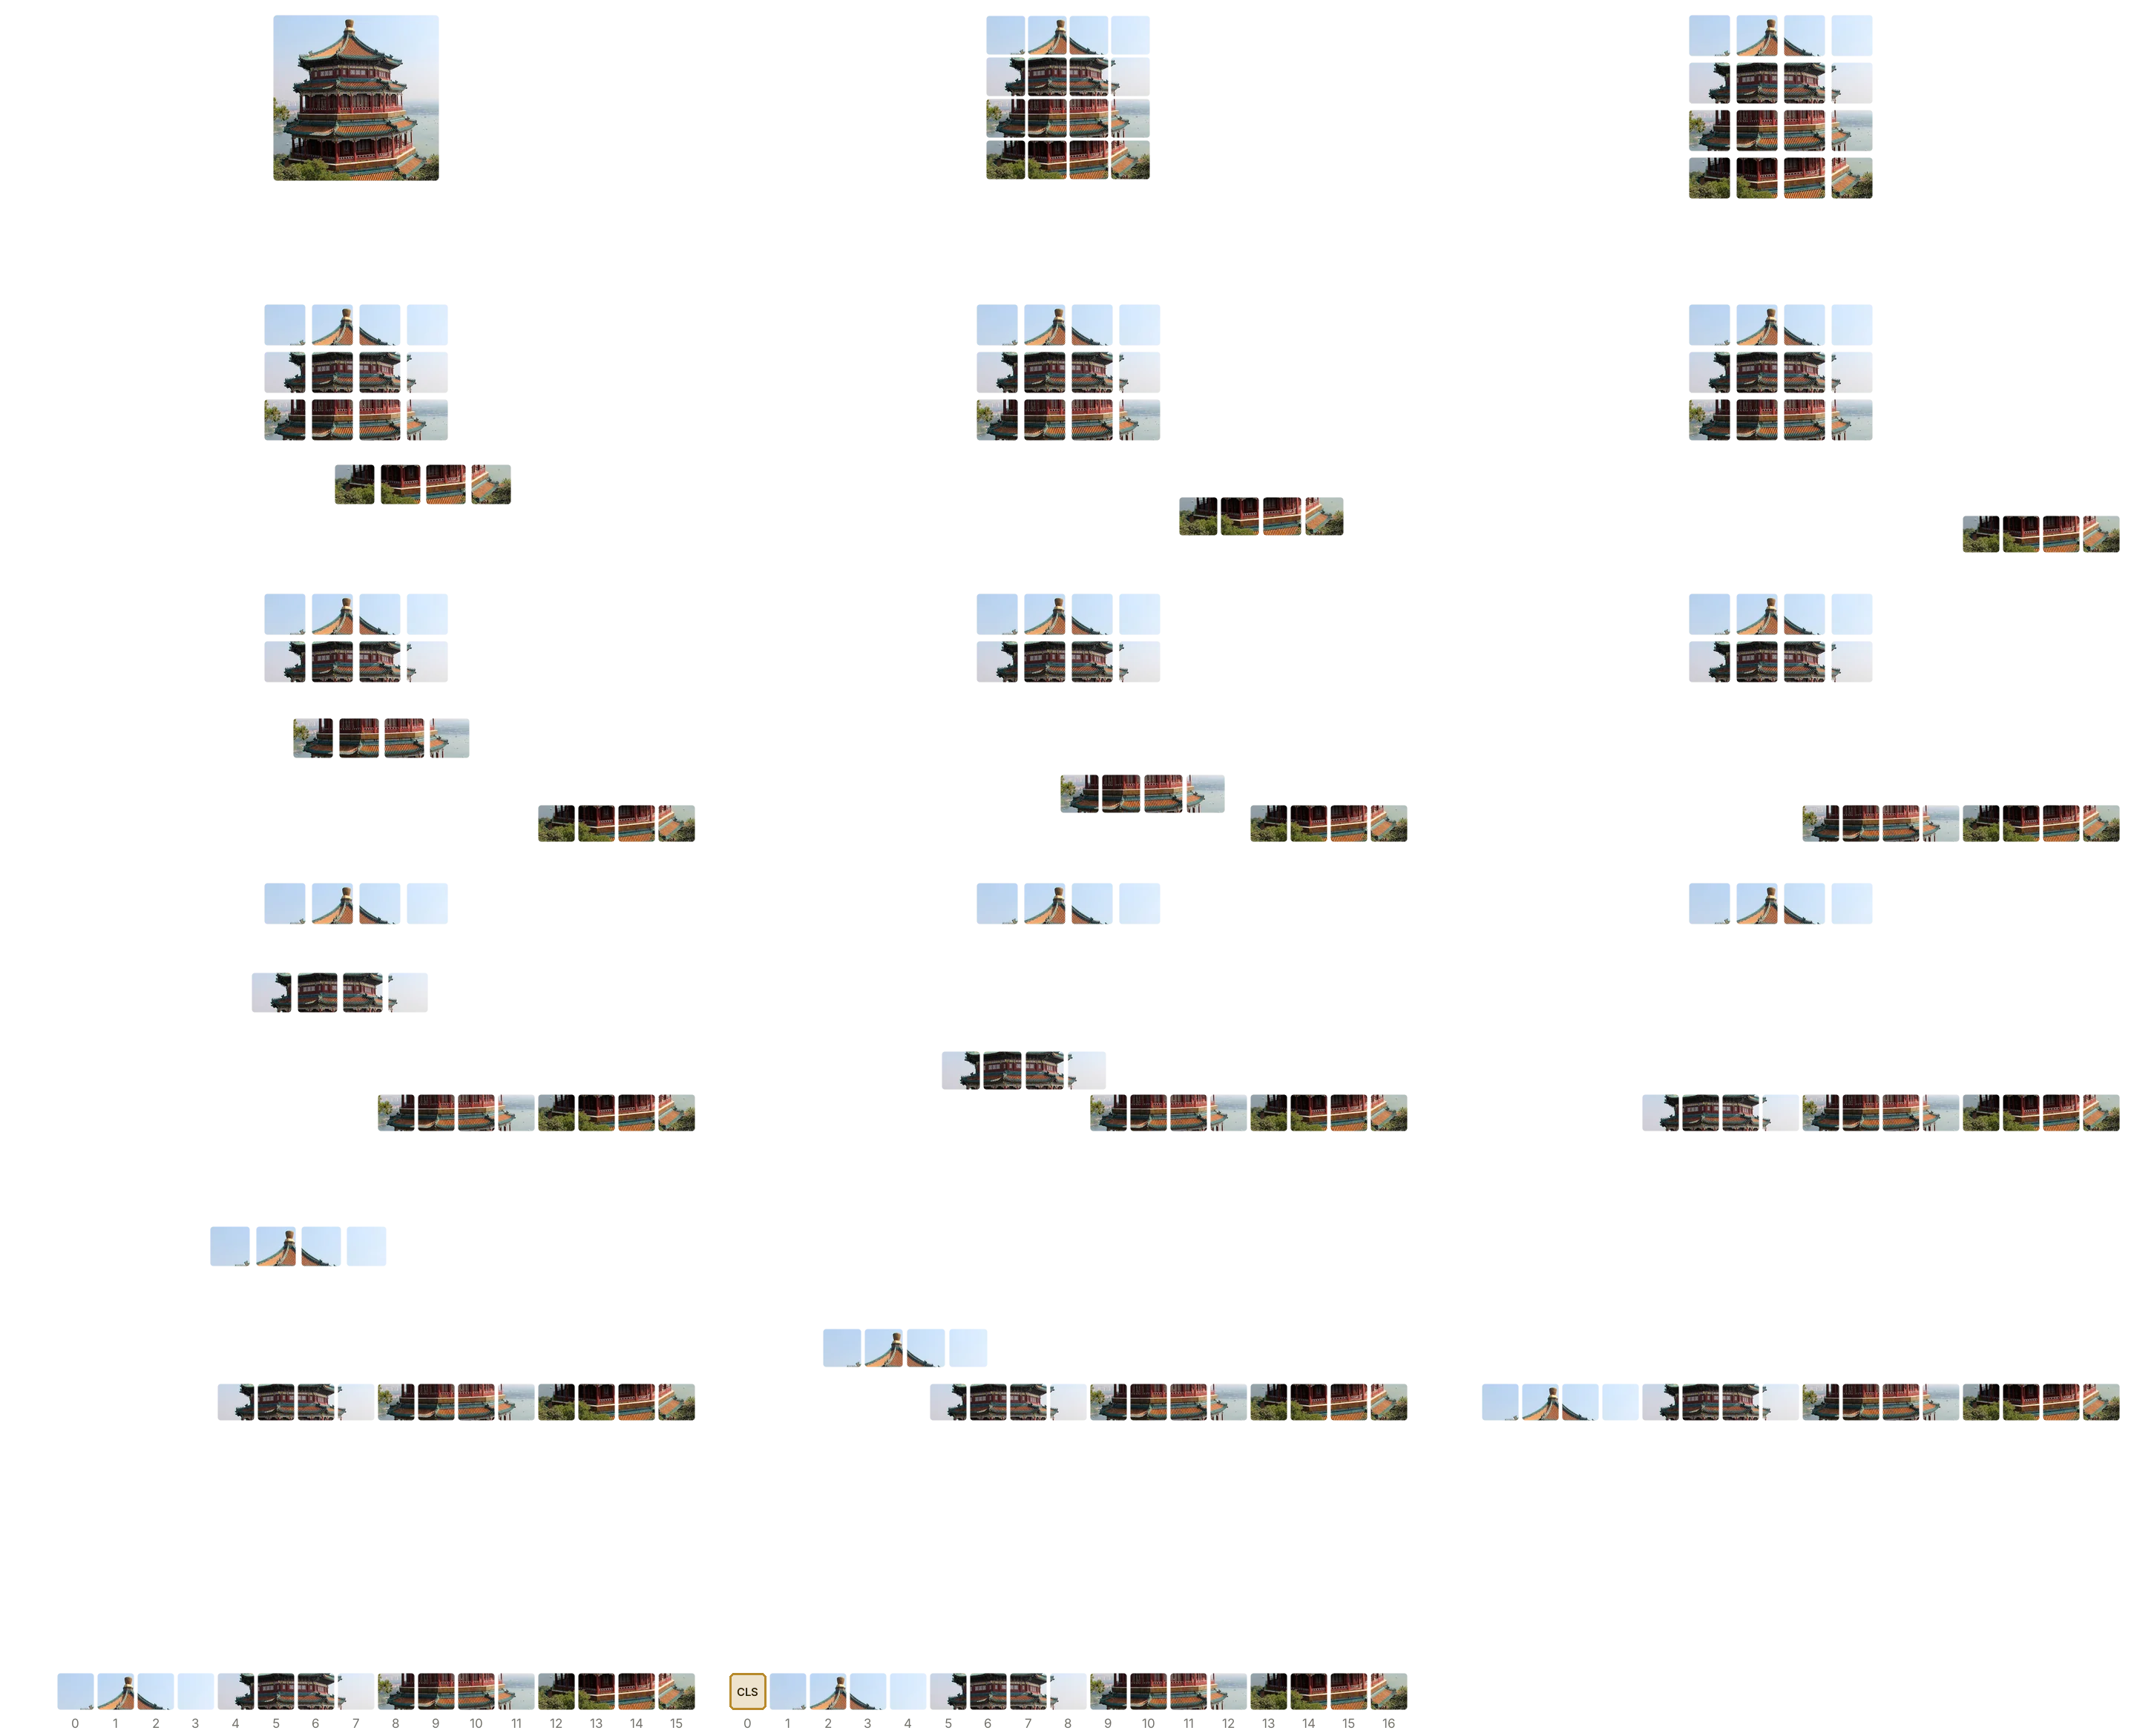
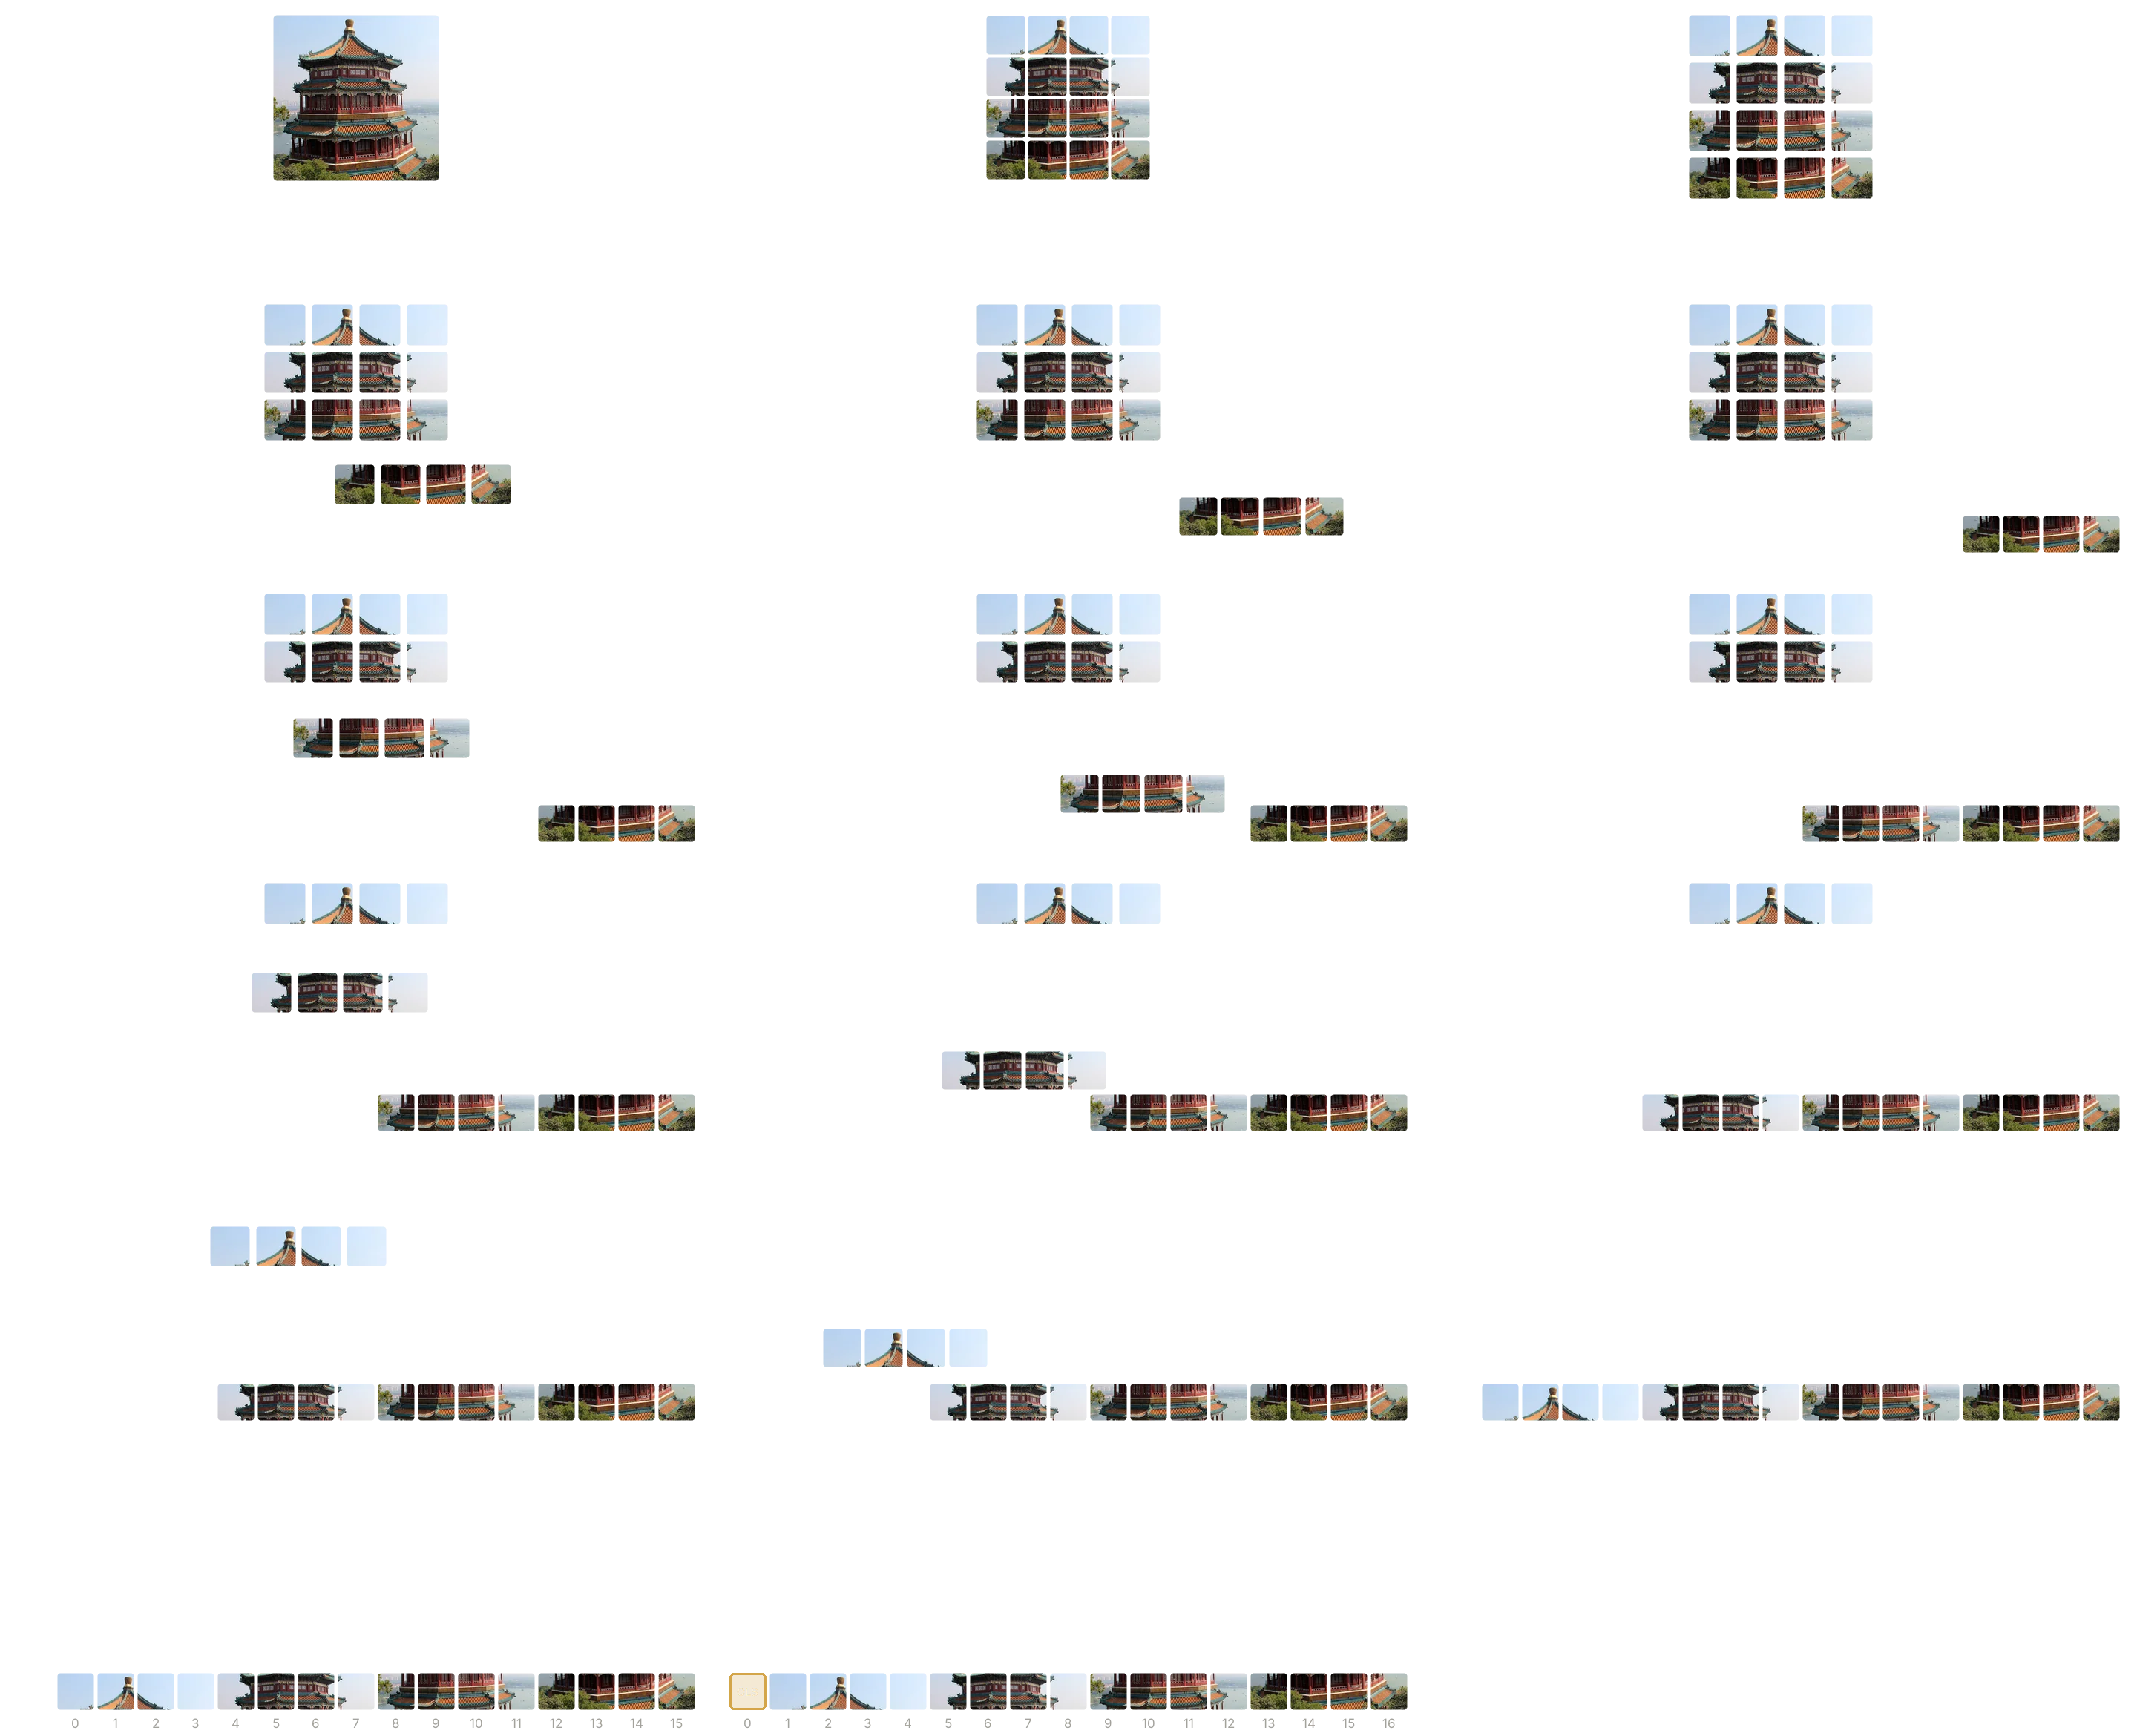
Với ảnh RGB , patch 16 cho token ảnh, mỗi patch thô có số. Bản ViT-Base chọn ; việc trùng với 768 số thô chỉ là tình cờ của cấu hình, vì ViT-Large cùng patch 16 dùng . Tên ViT-B/16 đọc là bản Base với patch .
Bài báo ViT (Dosovitskiy và cộng sự, 2020) đưa chuỗi patch embedding vào một Transformer encoder gần như giữ nguyên từ NLP; tên bài báo nói đúng ý đó: một ảnh đáng giá từ. Các mục sau dựng từng bước trên một ảnh , đủ nhỏ để kiểm bằng tay.
Hỏi nhanh
Ảnh RGB được chia thành các patch . Có bao nhiêu patch, và mỗi patch thô dài bao nhiêu số?
Mỗi chiều có 4 patch, nên có patch. Mỗi patch chứa giá trị.
Chia ảnh thành patch bằng tensor
Ta đánh số ảnh xám từ 0 đến 15 theo hàng. Patch trên trái gồm 0, 1, 4, 5; trên phải gồm 2, 3, 6, 7. Nếu flatten toàn ảnh rồi cứ cắt mỗi bốn số, ta nhận 0, 1, 2, 3 là một patch - đó là một hàng, không phải ô vuông.
unfold tạo cửa sổ theo chiều; permute đặt thứ tự batch, hàng patch, cột patch, kênh, hàng trong patch, cột trong patch. reshape chỉ dùng sau khi thứ tự trục đã đúng.
import torch
from torch import nn

torch.set_num_threads(1)
torch.manual_seed(54)
images = torch.arange(16, dtype=torch.float32).reshape(1, 1, 4, 4)
patch_size = 2
windows = images.unfold(2, patch_size, patch_size)
windows = windows.unfold(3, patch_size, patch_size)
patches = windows.permute(0, 2, 3, 1, 4, 5).reshape(1, 4, 4)
print(patches[0].to(torch.int64).numpy())
print(tuple(patches.shape))
[[ 0 1 4 5]
[ 2 3 6 7]
[ 8 9 12 13]
[10 11 14 15]]
(1, 4, 4)
Đọc dòng đầu để đối chiếu bốn ô tay. Shape (1,4,4) có hai chiều cùng bằng 4 nhưng ý nghĩa khác: bốn patch và bốn số trong mỗi patch. Khi tăng số kênh, chiều cuối tăng, số patch giữ nguyên.
Hỏi nhanh
Ảnh RGB , patch cỡ 2, nên windows có shape (1, 3, 2, 2, 2, 2). Một bạn bỏ bước permute và gọi thẳng windows.reshape(1, 4, 12). Hàng đầu của kết quả chứa gì?
Các trục của windows lần lượt là batch, kênh, hàng patch, cột patch, hàng trong patch, cột trong patch, và reshape đọc đúng theo thứ tự đó. Vì vậy mười hai số đầu là kênh R của patch 0, 1 và 2, mỗi patch bốn số. Shape đúng, code không báo lỗi, nhưng mỗi “patch” trộn ba patch thật. Đáp án “hàng ảnh đầu tiên” quên rằng unfold đã gom thành ô vuông. Với ảnh xám, trục kênh dài 1 nên bỏ permute vẫn ra đúng. Lỗi chỉ lộ ra khi kiểm với ảnh nhiều kênh.
Patch embedding là phép tuyến tính dùng chung
Với vector patch , ta tính , trong đó có shape . Mọi patch dùng chung . Cách khác là conv có kernel , stride , không padding; mỗi kênh đầu ra là một chiều embedding. Hai cách tương đương nếu xếp trọng số cùng thứ tự.
Ta đặt trọng số cụ thể để kết quả dễ kiểm, rồi đối chiếu:
projection = nn.Linear(4, 3)
with torch.no_grad():
    projection.weight.copy_(torch.tensor([[1., 0., 0., 0.],
                                          [0., 1., 0., 0.],
                                          [0.25, 0.25, 0.25, 0.25]]))
    projection.bias.zero_()
tokens = projection(patches)

patch_conv = nn.Conv2d(1, 3, kernel_size=2, stride=2)
with torch.no_grad():
    patch_conv.weight.copy_(projection.weight.reshape(3, 1, 2, 2))
    patch_conv.bias.copy_(projection.bias)
    conv_tokens = patch_conv(images).flatten(2).transpose(1, 2)
print(tokens[0].detach().tolist())
print(torch.allclose(tokens, conv_tokens))
[[0.0, 1.0, 2.5], [2.0, 3.0, 4.5], [8.0, 9.0, 10.5], [10.0, 11.0, 12.5]]
True
Token đầu là : hai chiều đầu đọc hai ô đầu, chiều thứ ba lấy trung bình . True xác nhận hai cách xếp ô nhất quán. Trọng số ở đây đặt tay để dễ đọc; trong ViT thật, được học cùng phần còn lại của mạng.
Hỏi nhanh
Tăng từ 3 lên 12, giữ nguyên ảnh và patch size. Đại lượng nào không đổi?
Số patch chỉ phụ thuộc kích thước ảnh và kích thước patch, nên vẫn là 4. đổi từ sang , nên số tham số, chiều token và số kênh ra của Conv2d đều tăng theo .
Hỏi nhanh
Patch embedding của ViT-B/16 là nn.Conv2d(3, 768, kernel_size=16, stride=16), chạy trên ảnh . Lớp này có bao nhiêu tham số?
Trọng số có số, cộng 768 bias thành . Con số là quên bias. Số tham số không phụ thuộc 196 patch, vì mọi patch dùng chung bộ lọc. Nếu mỗi vị trí có bộ lọc riêng thì mới thành . Còn là số giá trị output của một ảnh, không phải số tham số.
Attention nối các mảnh bằng nội dung
Trong attention, từ token ta tạo query , key và value . Điểm đo mức phù hợp, softmax theo từng hàng tạo trọng số cộng thành 1, rồi lấy tổng có trọng số của :
là số chiều query/key mỗi head, không phải số patch. Ô trong ma trận attention nói token đọc token bao nhiêu ở head này. Nó không tự là xác suất vật thể nằm ở patch , cũng không chứng minh vùng ấy gây ra quyết định.
Điểm khác CNN nằm ở chỗ ngay từ lớp đầu, mọi patch đã có đường đọc trực tiếp mọi patch khác: quyển sách và cái đèn ở hai góc bàn trao đổi trong một bước. CNN phải xếp chồng nhiều lớp thì receptive field mới phủ được hai góc (bài 5.1).
Mỗi block của ViT ghép attention và MLP; trước mỗi phần có LayerNorm, sau mỗi phần có residual connection.
Class token (CLS) là một vector học được, ghép vào đầu chuỗi nên chuỗi dài . Nó không ứng với vùng ảnh nào, chỉ đọc các patch qua attention, và output của nó ở lớp cuối đi vào head phân loại. Với ViT-B/16 trên ảnh 224, chuỗi vào encoder có shape ; mỗi lớp có 12 head, mỗi head một ma trận .
Hỏi nhanh
Lưới có patch. Sau một lớp attention, token của patch đã nhận được thông tin trực tiếp từ patch chưa? Nếu thay bằng CNN chỉ gồm conv stride 1, không pooling, thì cần ít nhất bao nhiêu lớp để receptive field của ô chứa ô ?
Attention tính điểm cho mọi cặp token. Ngay ở lớp đầu, hàng của đã có trọng số cho . Trọng số ấy có thể nhỏ, nhưng đường đi đã có. Sau lớp conv stride 1, receptive field là quanh ô đang xét, tức với xa được ô mỗi phía. Ô cách 13 ô, nên cần 13 lớp. Bảy lớp cho cửa sổ , rộng hơn cả lưới, nhưng tâm nằm ở góc nên chỉ với tới .
Vì sao cần thông tin vị trí?
Attention dựa vào nội dung không biết token này từ góc trái hay góc phải. Nếu đảo thứ tự token và đảo đầu ra tương ứng, self-attention thông thường không có position vẫn cho cùng quan hệ nội dung. Mean pooling trên đầu ra vì vậy không phân biệt cùng tập mảnh bị đổi chỗ.
Position embedding thêm thông tin vị trí vào token trước encoder. Nếu đổi ảnh nhưng giữ các mã tại vị trí của chúng, model có cơ sở phân biệt bố cục. Đổi cả token và mã đi cùng nó chỉ là đổi cách sắp danh sách, chưa thay quan hệ vị trí được biểu diễn.
ViT gốc dùng bảng vị trí 1D học được: patch đánh số theo hàng từ 0 đến , mỗi chỉ số và CLS có một vector riêng, cả bảng có shape và được cộng vào token.
Bảng không ghi sẵn rằng trên lưới , patch 0 và patch 14 kề nhau theo chiều dọc; model tự học điều đó từ dữ liệu. Bài báo cho thấy sau huấn luyện, vector vị trí của các patch cùng hàng hoặc cùng cột giống nhau hơn, và các mã vị trí 2D thiết kế sẵn không cho lợi ích đáng kể.
Ta kiểm tính đối xứng bằng một block nhỏ khởi tạo ngẫu nhiên, vì câu hỏi ở đây là về cấu trúc chứ chưa phải về điều model học được. Dropout tắt để khác biệt không do ngẫu nhiên.
encoder = nn.TransformerEncoderLayer(
    d_model=3, nhead=1, dim_feedforward=6,
    dropout=0.0, batch_first=True,
)
encoder.eval()
permutation = torch.tensor([2, 0, 3, 1])
positions = torch.tensor([[[0.4, 0.0, 0.0],
                           [0.0, 0.4, 0.0],
                           [0.0, 0.0, 0.4],
                           [0.2, -0.3, 0.1]]])
with torch.no_grad():
    pooled = encoder(tokens).mean(dim=1)
    shuffled = encoder(tokens[:, permutation]).mean(dim=1)
    with_position = encoder(tokens + positions).mean(dim=1)
    shuffled_content = encoder(tokens[:, permutation] + positions).mean(dim=1)
print("without position:", torch.allclose(pooled, shuffled, atol=1e-5))
print("with fixed positions:", torch.allclose(with_position, shuffled_content, atol=1e-5))
without position: True
with fixed positions: False
Dòng True xác nhận đối xứng khi chưa có vị trí: đảo các mảnh thì kết quả sau pooling không đổi, nên sách ở góc trái hay góc phải là như nhau với block này. Dòng False cho thấy cộng mã vị trí cố định đã phá đối xứng đó: cùng tập mảnh ở bố cục khác cho output khác. Dùng thông tin vị trí ấy thế nào là phần model tự học từ dữ liệu.
Hỏi nhanh
Ta đảo thứ tự các token ảnh, và position embedding cũng đi theo từng token. Sau đó lấy mean pooling. Vì sao kết quả có thể giữ nguyên?
Mỗi patch vẫn đi cùng mã vị trí của chính nó, nên tập các cặp nội dung và vị trí không đổi. Self-attention và mean pooling không phụ thuộc thứ tự liệt kê. Mã vị trí ngẫu nhiên vẫn phá được đối xứng, như dòng False cho thấy. Mean pooling lấy trung bình những output đã chịu ảnh hưởng của vị trí, còn eval() chỉ tắt dropout. Muốn đổi bố cục thì phải đổi nội dung tại các vị trí, và giữ mã vị trí tại chỗ.
CNN và ViT: so giả định trước khi so điểm
CNN có thiên hướng cục bộ và chia sẻ trọng số theo vị trí. ViT với attention toàn cục có đường trao đổi trực tiếp giữa patch xa, nhưng mất thông tin bên trong patch nếu projection nén quá mạnh, và phải học quan hệ không gian qua biểu diễn vị trí. “Toàn cục” không đồng nghĩa tự hiểu mọi quan hệ.
Ít giả định có sẵn thì phải học nhiều hơn từ dữ liệu. Bài báo ViT báo cáo rằng khi chỉ huấn luyện trên ImageNet (khoảng 1.3 triệu ảnh) mà không dùng regularization mạnh, ViT kém ResNet cùng cỡ vài điểm phần trăm; khi pretrain trên JFT-300M (303 triệu ảnh), ViT vượt ResNet và tốn ít tài nguyên pretrain hơn, rồi fine-tune tốt sang các tập nhỏ.
Hỏi nhanh
Train từ đầu trên 3000 ảnh. Một CNN nhỏ đạt 85% trên validation. Một ViT nhỏ có số tham số tương đương đạt 100% trên train nhưng chỉ 70% trên validation. Lý do khả dĩ nhất là gì?
Train 100% mà validation 70% là overfit, không phải underfit. CNN có sẵn giả định cục bộ và chia sẻ trọng số. ViT phải tự học quan hệ không gian từ dữ liệu, nên với ít ảnh nó dễ học thuộc. Rò dữ liệu thường làm validation cao lên chứ không thấp đi. Nhìn toàn cục cũng không bảo đảm tốt hơn, đúng như bài báo ViT cho thấy trên dữ liệu cỡ vừa. Hướng xử lý là dùng checkpoint pretrained, augmentation mạnh, hoặc giữ CNN.
Với attention đầy đủ, ma trận điểm có ô cho mỗi head, hoặc khi có CLS. Giữ patch size, tăng gấp đôi cả hai chiều ảnh làm số patch gấp 4 và số ô attention gấp 16. Convolution có kernel cố định thường tăng công việc theo diện tích, khoảng gấp 4.
Phần MLP và các phép chiếu của ViT chỉ tăng theo , tức gấp 4, nên tổng thời gian tăng ít hơn 16 lần. Thời gian thật còn phụ thuộc cách cài và bộ nhớ activation, vì vậy ước lượng trước rồi đo.
ViT pretrained có thể là baseline mạnh khi có checkpoint và preprocessing phù hợp. Train ViT lớn từ đầu trên 60 ảnh bàn học khó kiểm soát hơn một baseline nhỏ. Patch quá lớn có thể làm chữ rất nhỏ bị gộp; patch quá nhỏ tăng chi phí. Chọn theo đối tượng, dữ liệu và ngân sách, rồi so trên cùng split.
Đổi độ phân giải khi fine-tune
Bài báo ViT fine-tune ở độ phân giải cao hơn lúc pretrain, giữ nguyên patch size, và nội suy 2D bảng vị trí theo vị trí của patch trong ảnh gốc. Các bước:
- Tách vector CLS.
- Đưa vector còn lại về lưới .
- Nội suy lưới sang kích thước mới.
- Trải lại rồi ghép CLS vào đầu.
Để thấy hình học được giữ, ta dùng một bảng vị trí tự đặt, trong đó vector của mỗi patch chính là (hàng, cột) của nó, còn CLS là :
import torch.nn.functional as F

def resize_position_table(table, old_grid, new_grid):
    cls_part, grid_part = table[:, :1], table[:, 1:]
    dim = table.shape[-1]
    grid = grid_part.reshape(1, old_grid, old_grid, dim).permute(0, 3, 1, 2)
    grid = F.interpolate(grid, size=(new_grid, new_grid),
                         mode="bilinear", align_corners=True)
    grid_part = grid.permute(0, 2, 3, 1).reshape(1, new_grid * new_grid, dim)
    return torch.cat([cls_part, grid_part], dim=1)

rows, cols = torch.meshgrid(torch.arange(4.0), torch.arange(4.0), indexing="ij")
coords = torch.stack([rows, cols], dim=-1).reshape(1, 16, 2)
table = torch.cat([torch.full((1, 1, 2), -1.0), coords], dim=1)
resized = resize_position_table(table, old_grid=4, new_grid=7)
print(tuple(table.shape), "->", tuple(resized.shape))
print("CLS:", resized[0, 0].tolist())
print("row of first column:", resized[0, 1:, 0].reshape(7, 7)[:, 0].tolist())
(1, 17, 2) -> (1, 50, 2)
CLS: [-1.0, -1.0]
row of first column: [0.0, 0.5, 1.0, 1.5, 2.0, 2.5, 3.0]
Bảng đi từ 17 lên 50 vector, tức CLS cộng lưới . CLS giữ nguyên , còn tọa độ hàng ở cột đầu chạy đều từ 0 đến 3: mỗi vị trí mới nhận vector của đúng chỗ tương ứng trên lưới cũ. Ví dụ dùng bilinear để số dễ đọc; thư viện thường dùng bicubic. Sau khi nội suy vẫn cần fine-tune ở độ phân giải mới, vì bảng chỉ là điểm xuất phát hợp lý.
Hỏi nhanh
Checkpoint ViT-B/16 train ở có bảng vị trí shape (1, 197, 768). Bây giờ fine-tune ở , vẫn giữ patch 16. Bảng mới cần bao nhiêu vector?
Lưới mới có patch, cộng CLS thành 577. 576 là quên CLS. 337 đến từ , tức phóng theo cạnh ảnh thay vì theo số ô của lưới. Giữ 197 chỉ đúng khi resize ảnh về 224, mà như vậy thì mất lợi ích của độ phân giải cao.
Khi đi thi
- Đếm token trước khi tăng độ phân giải: attention tốn ô mỗi head, mỗi lớp.
- Đọc cấu hình checkpoint: patch size, độ phân giải lúc train, mean/std của processor.
- Ít dữ liệu và không có pretrained thì thử CNN nhỏ trước ViT.
Tóm tắt
- ViT cắt ảnh thành patch, biến mỗi patch thành token bằng một phép chiếu dùng chung, thêm vị trí rồi đưa qua Transformer.
- Thiếu thông tin vị trí, model không phân biệt được các bố cục của cùng một tập patch; đổi độ phân giải thì bảng vị trí phải nội suy 2D.
- Class token là một cách tổng hợp cả ảnh; mean pooling là cách khác.
- Attention nối mọi patch ngay từ lớp đầu, nhưng chi phí tăng bậc hai theo số token, và ViT cần nhiều dữ liệu hơn CNN.
Kiểm tra cuối bài
Câu 1
Một đề vật lý cho mỗi mẫu một tensor shape (64, 64, 2), là hai thành phần của một trường vector đo trên lưới . Một đội dùng ViT patch có class token. Chuỗi vào encoder dài bao nhiêu, và mỗi patch thô dài bao nhiêu số?
Lưới có patch, thêm class token thành 65. Dữ liệu có hai kênh, nên mỗi patch có số. 192 là thói quen nhân với ba kênh RGB. Dữ liệu để kênh ở trục cuối, nên trước Conv2d còn phải permute về (2, 64, 64).
Câu 2
ViT đọc ảnh như một chuỗi patch. Một đội muốn giữ mọi chi tiết, nên cho mỗi pixel của ảnh thành một token. So với patch , tức 196 token, ma trận attention của mỗi head ở mỗi lớp có số ô tăng bao nhiêu lần?
Số token tăng từ 196 lên , tức lần. Ma trận token nhân token tăng lần, thành khoảng ô, cỡ 10 GB float32 cho một head, một lớp, một ảnh. 16 chỉ là tỉ lệ cạnh patch. 256 là tỉ lệ số token, quên rằng ma trận có hai chiều token. Ma trận attention có kích thước , không phải . Gom pixel thành patch chính là cách ViT rút chuỗi xuống độ dài chịu được.
Câu 3
Ảnh được đưa thẳng vào nn.Conv2d(3, 768, kernel_size=16, stride=16), không padding. Kết quả ra sao?
Mỗi chiều có vị trí, phủ pixel. 6 hàng dưới và 6 cột phải không nằm trong cửa sổ nào. Conv2d không báo lỗi và không tự padding. Kernel cố định , nên cũng không gộp được phần dư. Lỗi im lặng này làm mất viền ảnh, nên cần resize, crop hoặc pad có chủ đích, và in shape của lưới token ra để kiểm.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.2(b)
Câu 4
Encoder ViT-B/16 chạy trên ảnh 224 trả về out shape (1, 197, 768), trong đó token 0 là CLS. Head segmentation cần feature map shape (1, 768, 14, 14). Dòng nào đúng?
Phải bỏ CLS, đưa trục lên vị trí kênh, rồi mới tách 196 token thành lưới theo hàng. out.reshape(...) báo lỗi, vì số không xếp được thành . out[:, 1:].reshape(...) chạy được, nhưng đọc dữ liệu theo token trước, nên mỗi “kênh” là một đoạn 196 số cắt ngang nhiều token. Shape đúng mà nội dung bị trộn. out[:, :196] giữ CLS và bỏ patch cuối, nên mọi vị trí lệch một ô.
Câu 5
Một ViT patch 16 trên ảnh bị quên cộng position embedding. Head đọc output của CLS, model chạy ở eval(). Ta thử hai phép tráo. Phép (i) cắt tại pixel 112 theo cả hai chiều, rồi đổi chỗ khối trên trái với khối dưới phải. Phép (ii) đổi chỗ dải dọc cột 0-99 với dải cột 100-199. Logits sau mỗi phép so với ảnh gốc thế nào?
, nên đường cắt trùng ranh giới patch, và phép (i) chỉ hoán vị các patch nguyên vẹn. Không có vị trí thì attention và MLP xử lý các token như một tập hợp, và CLS đọc tập ấy, nên logits giống ảnh gốc, chỉ khác ở mức làm tròn số thực. 100 và 200 không chia hết cho 16. Các patch vắt qua đường cắt nhận một tổ hợp pixel mới, nên tập token đổi và logits có thể khác. Model như vậy không phân biệt được ảnh với bản xếp lại theo lưới patch. Đây là một phép thử nhanh để phát hiện quên position embedding.
Câu 6
Checkpoint có bảng vị trí (1, 197, 768), gồm CLS rồi lưới đánh số theo hàng. Để chạy ảnh 384, một bạn nội suy tuyến tính 1D cả chuỗi 197 vector thành 577 vector. Cách này sai ở đâu?
Trong chuỗi 1D, ngay sau patch 13 ở mép phải hàng 0 là patch 14 ở mép trái hàng 1. Nội suy vì vậy tạo ra vector pha trộn hai mép đối diện, và vector CLS cũng bị kéo vào các vị trí đầu. Khi trải 576 vector thành lưới , hàng mới không ứng với hàng cũ, nên sai cả ở giữa chứ không riêng viền. Fine-tune có thể sửa dần, nhưng bỏ phí cấu trúc vị trí đã pretrain. Cách đúng là tách CLS ra rồi nội suy 2D trên lưới, như hàm resize_position_table.
Câu 7
Ảnh RGB . Để giữ nét nhỏ, ta đổi patch từ 16 xuống 8 và giữ nguyên mọi thứ khác. Điều nào đúng?
token. Ma trận attention tăng lần. Mỗi patch còn số. Patch size đóng vai stride của patch embedding: stride nhỏ thì có nhiều vị trí hơn, giữ chi tiết mịn hơn nhưng tốn tính toán hơn. 392 là chia đôi theo một chiều thay vì cả hai. Gấp 4 là quên rằng attention tăng theo bình phương số token.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.1(b)
Câu 8
Ảnh gốc có vết nứt rộng khoảng 3 pixel. Pipeline resize ảnh về rồi đưa vào ViT-B/16 pretrained, và recall với vết nứt thấp. Thay đổi nào nhắm đúng nguyên nhân?
Resize thu mỗi cạnh khoảng lần, nên vết nứt 3 pixel chỉ còn khoảng 0.3 pixel. Thông tin đã mất trước khi vào model, nên tăng hay thêm head không lấy lại được, còn patch 32 thì gộp còn thô hơn. Cắt thành ô giữ vết nứt gần như nguyên độ rộng. Đổi lại, số lần chạy model tăng 64 lần, nên cần ước lượng thời gian trước khi chọn.
Câu 9
Trên cùng validation, CNN pretrained đạt macro-F1 0.91 và chạy 40 ms mỗi ảnh. ViT pretrained đạt 0.92 và chạy 160 ms mỗi ảnh, cùng CPU và đã chọn batch tốt nhất. Tập test có ảnh, giới hạn chạy dự đoán là 30 phút, quá giờ thì 0 điểm. Nên chọn model nào?
ViT cần giây, khoảng 53 phút, vượt giới hạn. CNN cần 800 giây, khoảng 13 phút. Ensemble phải chạy cả hai, mất khoảng 67 phút. Nộp thiếu nửa test thì nửa còn lại bị chấm sai. Chênh 0.01 F1 trên validation thường vẫn nằm trong nhiễu. Muốn dùng ViT thì phải giảm chi phí trước, như dùng ảnh nhỏ hơn hay model nhỏ hơn, rồi đo lại.
Câu 10
Một đội giữ tỉ lệ khung hình của ảnh. Ảnh A cho 196 patch, ảnh B cho 280 patch. Để chạy chung một batch qua encoder, đội nối thêm 84 vector 0 vào cuối chuỗi token của A. Còn thiếu gì?
Token đệm không hề trung tính. Sau LayerNorm và các phép chiếu, key và value của nó khác 0. Kể cả khi điểm bằng 0 thì vẫn chia trọng số cho nó. Vì vậy output của A phụ thuộc vào việc A được ghép batch với ảnh nào. Key padding mask loại các key đệm khỏi softmax, giống cách xử lý câu dài ngắn khác nhau ở bài 3.9. Cắt B về 196 token là bỏ 84 patch bên phải ảnh. Đặt token đệm ở đầu hay ở cuối thì chúng vẫn bị đọc. Mỗi ảnh còn cần bảng vị trí theo đúng lưới của nó: cho A, cho B.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q2.2
Đọc thêm
- Dosovitskiy và cộng sự - An Image is Worth 16×16 Words: xem kiến trúc patch, class token và điều kiện pretraining của nghiên cứu.
- PyTorch - TransformerEncoderLayer: đối chiếu
batch_first,nheadvà dropout. - Dive into Deep Learning - Transformers for Vision: đọc đường từ ảnh đến encoder sau khi đã kiểm patch bằng tay.