Quay lại bài toán định giá căn hộ ở bài 2.1. Lần này bảng dữ liệu rộng hơn: ngoài diện tích và khoảng cách tới trung tâm còn 30 cột khác, kiểu như số chữ cái trong tên chủ nhà hay ngày trong tuần lúc đăng tin, không cột nào liên quan tới giá. Trong khi đó chỉ có 40 căn để học. Linear regression khớp 40 căn này gần như hoàn hảo, nhưng đoán căn mới thì sai nhiều: nó học thuộc 40 căn chứ không học được cách định giá. Regularization sửa việc này bằng cách phạt trọng số lớn: model vẫn phải khớp dữ liệu, nhưng trọng số càng lớn thì loss càng tăng.
Khi mô hình học thuộc
Dữ liệu sinh theo đúng công thức của bài 2.1, chỉ thêm 30 cột ngẫu nhiên không liên quan gì đến giá. 40 căn đầu dùng để học, 60 căn còn lại để kiểm tra. Đặc trưng được chuẩn hóa bằng trung bình và độ lệch chuẩn của tập train, như bài 2.1 đã dặn.
import numpy as np

rng = np.random.default_rng(1)
n, k = 100, 30
area = rng.uniform(30, 120, n)
dist = rng.uniform(1, 15, n)
junk = rng.normal(size=(n, k))                       # 30 cột không liên quan đến giá
y = 0.05 * area - 0.15 * dist + 1.0 + rng.normal(0, 0.4, n)

X = np.column_stack([area, dist, junk])              # (100, 32)
X_tr, X_te, y_tr, y_te = X[:40], X[40:], y[:40], y[40:]
mu, sigma = X_tr.mean(axis=0), X_tr.std(axis=0)
A_tr, A_te = (X_tr - mu) / sigma, (X_te - mu) / sigma
print(A_tr.shape, A_te.shape)
(40, 32) (60, 32)
Dùng của bài 2.1 để chấm, và giải least squares như cũ:
def r2(y_hat, y):
    return 1 - np.mean((y_hat - y) ** 2) / np.var(y)

def fit_ols(A, y):
    Ab = np.column_stack([A, np.ones(len(A))])
    theta = np.linalg.lstsq(Ab, y, rcond=None)[0]
    return theta[:-1], theta[-1]

w, b = fit_ols(A_tr, y_tr)
print("R2 train:", round(r2(A_tr @ w + b, y_tr), 3), " R2 test:", round(r2(A_te @ w + b, y_te), 3))
print("2 hệ số thật:", w[:2].round(2), " |hệ số rác| lớn nhất:", np.abs(w[2:]).max().round(2))
R2 train: 0.985 R2 test: 0.349
2 hệ số thật: [ 1.15 -0.79] |hệ số rác| lớn nhất: 0.44
Điểm train , điểm test . Khoảng cách lớn như vậy là dấu hiệu kinh điển của overfitting (bài 1.2). Nhìn vào hệ số sẽ thấy vì sao: những cột rác, vốn phải có hệ số 0, lại nhận trọng số tới , cỡ một nửa hệ số của khoảng cách. Với 33 tham số và chỉ 40 căn, mô hình luôn tìm được cách dùng các cột rác để khớp nốt phần nhiễu của tập train. Những khớp đó hoàn toàn ngẫu nhiên, nên sang tập test thì chúng gây hại.
Hỏi nhanh
Giữ nguyên 40 căn train, nhưng tăng số cột rác từ 30 lên 37. Khi đó có 39 hệ số cộng thêm bias, tức là 40 ẩn cho 40 căn. Không cần chạy code, trên train của least squares sẽ là bao nhiêu?
Có 40 phương trình và 40 ẩn, ma trận lại sinh ngẫu nhiên nên gần như chắc chắn khả nghịch. Hệ có nghiệm khớp đúng từng căn, giống khử Gauss cho một hệ vuông. Least squares cũng không bao giờ làm điểm train tệ đi khi thêm cột, vì luôn có thể cho hệ số của cột mới bằng 0. Điểm train hoàn hảo ở đây chỉ cho biết mô hình đủ chỗ để học thuộc.
Phạt độ lớn trọng số
Ý tưởng: thay vì chỉ cực tiểu lỗi, ta cực tiểu lỗi cộng thêm một khoản phạt cho trọng số lớn:
Vì sao trọng số lớn đáng bị phạt? Khi các đặc trưng cùng thang đo, trọng số lớn nghĩa là dự đoán thay đổi mạnh khi đặc trưng thay đổi một chút. Một mô hình như vậy rất nhạy với những dao động ngẫu nhiên trong dữ liệu, tức variance cao. Khoản phạt buộc mô hình chỉ dùng trọng số lớn khi việc đó giảm lỗi đủ nhiều để bù lại. Điều kiện “cùng thang đo” không phải chi tiết phụ; mục chuẩn hóa ở cuối bài sẽ cho thấy bỏ qua nó thì chuyện gì xảy ra.
Hệ số là núm vặn. trả về least squares thường. rất lớn thì mọi trọng số bị ép về 0 và mô hình chỉ còn đoán giá trị trung bình. Ở giữa là điểm cân bằng giữa bias và variance mà ta sẽ tìm bằng validation. Phạt quá tay thì cả train lẫn validation cùng tụt: mô hình chưa khớp. Với cùng dữ liệu, giá trị nhỏ nhất của lỗi cộng phạt không thể giảm khi tăng, vì với mọi khoản phạt chỉ lớn thêm.
Hai lựa chọn phổ biến nhất cho :
| Ridge (L2) | Lasso (L1) | |
|---|---|---|
| Khoản phạt | ||
| Tác dụng | Co mọi trọng số về gần 0 | Đưa nhiều trọng số về đúng 0 |
| Hợp khi | Nhiều đặc trưng cùng có ích, có tương quan | Chỉ ít đặc trưng thật sự quan trọng |
Bias không bị phạt. Nó chỉ dời toàn bộ dự đoán lên hoặc xuống cho khớp mức giá trung bình; phạt sẽ kéo mọi dự đoán về 0 dù dữ liệu nói gì.
Hỏi nhanh
Ridge có intercept không bị phạt. Giữ nguyên dữ liệu train và tăng mức phạt lên rất lớn. Dự đoán sẽ tiến dần về giá trị nào?
Các hệ số của feature bị co về 0, chỉ còn lại intercept. Hằng số làm tổng bình phương lỗi nhỏ nhất là trung bình, không phải trung vị hay giá trị hay gặp nhất. Đáp án 0 chỉ đúng nếu intercept cũng bị phạt.
Ridge
Với khoản phạt L2, đạo hàm của là , nên nghiệm đóng chỉ thêm đúng một số hạng so với bài 2.1. Để không phạt , ta trừ trung bình khỏi các cột của và khỏi trước (gọi là , ), giải , rồi lấy :
Số hạng cộng vào mọi trị riêng của , nên ma trận luôn khả nghịch khi . Ridge vì vậy chữa luôn chuyện đa cộng tuyến ở bài 2.1: khi hai đặc trưng gần như trùng nhau, least squares có thể cho và , còn Ridge chia đều thành kiểu và .
def fit_ridge(A, y, lam):
    a_mean, y_mean = A.mean(axis=0), y.mean()
    Ac, yc = A - a_mean, y - y_mean
    w = np.linalg.solve(Ac.T @ Ac + lam * np.eye(A.shape[1]), Ac.T @ yc)
    return w, y_mean - a_mean @ w

from sklearn.linear_model import Ridge
w, b = fit_ridge(A_tr, y_tr, 3.0)
model = Ridge(alpha=3.0).fit(A_tr, y_tr)
print(np.allclose(w, model.coef_), np.allclose(b, model.intercept_))
True True
Hàm mất mát của Ridge trong scikit-learn đúng bằng ở trên, với alpha chính là , nên hai kết quả trùng nhau.
Hỏi nhanh
Lấy nghiệm Ridge với làm điểm xuất phát, rồi chạy gradient descent của bài 2.1 trên tổng bình phương lỗi không có khoản phạt, với bước nhỏ và chạy đủ lâu. Trọng số sẽ đi về đâu?
Tại nghiệm Ridge, gradient của riêng phần lỗi bằng , khác 0, nên gradient descent vẫn đi tiếp. Phần lỗi là hàm lồi, và ở đây khả nghịch, nên nó dừng ở cực tiểu duy nhất của phần lỗi, chính là nghiệm least squares. Muốn trọng số đứng yên ở nghiệm Ridge thì phải chạy gradient descent trên có cả khoản phạt.
Giờ thử nhiều mức phạt:
for lam in [0, 0.1, 1, 3, 10, 30, 100]:
    w, b = fit_ridge(A_tr, y_tr, lam)
    print(f"lambda = {lam:>5}: R2 train = {r2(A_tr @ w + b, y_tr):.3f}   R2 test = {r2(A_te @ w + b, y_te):.3f}")
lambda = 0: R2 train = 0.985 R2 test = 0.349
lambda = 0.1: R2 train = 0.985 R2 test = 0.644
lambda = 1: R2 train = 0.982 R2 test = 0.839
lambda = 3: R2 train = 0.974 R2 test = 0.839
lambda = 10: R2 train = 0.934 R2 test = 0.764
lambda = 30: R2 train = 0.814 R2 test = 0.603
lambda = 100: R2 train = 0.547 R2 test = 0.356
Đây là bias-variance trên một bảng số. Tăng thì điểm train luôn giảm, vì mô hình bị trói tay. Điểm test thì tăng rồi giảm: lúc đầu khoản phạt dập tắt các hệ số rác (giảm variance), về sau nó dập luôn cả hai hệ số thật (tăng bias). Đỉnh nằm quanh từ 1 đến 3, nâng test từ lên .
Hỏi nhanh
Ở dòng của bảng, trên train là , trên test là . Mô hình đang gặp vấn đề gì?
Khoảng cách giữa train và test nhỏ lại chưa có nghĩa là mô hình tốt, vì chính điểm train đã thấp. Phạt mạnh co cả hai hệ số thật về gần 0, nên mô hình quá đơn giản so với quy luật. Đó là underfitting.
Lasso
Ridge co mọi hệ số về phía 0 nhưng gần như không bao giờ đưa hệ số nào về đúng 0. Lasso dùng khoản phạt thì làm được. Mấu chốt nằm ở góc nhọn của tại 0; cũng vì góc nhọn đó mà Lasso không có nghiệm đóng.
Có hai cách nhìn vì sao. Cách thứ nhất là hình học: bài toán có phạt tương đương với cực tiểu lỗi trong một vùng ràng buộc . Vùng L2 là hình tròn, vùng L1 là hình thoi có góc nằm trên các trục. Các đường đồng mức của lỗi là những elip lan dần ra từ nghiệm least squares, và lần đầu chạm hình thoi thường là ở một góc, nơi có một tọa độ bằng 0.
Cách thứ hai là tính thẳng trong trường hợp đơn giản nhất: các cột của trực chuẩn (), và là hệ số least squares. Từ đây đến hết bài, Lasso được viết với hệ số trước phần lỗi, , để công thức gọn; Ridge vẫn dùng như trên. Khi đó mỗi trọng số được tính riêng:
Ridge co mọi hệ số theo cùng một tỉ lệ. Lasso trừ đi một lượng cố định rồi cắt về 0; phép biến đổi này gọi là soft-thresholding. Hệ số nào có độ lớn dưới biến mất hoàn toàn.
Lấy và . Ridge cho : mọi hệ số giảm một nửa, không hệ số nào về 0. Lasso cho : đặc trưng thứ hai bị loại, hai đặc trưng còn lại mỗi cái mất đúng 1 đơn vị độ lớn.
Hỏi nhanh
Lasso dùng hàm , với . Một hệ số least squares bằng , và . Hệ số Lasso tương ứng bằng bao nhiêu?
Soft-thresholding cho . Ra là lấy mà quên cắt về 0; Lasso không bao giờ làm hệ số đổi dấu. Ra 0.4 là dùng quy tắc co theo tỉ lệ của Ridge.
Hỏi nhanh
Vẫn , các cột trực chuẩn. Với Lasso, nhỏ nhất bằng bao nhiêu thì cả ba hệ số đều bằng 0?
Hệ số thứ bằng 0 khi , nên cần . Từ mức ấy trở lên, mô hình chỉ còn intercept, đúng như giới hạn ở đầu bài. Thư viện dùng chính giá trị này làm điểm bắt đầu khi vẽ hệ số theo .
Khi các cột không trực chuẩn, Lasso được giải bằng coordinate descent: lần lượt tối ưu từng trong khi giữ các trọng số khác cố định. Mỗi bước con chính là một phép soft-thresholding như trên. Với dữ liệu đã trừ trung bình, cài đặt chỉ khoảng mười dòng:
def soft(z, t):
    return np.sign(z) * np.maximum(np.abs(z) - t, 0)

def fit_lasso(A, y, lam, sweeps=500):
    a_mean, y_mean = A.mean(axis=0), y.mean()
    Ac, yc = A - a_mean, y - y_mean
    w = np.zeros(A.shape[1])
    col_sq = (Ac ** 2).sum(axis=0)
    for _ in range(sweeps):
        for j in range(len(w)):
            r_j = yc - Ac @ w + Ac[:, j] * w[j]       # phần dư khi bỏ đặc trưng j
            w[j] = soft(Ac[:, j] @ r_j, lam) / col_sq[j]
    return w, y_mean - a_mean @ w

w, b = fit_lasso(A_tr, y_tr, 8.0)
print("giữ lại các cột:", np.nonzero(w)[0], " hệ số:", w[w != 0].round(3))
print("R2 test:", round(r2(A_te @ w + b, y_te), 3))
giữ lại các cột: [0 1] hệ số: [ 1.037 -0.408]
R2 test: 0.891
Với , Lasso giữ lại đúng hai cột đầu là diện tích và khoảng cách, loại cả 30 cột rác. Không ai nói cho nó biết cột nào là rác. Lasso vừa ước lượng vừa chọn đặc trưng (feature selection) trong cùng một bước.
Lasso của scikit-learn dùng hàm mất mát , tức chia hàm của ta cho . Nghiệm không đổi nếu alpha :
from sklearn.linear_model import Lasso
model = Lasso(alpha=8.0 / 40, tol=1e-10, max_iter=100000).fit(A_tr, y_tr)
print(np.allclose(w, model.coef_, atol=1e-6), np.allclose(b, model.intercept_, atol=1e-6))
True True
Chọn λ bằng cross-validation
Ở mục Ridge, ta đã chọn bằng cách nhìn thẳng vào test. Làm vậy để quan sát bias-variance thì được, nhưng con số đó không còn là ước lượng khách quan: chính tập test đã được dùng để chọn. là siêu tham số (hyperparameter). Nó không học được từ tập train, vì trên tập train thì luôn thắng, nên phải chọn bằng cross-validation (bài 1.3) trên một lưới thang log, ví dụ . Tập test chỉ được dùng một lần, ở cuối.
Bước chuẩn hóa cũng học từ dữ liệu (trung bình và độ lệch chuẩn), nên phải được fit lại bên trong từng fold. Cách gọn nhất là gói StandardScaler và mô hình vào một Pipeline, rồi để GridSearchCV dò alpha:
from sklearn.linear_model import Lasso, Ridge
from sklearn.model_selection import GridSearchCV
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

alpha_grid = np.logspace(-3, 3, 13)
for name, estimator in [("Ridge", Ridge()), ("Lasso", Lasso(max_iter=10000))]:
    pipeline = make_pipeline(StandardScaler(), estimator)
    step_name = name.lower()
    search = GridSearchCV(pipeline, {step_name + "__alpha": alpha_grid}, cv=5)
    search.fit(X_tr, y_tr)
    alpha = search.best_params_[step_name + "__alpha"]
    coef = search.best_estimator_[-1].coef_
    print(f"{name}: alpha = {alpha:.4g}  R2 test = {search.score(X_te, y_te):.3f}  "
          f"số hệ số khác 0 = {np.count_nonzero(coef)}")
    print(f"       2 hệ số thật = {coef[:2].round(3)}  |hệ số rác| lớn nhất = {np.abs(coef[2:]).max():.3f}")
Ridge: alpha = 3.162 R2 test = 0.837 số hệ số khác 0 = 32
2 hệ số thật = [ 1.092 -0.504] |hệ số rác| lớn nhất = 0.170
Lasso: alpha = 0.03162 R2 test = 0.925 số hệ số khác 0 = 14
2 hệ số thật = [ 1.234 -0.527] |hệ số rác| lớn nhất = 0.096
Ridge chọn alpha , rơi đúng vào vùng từ 1 đến 3 đã thấy ở bảng trước, nhưng lần này không cần nhìn tập test. Lasso đạt test , cao hơn cả mức của Lasso với , dù vẫn giữ 12 cột rác. So hai dòng hệ số là thấy lý do. Với , Lasso loại sạch rác nhưng co luôn hai hệ số thật xuống và . Mức phạt nhỏ hơn do CV chọn giữ hai hệ số thật ở và , còn các cột rác sống sót chỉ có hệ số nhỏ hơn và gây hại không đáng kể. Cross-validation tối ưu điểm dự đoán; nó không cam kết tìm đúng tập đặc trưng thật.
Hỏi nhanh
Lasso với loại sạch 30 cột rác, còn Lasso do cross-validation chọn vẫn giữ 12 cột rác. Vậy mà bản thứ hai lại dự đoán tốt hơn trên test, so với . Vì sao?
Bias do co hệ số thật gây hại nhiều hơn vài hệ số rác nhỏ. Một chung phạt mọi hệ số như nhau, nên không thể vừa ép rác về 0 vừa để yên hệ số thật. Các hệ số rác còn lại đều dưới , còn hai hệ số thật bị co từ khoảng xuống và từ xuống . Cross-validation cũng không hề thấy tập test, nó chỉ chia tập train thành các fold.
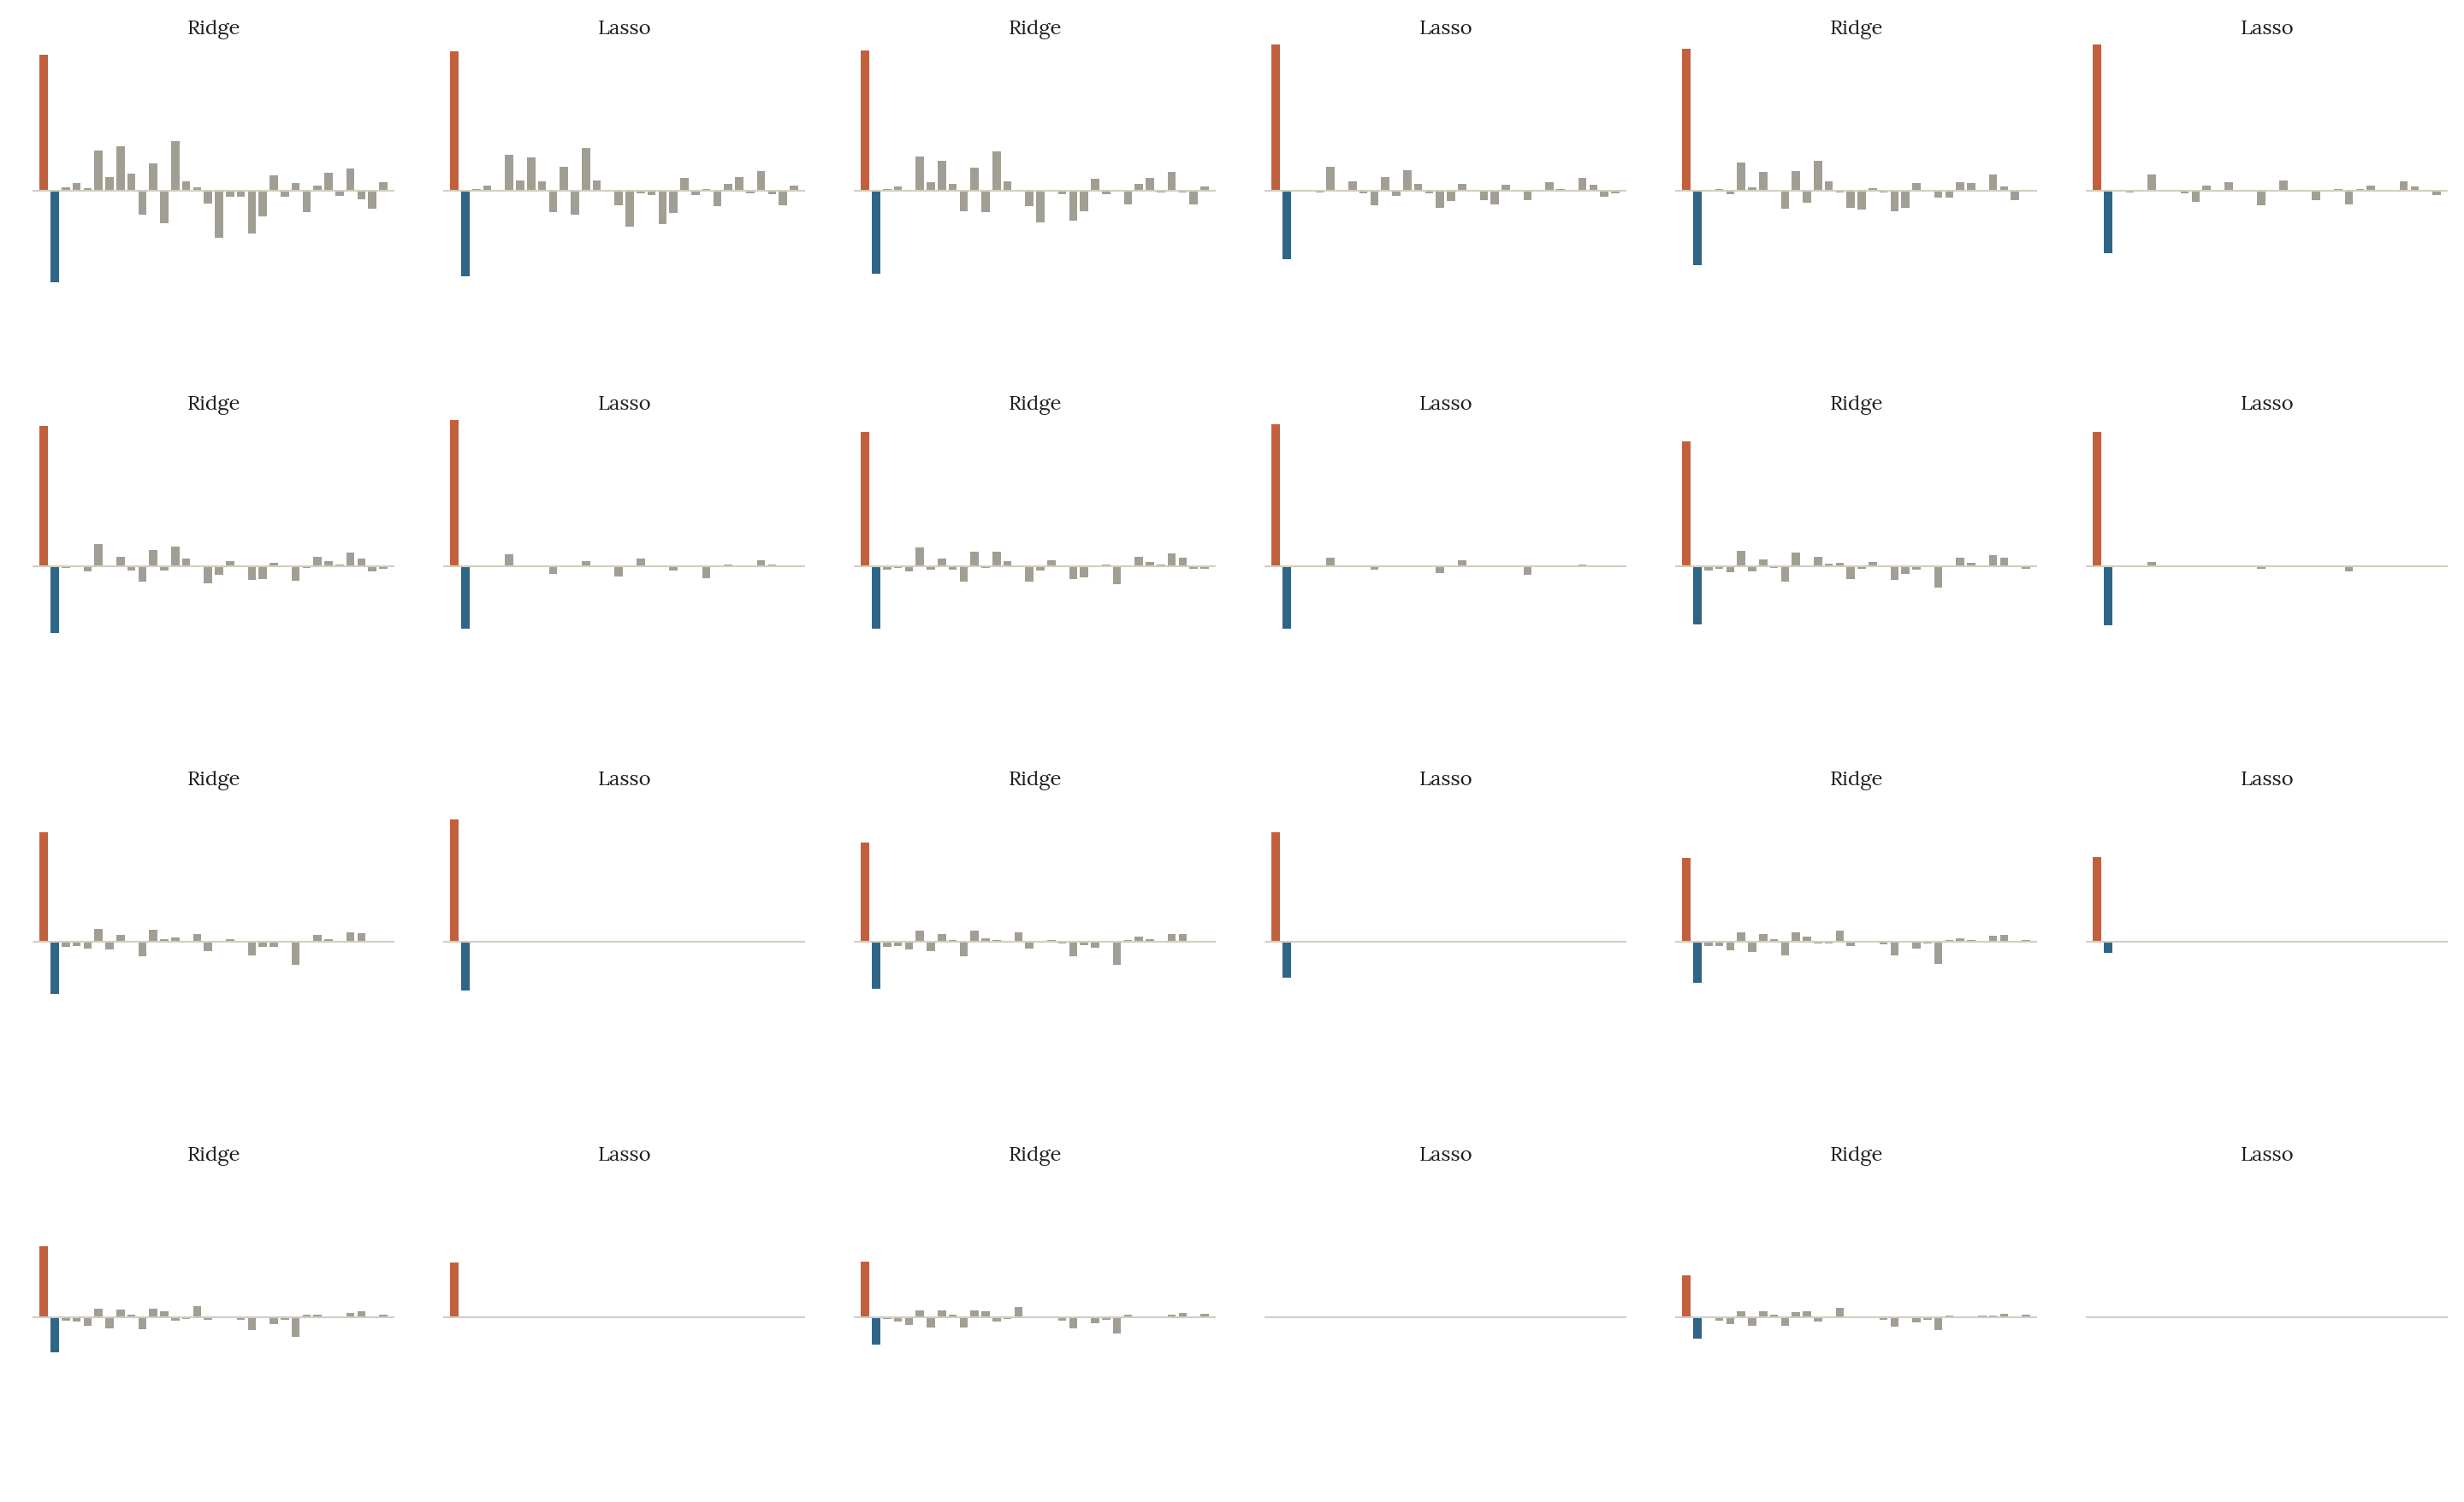
Vẽ các hệ số theo (regularization path) sẽ thấy rõ quá trình chọn lọc: khi phạt tăng, các cột rác rơi về 0 trước, hai cột thật trụ lại lâu nhất.
Chuẩn hóa trước khi phạt
Khoản phạt tính trên độ lớn trọng số, mà độ lớn trọng số phụ thuộc đơn vị đo. Đổi khoảng cách từ km sang m (nhân 1000) thì hệ số của nó nhỏ đi 1000 lần để giữ nguyên dự đoán, và khoản phạt nhỏ đi lần. Cùng một , đặc trưng đó gần như không còn bị phạt. Thử với Ridge trên hai đặc trưng thật, chưa chuẩn hóa:
B = X_tr[:, :2]                                     # diện tích (m²), khoảng cách (km)
for unit, scale in [("km", 1), ("m", 1000)]:
    M = B * np.array([1, scale])                     # khoảng cách đo bằng km hoặc bằng m
    m = Ridge(alpha=1000).fit(M, y_tr)
    print(f"khoảng cách theo {unit:>2}: hệ số quy về mỗi km = {m.coef_[1] * scale:.3f}")
khoảng cách theo km: hệ số quy về mỗi km = -0.058
khoảng cách theo m: hệ số quy về mỗi km = -0.175
Cùng dữ liệu, cùng , chỉ đổi đơn vị. Tính theo km thì hệ số khoảng cách bị ép mạnh về phía 0; tính theo m thì nó gần như không bị phạt, cho đúng hệ số của linear regression không phạt trên 40 căn này (). Mức phạt mà mỗi đặc trưng phải chịu phụ thuộc vào đơn vị của nó, không phụ thuộc vào việc nó quan trọng đến đâu. Chuẩn hóa đưa mọi đặc trưng về cùng thang đo để khoản phạt công bằng.
Hỏi nhanh
Đổi một feature từ km sang m mà vẫn giữ nguyên dự đoán, thì hệ số của feature ấy giảm 1000 lần. Nếu giữ nguyên , khoản phạt L2 trên riêng hệ số này thay đổi thế nào?
L2 phạt bình phương của hệ số: . Với L1, khoản phạt chỉ giảm 1000 lần, nhưng kết luận vẫn thế: không chuẩn hóa thì mức phạt phụ thuộc vào đơn vị.
Elastic Net
Khi nhiều đặc trưng tương quan mạnh với nhau, Lasso có xu hướng giữ một cái và bỏ các cái còn lại, khá tùy ý. Elastic Net trộn hai khoản phạt, với , nên vẫn thưa nhưng giữ được cả nhóm đặc trưng tương quan. là Lasso, là Ridge. Trong scikit-learn, là l1_ratio.
Hỏi nhanh
Có ba cột gần trùng nhau, cùng đo một thứ và cùng có ích, cộng thêm vài cột nhiễu. Elastic Net với l1_ratio=0.5 thường làm gì với ba cột ấy?
Phần L2 ưu tiên chia đều, giống Ridge với hai cột trùng nhau, còn phần L1 vẫn đưa các cột nhiễu về 0. Thử với ba cột gần trùng và ba cột nhiễu, Elastic Net cho khoảng , , ở ba cột trùng và gần 0 ở các cột nhiễu. Phạt chỉ co hệ số lại, không làm chúng lớn hơn least squares.
Regularization ở khắp nơi
Ý tưởng “lỗi cộng phạt” xuất hiện trong gần như mọi mô hình của khóa học:
Ctrong logistic regression (bài 2.3) và SVM (bài 2.8).- Độ sâu tối đa và số mẫu tối thiểu ở lá của decision tree (bài 2.5).
- Phạt L1, L2 trên giá trị lá trong XGBoost và LightGBM (bài 2.7).
- Weight decay, dropout, early stopping trong mạng neural (bài 3.6).
Hỏi nhanh
So LogisticRegression(C=0.01) với LogisticRegression(C=100). Khác nhau thế nào?
C tỉ lệ nghịch với . C nhỏ ứng với lớn, tức là phạt mạnh. Ai đã quen alpha của Ridge rất dễ đọc ngược chiều.
Khi đi thi
- Dò
alphahoặcCtrên thang log: 0.01, 0.1, 1, 10. - Đặt chuẩn hóa và model trong cùng Pipeline để cross-validation chuẩn hóa đúng trên từng fold.
- Nghi có nhiều cột rác thì chạy Lasso xem cột nào còn lại.
Tóm tắt
- Regularization cực tiểu lỗi cộng phạt độ lớn trọng số; điều khiển cân bằng bias-variance. Bias không bị phạt.
- Ridge (L2) có nghiệm đóng , co mọi hệ số về phía 0 và giữ nghiệm ổn định khi đặc trưng tương quan.
- Lasso (L1) cắt hệ số nhỏ về đúng 0 bằng soft-thresholding, nên chọn được đặc trưng; cái giá là hệ số thật cũng bị co.
- Chuẩn hóa trước khi phạt; chọn bằng cross-validation trên lưới log, không bằng tập test; để ý thang đo của
alphavà chiều ngược củaC.
Kiểm tra cuối bài
Mười câu dưới đây bao quát cả bài. Làm hết rồi xem điểm; câu nào sai thì đọc lại mục tương ứng.
Câu 1
Ridge cho train nhưng validation chỉ . Ta nghi mô hình đang overfit. Thí nghiệm nào kiểm điều đó hợp lý nhất?
Nếu đúng là overfit, tăng sẽ làm điểm train giảm và điểm validation tăng, ít nhất trong một khoảng nào đó. Giảm là đi ngược hướng. Chấm nhiều lần trên test thì test thành validation. Còn khoản phạt thì có phụ thuộc thang đo.
Câu 2
Xét Ridge với , và . Một tọa độ của bằng 4, và . Hệ số tương ứng bằng bao nhiêu?
Điều kiện tối ưu là , nên . Ra 3 là áp nhầm soft-thresholding của Lasso.
Câu 3
Với Lasso , , tọa độ và . Hệ số tối ưu bằng bao nhiêu?
Soft-thresholding cho : độ lớn giảm đúng , dấu giữ nguyên. Ra là chia cho , quy tắc của Ridge.
Câu 4
Trên cùng một bộ dữ liệu, ta học hai mô hình hồi quy tuyến tính với cùng mức phạt . Mô hình A phạt L1, mô hình B phạt L2. Điều gì nhiều khả năng xảy ra nhất?
L1 cắt các hệ số nhỏ về đúng 0, còn L2 chỉ co chúng lại. Phương án cuối là cái bẫy của chữ “nhiều khả năng”: từng trường hợp cụ thể có thể khác, nhưng xu hướng thì rõ.
Câu 5
Một bộ dữ liệu y khoa có 50 bệnh nhân, mỗi người đo 100 chỉ số. Một mô hình phân loại tuyến tính đúng 98% trên train, tức 49/50, nhưng chỉ đúng 62% trên validation, và gần như mọi trọng số đều khác 0. Đâu là chẩn đoán đúng nhất?
Đây là câu hỏi “37 cột rác” ở đầu bài, phiên bản phân loại: số tham số nhiều hơn số mẫu thì điểm train gần như hoàn hảo dù không học được gì. Underfitting, lệch lớp hay không hội tụ đều kéo cả điểm train xuống, trái với 98% ở đây. Cách chữa tự nhiên là phạt L1 hoặc L2 và chọn mức phạt bằng cross-validation. Nếu nghi chỉ vài chỉ số thật sự quan trọng, nên thử L1 trước.
Câu 6
Hai feature gần như trùng nhau. Linear regression thường cho hai hệ số kiểu và . Ridge thì thường cho kết quả nào?
Ridge chia đều phần đóng góp, vì với cùng tổng , cặp chia đều cho nhỏ nhất. Nhờ vậy Ridge ổn định khi các feature tương quan với nhau. Khoản phạt cũng làm khả nghịch, nên lúc nào cũng giải được. Đưa hẳn một hệ số về 0 là kiểu của Lasso.
Câu 7
Một bạn học Ridge, thử = 0.01, 0.1, 1, 10, so lỗi trên train, validation và test, rồi chọn vì lỗi test thấp nhất. Thấy lỗi test tăng dần từ đến 10, bạn ấy định thử thêm = 0.0001 và 0.001 để tìm mô hình tốt hơn. Nhận xét nào đúng nhất?
Mở rộng vùng thử không sai, cái sai là thước đo dùng để chọn. Dùng lỗi test để chọn thì điểm test không còn khách quan. Tập test chỉ dùng để báo cáo một lần ở cuối; đã dùng nó để chọn thì nó thành validation.
Câu 8
Ta dùng hàm mất mát với mẫu và . Muốn Lasso của scikit-learn cho cùng kết quả, phải đặt alpha bằng bao nhiêu?
scikit-learn dùng . Chia cả hàm mất mát cho không làm đổi nghiệm, nên . Ra là quên rằng hệ số đã có sẵn ở cả hai bên.
Câu 9
Một đội đã giải nhiều bài cùng dạng và thấy trọng số tốt nhất thường nằm gần . Bài mới chỉ có rất ít dữ liệu. Hàm mục tiêu nào tận dụng kinh nghiệm ấy hợp lý nhất?
Ridge kéo trọng số về 0 vì ngầm giả định trọng số phân bố quanh 0, như góc nhìn xác suất ở mục “Regularization ở khắp nơi”. Ở đây kinh nghiệm cho ta một điểm neo khác, nên phạt khoảng cách tới . lớn thì nghiệm bám sát , nhỏ thì dữ liệu quyết định. Phạt L1 hay L2 thông thường đều kéo về 0, sai hướng. Bỏ hẳn khoản phạt thì với rất ít dữ liệu, mô hình dễ học thuộc.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q4(e)
Câu 10
Khi nào nên chọn Elastic Net thay cho Lasso?
Trong một nhóm feature tương quan, Lasso hay giữ một cái và bỏ các cái còn lại. Phần L2 của Elastic Net giữ được cả nhóm. Elastic Net vẫn cần chuẩn hóa, và vẫn không có nghiệm đóng.
Đọc thêm
- James, Witten, Hastie, Tibshirani - An Introduction to Statistical Learning, chương 6. Ridge, Lasso và cách chọn , viết dễ đọc, có lab Python.
- Hastie, Tibshirani, Friedman - The Elements of Statistical Learning, mục 3.4. Phân tích sâu hơn về shrinkage, regularization path và các bậc tự do hiệu dụng.
- Hastie, Tibshirani, Wainwright - Statistical Learning with Sparsity, chương 2. Toàn bộ về Lasso và các biến thể; dành cho ai muốn đi sâu.
- Friedman, Hastie, Tibshirani - Regularization Paths for Generalized Linear Models via Coordinate Descent, Journal of Statistical Software (2010). Thuật toán coordinate descent đứng sau hầu hết thư viện Lasso.
- Zhang và cộng sự - Dive into Deep Learning, mục Weight Decay. Phạt L2 nhìn từ phía mạng neural; cầu nối sang bài 3.6.
- Tài liệu chính thức: scikit-learn - Linear Models, các mục Ridge, Lasso, Elastic-Net.