Model sinh ảnh (generative model) học từ một tập ảnh rồi tạo ra ảnh mới giống tập đó. Bài này học hai cách tiêu biểu. GAN cho hai mạng thi nhau: một mạng sinh ảnh giả, một mạng phân biệt ảnh thật với ảnh giả. Diffusion học cách khử nhiễu dần, bắt đầu từ một ảnh toàn nhiễu ngẫu nhiên. Cuối bài là cách đánh giá model sinh, vì vài ảnh trông đẹp chưa chứng minh được model sinh tốt.
Sinh mẫu khác với dự đoán nhãn
Classifier ước lượng nhãn theo ảnh. Model sinh cần mô tả sự biến thiên của dữ liệu: những kiểu ảnh nào có thể xuất hiện và xuất hiện với tần suất nào. Nếu luôn trả cùng một ảnh đẹp, model bỏ mất sự đa dạng.
Nói theo xác suất, model phân biệt (discriminative) học , còn model sinh (generative) học chính phân phối dữ liệu , hoặc khi có điều kiện như một câu mô tả, để lấy được mẫu mới. Gõ “con mèo đội mũ len, vẽ màu nước” rồi nhận một bức ảnh mới, như DALL·E hay Stable Diffusion, là sinh ảnh từ văn bản.
Nguồn noise không phải lỗi cần xóa: nó cung cấp biến thiên để cùng một prompt cho nhiều mẫu. Seed cố định dãy số ngẫu nhiên, nên hai seed cho hai noise khác nhau, còn cùng seed trong cùng điều kiện cho lại cùng thí nghiệm. “Cùng điều kiện” gồm cả model, sampler, phiên bản thư viện và phần cứng: đổi một thứ, ảnh có thể khác dù seed giữ nguyên.
Hỏi nhanh
Một đội giữ nguyên seed 7, prompt và model, chỉ đổi sampler, chạy trên cùng một máy. Ảnh ra khác hẳn. Vì sao?
Seed quyết định các số ngẫu nhiên được rút ra, gồm noise ban đầu và noise thêm ở từng bước nếu sampler có dùng. Sampler quyết định dùng các số ấy và dự đoán của model thế nào để đi tới ảnh, kể cả rút ra bao nhiêu số. Đổi sampler là đổi cả quỹ đạo. Seed không bị bỏ qua, máy không tính sai, và sampler là thuật toán dùng chung một model đã train.
GAN: hai mạng có hai mục tiêu
Generator biến noise thành mẫu giả. Discriminator học phân biệt mẫu thật với mẫu do generator tạo. Generator được cập nhật để discriminator đánh giá mẫu giả như thật. Hai mạng thay đổi cùng quá trình, nên mục tiêu mà một mạng thấy cũng đang thay đổi.
Khi dùng, chỉ còn generator chạy: trang web sinh khuôn mặt giả chỉ cần biến noise thành ảnh, còn chỉ có ích lúc train.
Một cách train thông dụng dùng binary cross-entropy. Discriminator muốn nhãn 1 cho thật, 0 cho giả:
Với non-saturating generator loss, generator muốn fake được D chấm 1:
Với , loss này là ; nếu G đẩy được điểm lên 0.8 thì loss còn khoảng 0.223. Phía D, chấm 0.9 cho ảnh thật và 0.2 cho ảnh giả cho loss .
Cách viết minimax nguyên thủy cho G cực tiểu . Hai cách cùng hướng đẩy lên, nhưng khác nhau ở độ lớn gradient. Viết với là logit của fake:
Đầu train, D dễ nhận ra fake nên gần 0. Khi đó cách viết minimax cho gradient gần 0 (bão hòa) và G gần như đứng yên, còn non-saturating cho gradient có độ lớn gần 1. Vì vậy code thực hành dùng , tức BCE với nhãn “thật” cho fake.
Hỏi nhanh
Đầu train, D dễ nhận ra ảnh giả: . Tính theo logit của ảnh giả, độ lớn gradient của , tức loss minimax, và của , tức loss non-saturating, lần lượt là bao nhiêu?
Theo công thức đạo hàm, minimax cho , còn non-saturating cho , gấp 99 lần. Đảo hai số là nhớ ngược công thức. là giá trị loss, không phải gradient. Cùng hướng chưa có nghĩa là cùng độ lớn, và đó chính là lý do người ta chọn non-saturating.
Một bước GAN thật, nhưng trên số một chiều
Trước khi train GAN ảnh, nên kiểm đồ thị gradient trên một bài nhỏ đến mức đọc được từng tham số: dữ liệu thật là bốn số quanh 2, G và D mỗi mạng là một lớp tuyến tính. Điều cần nhìn là tham số nào đổi ở bước nào; giá trị loss của một bước chưa nói gì về chất lượng sinh.
import numpy as np
import torch
from torch import nn

torch.set_num_threads(1)
torch.manual_seed(58)
generator = nn.Linear(1, 1)
discriminator = nn.Linear(1, 1)
optimizer_g = torch.optim.SGD(generator.parameters(), lr=0.1)
optimizer_d = torch.optim.SGD(discriminator.parameters(), lr=0.1)
real = torch.tensor([[1.7], [1.9], [2.1], [2.3]])
noise = torch.tensor([[-1.], [0.], [1.], [2.]])
criterion = nn.BCEWithLogitsLoss()

g_before_d = generator.weight.detach().clone()
optimizer_d.zero_grad()
fake = generator(noise)
real_logits = discriminator(real)
fake_logits = discriminator(fake.detach())
loss_d = criterion(real_logits, torch.ones_like(real_logits))
loss_d += criterion(fake_logits, torch.zeros_like(fake_logits))
loss_d.backward()
optimizer_d.step()
print("G unchanged during D step:", torch.equal(g_before_d, generator.weight))
print("D loss:", round(loss_d.item(), 4))
G unchanged during D step: True
D loss: 1.4571
D loss 1.4571 gần , mức của một D chấm 0.5 cho mọi mẫu: D mới khởi tạo chưa phân biệt được thật và giả. detach() ở fake làm gradient của bước D không đi vào G. Bước tiếp theo giữ trọng số D nhưng vẫn cần đạo hàm của D theo đầu vào:
d_before_g = discriminator.weight.detach().clone()
g_before_g = generator.weight.detach().clone()
for parameter in discriminator.parameters():
    parameter.requires_grad_(False)
optimizer_g.zero_grad()
fake = generator(noise)
fake_logits = discriminator(fake)
loss_g = criterion(fake_logits, torch.ones_like(fake_logits))
loss_g.backward()
optimizer_g.step()
for parameter in discriminator.parameters():
    parameter.requires_grad_(True)
print("D unchanged during G step:", torch.equal(d_before_g, discriminator.weight))
print("G changed during G step:", not torch.equal(g_before_g, generator.weight))
print("G loss:", round(loss_g.item(), 4))
print("hand loss for D(fake)=0.2:", round(-np.log(0.2), 4))
D unchanged during G step: True
G changed during G step: True
G loss: 1.0656
hand loss for D(fake)=0.2: 1.6094
G loss 1.0656 ứng với trung bình nhân của khoảng : D vẫn nghiêng về “giả”, nên G còn tín hiệu để học. Dòng cuối kiểm lại số tính tay ở mục trước.
Không đặt no_grad() quanh D trong bước G: như vậy sẽ cắt đường gradient cần về G. Đóng băng parameter D vẫn giữ phép tính theo fake. Ba dòng kiểm tham số phát hiện loại bug này trước khi chạy một GAN lớn.
GAN có thể dao động, discriminator quá mạnh hoặc generator chỉ sinh vài kiểu (mode collapse). Loss G/D không có quy tắc “càng thấp đồng thời càng tốt” giống supervised loss cố định. Cần xem chất lượng, đa dạng và metric phù hợp trên nhiều seed.
Hỏi nhanh
Xóa .detach() ở bước D rồi chạy lại. Dòng kiểm vẫn in G unchanged during D step: True. Ta kết luận được gì?
loss_d.backward() lan ngược qua ảnh giả tới G và ghi gradient vào generator.weight.grad. optimizer_d.step() chỉ giữ tham số của D, nên trọng số G không đổi, và phép kiểm vẫn đúng là True. Code này gọi optimizer_g.zero_grad() ngay trước bước G, nên gradient thừa bị xóa. Nếu vòng lặp xóa gradient ở chỗ khác, gradient “đẩy ảnh giả về phía giả” sẽ cộng vào bước G. Lần nào cũng tốn thêm một lượt backward qua G. Kiểm trọng số không thay được việc nhìn vào .grad.
Hỏi nhanh
Ở bước G, ta bọc dòng fake_logits = discriminator(fake) trong torch.no_grad(), còn fake = generator(noise) vẫn ở ngoài. Chuyện gì xảy ra?
Trong khối no_grad(), fake_logits không có grad_fn. Loss chỉ gồm số hạng này, nên backward() báo lỗi “does not require grad”. fake có gradient cũng không cứu được, vì đường đi bị cắt ngay tại D. Nếu loss còn số hạng khác nối với G, code sẽ chạy im lặng nhưng G không nhận tín hiệu nào từ D, còn khó phát hiện hơn. Khối no_grad không đổi việc optimizer nào cập nhật tham số nào. Nó cũng không làm gradient nhỏ đi một phần, mà cắt hẳn.
Diffusion: học sửa ảnh ở nhiều mức nhiễu
Thay vì đối đầu hai mạng, diffusion tạo một nhiệm vụ supervised từ dữ liệu: thêm noise đã biết vào mẫu sạch, rồi học đoán noise hoặc đại lượng tương đương. Lúc sinh, bắt đầu từ noise và làm nhiều bước khử nhiễu theo scheduler đã định nghĩa.
Đặt là mức nhiễu mỗi bước, , . Có thể lấy trực tiếp mẫu nhiễu ở thời điểm :
là dữ liệu sạch; là mức noise, không phải epoch. Hệ số căn bậc hai phân phối phần phương sai cho tín hiệu và noise. Khi gần 1, giữ nhiều tín hiệu; gần 0, mẫu gần noise.
Noise predictor cần nhận cả và vì cùng một giá trị nhiễu ở mức khác có ý nghĩa khác; thường được đưa vào mạng bằng embedding sin/cos như mã hóa vị trí ở bài 3.9. Khi , tiến về bất kể ; với không đổi, sau 50 bước .
Ví dụ: với , , , ta có . Target khi train noise predictor là 0.5, không phải 2. Khi có dự đoán noise , có thể ước lượng sạch bằng ; đây chưa phải toàn bộ sampler.
clean = 2.0
alpha_bar_example = 0.64
epsilon_example = 0.5
noisy = np.sqrt(alpha_bar_example) * clean
noisy += np.sqrt(1 - alpha_bar_example) * epsilon_example
estimated_clean = (noisy - np.sqrt(1 - alpha_bar_example) * epsilon_example)
estimated_clean /= np.sqrt(alpha_bar_example)
print("noisy:", round(noisy, 4))
print("reconstruction with known noise:", round(estimated_clean, 4))
noisy: 1.9
reconstruction with known noise: 2.0
Ta dùng noise thật ở dòng khôi phục, nên kết quả 2 là kiểm đại số, không phải model đã học khử nhiễu. Ở lúc sinh, ảnh sạch chưa biết và noise phải được model ước lượng.
Hỏi nhanh
Trong ví dụ ở trên có , , và . Một mẫu train của noise predictor gồm đầu vào và target nào?
Lúc sinh ta chỉ có mẫu nhiễu, nên đầu vào phải là . Target là noise đã rút ra để tạo , có sẵn miễn phí khi train. Thiếu thì cùng giá trị 1.9 ở các mức nhiễu khác nhau sẽ cần target khác nhau. Đoán là một cách tham số hóa khác, không phải noise predictor. Đoán từ chỉ là chạy lại công thức forward, không học gì cả.
Train noise predictor trên CPU với dữ liệu một chiều
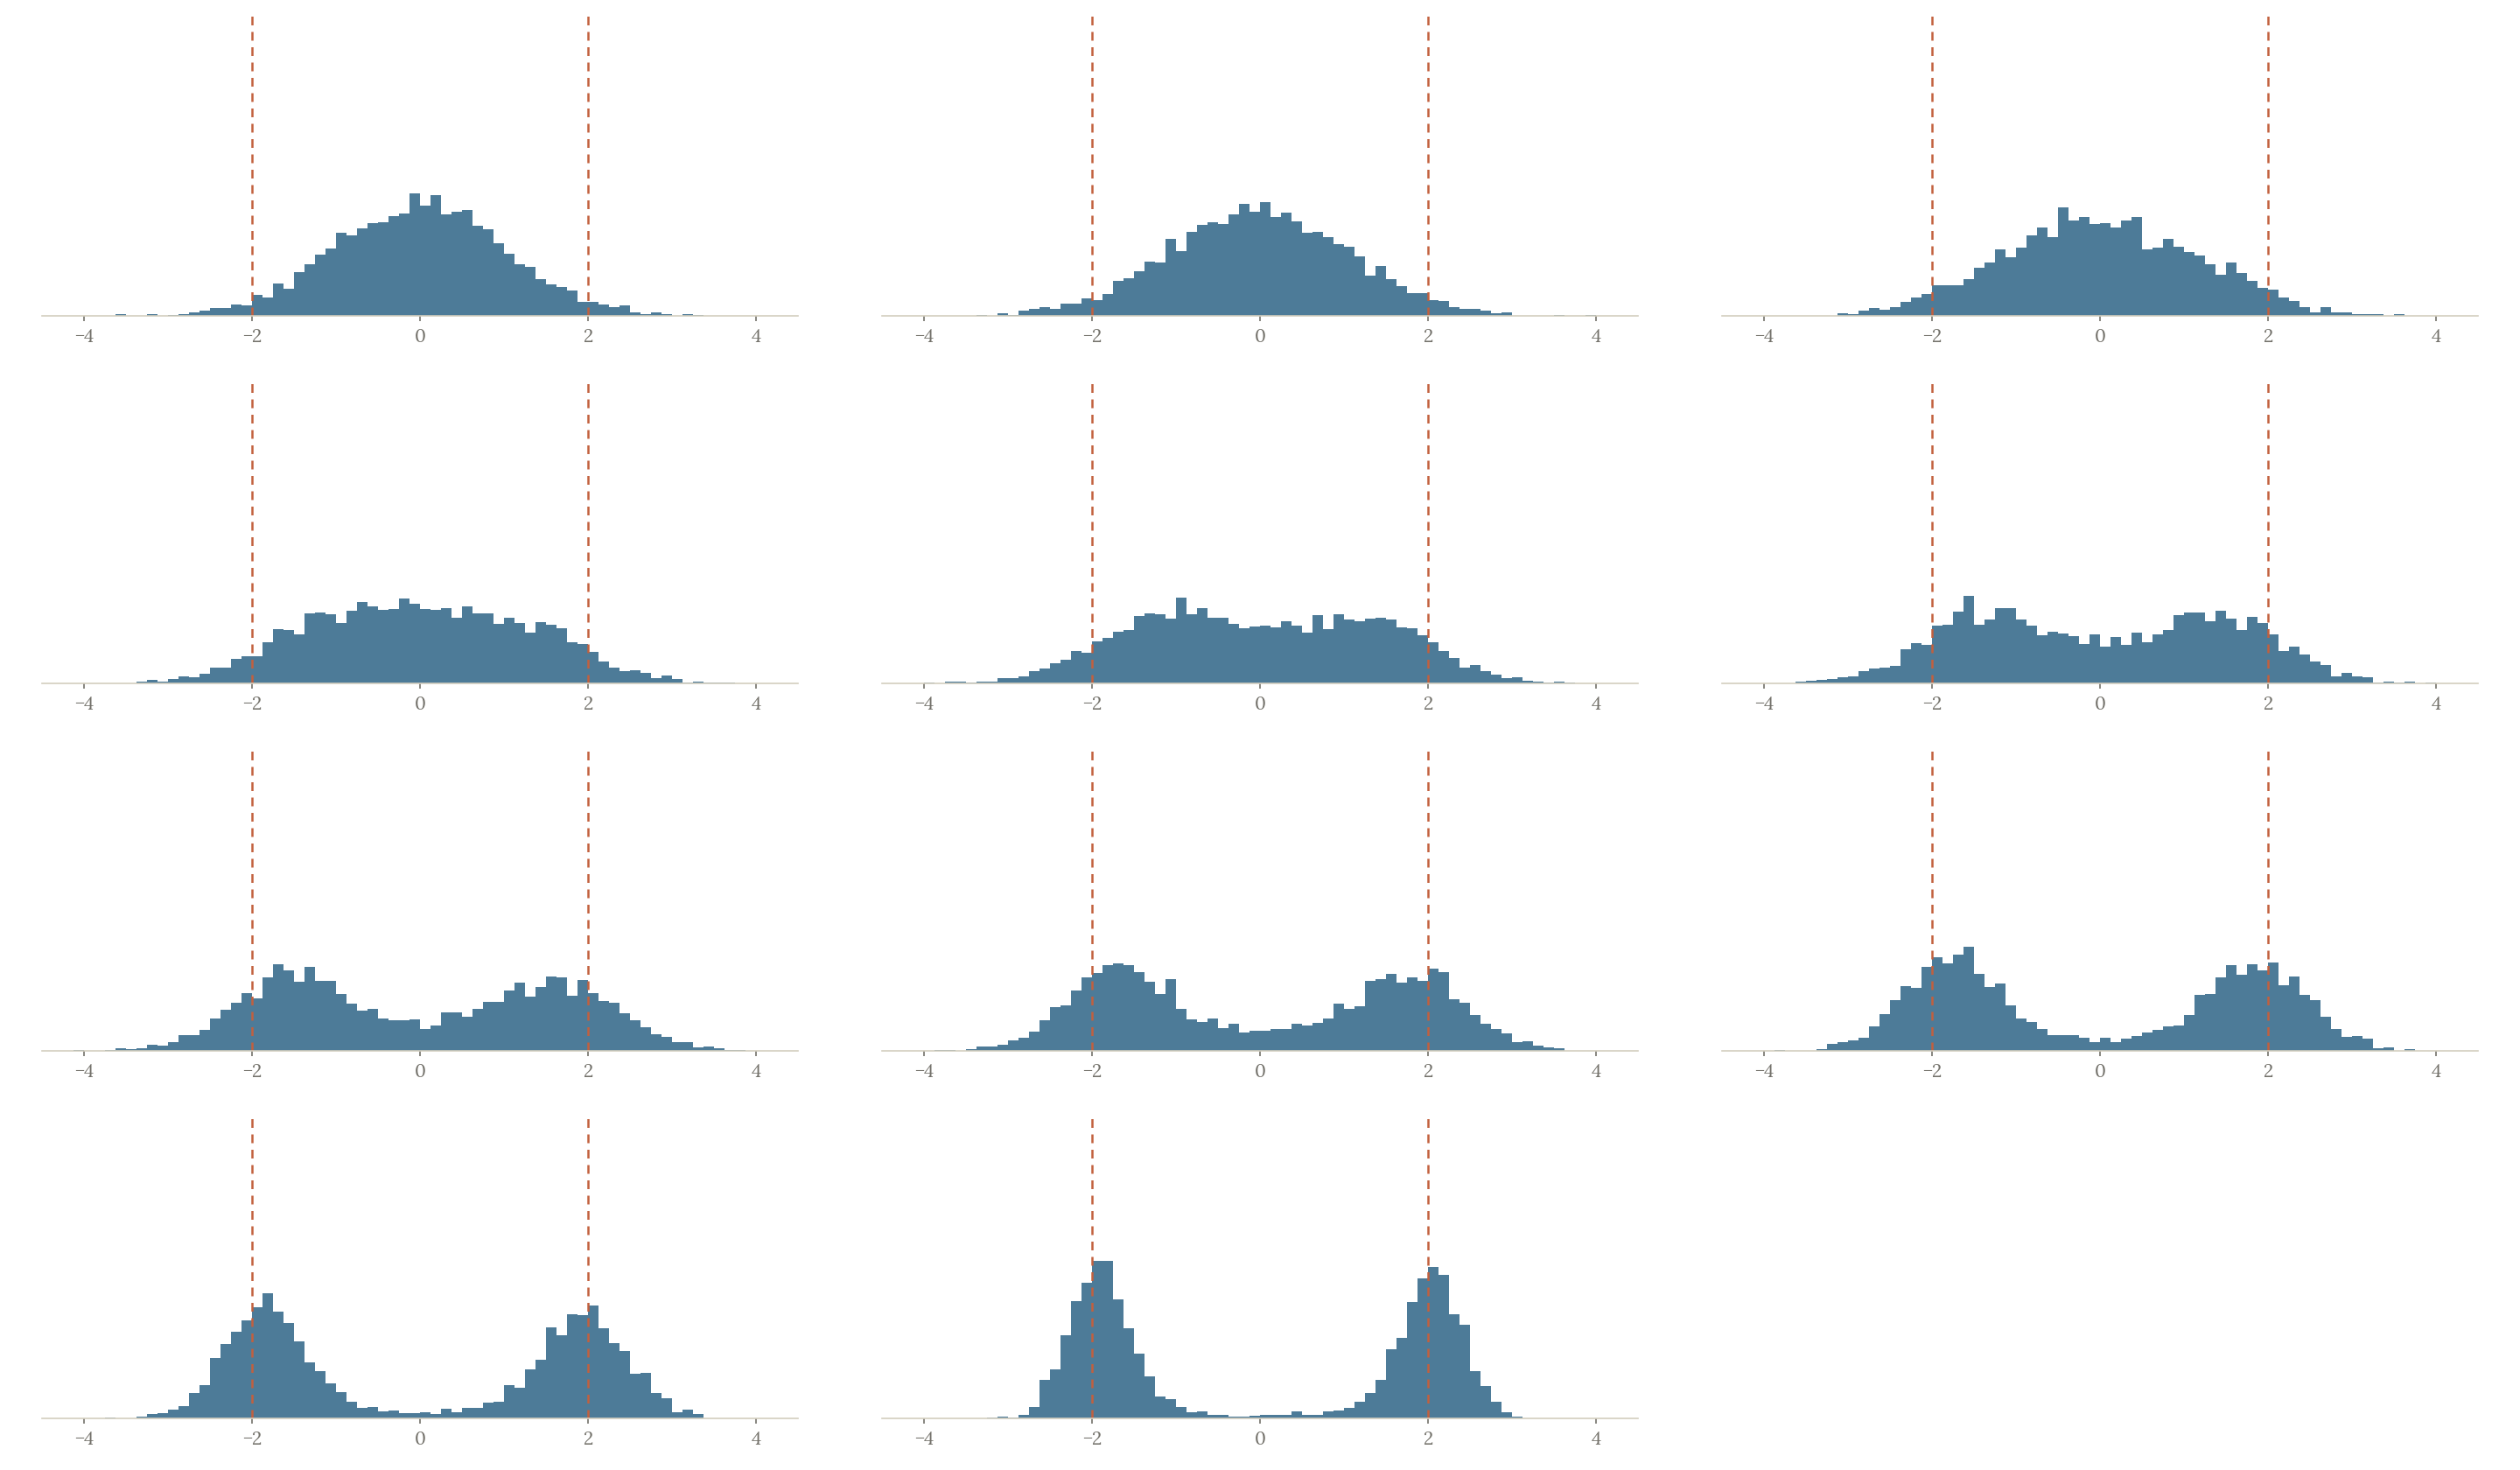
Thí nghiệm sau train thật một noise predictor trên dữ liệu một chiều: mỗi mẫu sạch nằm quanh hoặc , mức nhiễu lấy ngẫu nhiên trong 40 mức (chỉ số 0-39), MLP nhận cùng chỉ số mức chia cho 39 và đoán . Cơ chế giống hệt khi train trên ảnh; chỉ khác là là một số thay cho tensor ảnh, và mạng là MLP thay cho U-Net.
Loss là MSE giữa và dự đoán. DDPM xuất phát từ mục tiêu likelihood; sau khi rút gọn, mỗi số hạng thành bình phương sai số giữa và nhân một trọng số theo , và bài báo bỏ trọng số ấy để được MSE đơn giản trên noise.
torch.manual_seed(580)
steps = 40
betas = torch.linspace(0.01, 0.15, steps)
alpha_bars = torch.cumprod(1 - betas, dim=0)
denoiser = nn.Sequential(nn.Linear(2, 24), nn.Tanh(), nn.Linear(24, 1))
optimizer = torch.optim.Adam(denoiser.parameters(), lr=0.01)

def make_noisy_batch(count):
    clean = (torch.randint(0, 2, (count, 1)) * 4 - 2).float()
    clean += 0.2 * torch.randn(count, 1)
    times = torch.randint(0, steps, (count,))
    eps = torch.randn(count, 1)
    kept = alpha_bars[times, None]
    noisy = kept.sqrt() * clean + (1 - kept).sqrt() * eps
    inputs = torch.cat([noisy, times[:, None] / (steps - 1)], dim=1)
    return inputs, eps

valid_inputs, valid_noise = make_noisy_batch(128)
with torch.no_grad():
    before = nn.functional.mse_loss(denoiser(valid_inputs), valid_noise).item()
for update in range(250):
    inputs, targets = make_noisy_batch(64)
    optimizer.zero_grad()
    loss = nn.functional.mse_loss(denoiser(inputs), targets)
    loss.backward()
    optimizer.step()
with torch.no_grad():
    after = nn.functional.mse_loss(denoiser(valid_inputs), valid_noise).item()
    zero_baseline = valid_noise.square().mean().item()
print("noise MSE before/after:", round(before, 4), round(after, 4))
print("zero predictor MSE:", round(zero_baseline, 4))
print("last alpha_bar:", round(alpha_bars[-1].item(), 4))
noise MSE before/after: 0.9092 0.3434
zero predictor MSE: 0.9815
last alpha_bar: 0.0342
MSE giảm từ 0.9092 xuống 0.3434, thấp hơn nhiều so với baseline luôn đoán 0 (0.9815): model đã học. Ở mức cuối, : tín hiệu chỉ còn hệ số , nên mẫu ở mức này đã gần noise chuẩn.
MSE không thể về 0, vì cùng một có thể đến từ nhiều cặp . Ở mức nhiễu thấp, noise nhỏ hơn độ lệch tự nhiên của quanh nên không tách được; ở mức giữa, không biết đến từ cụm hay . Con số này đo việc đoán noise; chất lượng mẫu sinh còn phụ thuộc sampler và cần đánh giá riêng.
Hỏi nhanh
Ở một mức có , noise predictor đoán từ dễ hay khó?
. Với quanh , phần tín hiệu chỉ cỡ 0.06, nên đoán đã gần đúng. Ở mức này, khó là đoán chứ không phải đoán . Không cần biết chính xác , vì phần của nó trong quá nhỏ. Với noise predictor, những mức khó là mức nhiễu thấp và mức giữa.
Từ noise predictor đến model sinh có điều kiện
Sampler bắt đầu từ và dùng dự đoán noise ở từng mức để đi về ; tùy scheduler, mỗi bước có thể thêm một lượng noise mới.
Lặp công thức khôi phục ở trên không phải là DDPM: hệ số và phương sai của bước reverse phải khớp lịch nhiễu đã dùng khi train (DDPM §3.2 viết đủ các hệ số này). Mỗi bước là một lần gọi denoiser, và bước sau cần kết quả bước trước: 50 bước là 50 lần forward nối tiếp cho một ảnh, trong khi generator GAN chỉ cần một.
Diffusion có điều kiện chữ đưa embedding của prompt vào denoiser, thường qua cross-attention.
Latent diffusion (họ Stable Diffusion) chạy cả quá trình trong latent nén của ảnh: encoder của một autoencoder nén ảnh, khử nhiễu diễn ra trên latent, decoder biến latent cuối thành pixel. Stable Diffusion 1.x dùng latent cho ảnh , nên mỗi lần gọi denoiser rẻ hơn nhiều.
Hỏi nhanh
Dùng latent thay cho ảnh . Mỗi lần gọi denoiser xử lý ít hơn bao nhiêu lần số giá trị?
và , tỉ lệ là 48. 8 là tỉ lệ cạnh. 64 là tỉ lệ diện tích, quên số kênh. 192 chỉ tính 3 kênh của ảnh mà quên 4 kênh của latent.
Classifier-free guidance (CFG) điều khiển mức bám prompt. Mỗi bước gọi denoiser hai lần, có prompt và không prompt , rồi đẩy dự đoán ra xa bản không điều kiện:
là dự đoán có điều kiện thường. lớn hơn làm ảnh bám prompt hơn, đổi lại đa dạng giảm và màu, chi tiết có thể quá gắt; mỗi bước cũng tốn gấp đôi. Model học cả hai chế độ nhờ khi train bỏ prompt ở một phần mẫu. Ví dụ không prompt 0.1 và có prompt 0.4 với cho . Số bước, sampler, kích thước, , seed và prompt đều cần ghi khi so kết quả.
Script của chương đưa quy trình này vào một lệnh: local_assets.py --task diffusion kiểm gói diffusers và transformers, thư mục pipeline có model_index.json, prompt và đường dẫn ảnh ra; không có --run thì chỉ kiểm điều kiện rồi dừng.
Với --run, script nạp pipeline (tokenizer, text encoder, U-Net, VAE, scheduler, weights safetensors) ở chế độ offline trên CPU float32 và sinh một ảnh bằng 10 bước với seed 5, không ghi đè ảnh cũ. Một ảnh như vậy xác nhận đường nạp và inference chạy được; so chất lượng hai cấu hình cần cả bộ prompt và seed, như mục sau.
Đánh giá model sinh
FID so phân phối feature (lấy từ một mạng phân loại pretrained) của ảnh sinh với ảnh thật. FID càng thấp càng tốt, nhưng cần hàng nghìn mẫu và cách tính nhất quán giữa các lần so: 500 ảnh mỗi model là quá ít, và FID tính trên số mẫu khác nhau không so được với nhau.
Sinh dữ liệu để train classifier cần kiểm nhãn, trùng lặp và mức khớp miền ảnh thật. Model sinh học từ dữ liệu nguồn, có thể lặp nội dung hoặc thiên lệch; ảnh sinh không tự là bằng chứng về thế giới thật.
Hỏi nhanh
Ta so hai cấu hình sampler. Cấu hình A cho 4 ảnh đẹp nhất chọn từ 200 lần chạy. Cấu hình B cho 4 ảnh của seed 0 đến 3. A trông đẹp hơn. So thế nào mới công bằng?
A được chọn lọc còn B thì không, nên phép so này đo việc chọn lọc chứ không đo sampler. Lấy ảnh đẹp nhất trong 200 lần cho cả hai thì vẫn chỉ nhìn phần đẹp nhất, giấu đi mẫu hỏng và mode collapse. Hai cấu hình sampler dùng chung một model, nên loss train không phân biệt được chúng. Cùng prompt và seed giữ mọi thứ khác cố định, còn nhiều mẫu thì cho phép đo cả chất lượng lẫn đa dạng.
Khi đi thi
- Ước lượng thời gian: số ảnh × số bước × một lần gọi denoiser, gấp đôi khi bật CFG.
- So cấu hình trên cùng bộ prompt và seed, mỗi lần đổi một thứ.
- Ảnh sinh chỉ dùng cho train; validation và test giữ ảnh thật.
Tóm tắt
- Model sinh học phân phối dữ liệu; noise và seed tạo ra sự đa dạng.
- GAN: D học phân biệt thật/giả, G học lừa D; hai bước cập nhật luân phiên, phải đúng đường gradient (
detachở bước D) và kiểm đa dạng. - Diffusion học đoán noise ở nhiều mức bằng MSE, rồi sinh bằng nhiều bước khử nhiễu theo scheduler.
- Latent diffusion làm mỗi bước rẻ hơn; guidance đổi đa dạng lấy mức bám prompt.
- Đánh giá model sinh cần nhiều mẫu, cùng prompt và seed; vài ảnh đẹp chưa đủ.
Kiểm tra cuối bài
Câu 1
Forward diffusion hai bước: và , với độc lập, , . Phân phối của khi biết có mean và phương sai bao nhiêu?
Thế vào: . Tổng hai Gaussian độc lập có phương sai , với , khớp công thức một bước của bài. Phương sai 0.30 là cộng , quên rằng noise bước 1 cũng bị nhân với . Mean là lấy thay cho .
Câu 2
Lịch nhiễu có với mọi . Khi , phân phối của khi biết tiến tới đâu?
, nên mean và phương sai . Mỗi bước nhân cả tín hiệu lẫn noise cũ với , nên phương sai không nổ. Noise mới bù vào, nên phương sai cũng không về 0. Giới hạn này không phụ thuộc dữ liệu, nên sampler bắt đầu từ . Trong code của bài, ở mức cuối là 0.0342, mới gần chứ chưa bằng 0.
Câu 3
KL divergence đo độ khác nhau giữa hai phân phối, và bằng 0 khi chúng trùng nhau. Với hai Gaussian một chiều, . Ở một bước reverse, phân phối đích có mean 1.30, model có mean 1.10, hai bên cùng phương sai 0.04. KL bằng bao nhiêu?
, còn lại . Cùng phương sai thì KL chỉ còn . 0.04 là quên mẫu số. 1.0 là quên số 2. 2.5 là quên bình phương. Trong DDPM, mean đích và mean của model đều viết được qua và noise, với ở phía đích và ở phía model. Chênh mean vì vậy tỉ lệ với , và KL thành một hằng số nhân với . Đó là gốc của loss MSE trên noise.
Phỏng theoUSA-NA-AIO 2026 · Vòng 2 · Ngày 2 · Part 3.2.1-3.2.5
Câu 4
Noise predictor cho ảnh là một U-Net. Đầu vào có shape (B, C, H, W), đầu ra cùng shape. Nên đưa bước vào mạng bằng cách nào?
DDPM mã hóa bằng sinusoidal embedding giống positional encoding của Transformer, cho qua vài lớp MLP, rồi cộng vào từng khối. Nhờ vậy mọi tầng đều biết đang ở mức nhiễu nào. không xác định duy nhất mức nhiễu, vì một ảnh sạch có hạt vẫn trông như ảnh nhiễu nhẹ. Mỗi một mạng thì số tham số nhân lên lần, và các mức không chia sẻ được những điểm giống nhau. Đưa vào sau khi mạng chạy xong thì phép tính bên trong không dùng được nó. MLP trong bài nối vào đầu vào, là dạng đơn giản nhất của cùng ý tưởng.
Câu 5
Đề cho 30 phút để sinh 600 ảnh trên một GPU. Generator của GAN tạo một ảnh trong 15 ms. Pipeline diffusion dùng 50 bước, mỗi bước gọi U-Net một lần mất 40 ms, không dùng CFG. Diffusion mất bao lâu để sinh xong, và vì sao chậm hơn GAN?
giây, tức 20 phút, so với giây của GAN. Một lần gọi U-Net chỉ chậm hơn generator khoảng 2.7 lần. Chênh lệch hơn trăm lần đến từ 50 bước, và các bước không chạy song song được, vì bước sau cần của bước trước. Bật CFG thì mỗi bước gọi hai lần, thành 40 phút, vượt ngân sách. Khi đó phải giảm số bước hoặc dùng sampler ít bước hơn.
Câu 6
Ở một bước sinh, denoiser cho khi không có prompt, và khi có prompt. Với classifier-free guidance , noise dùng cho bước này là bao nhiêu? lớn có tác dụng gì?
. 1.5 là nhân với riêng dự đoán có prompt, quên bản không điều kiện. CFG đẩy dự đoán theo hướng của prompt, nên ảnh bám prompt hơn, đổi lại kém đa dạng. Nó không làm sampling nhanh hơn: mỗi bước phải gọi denoiser hai lần, còn số bước không đổi.
Câu 7
GAN sinh khuôn mặt sắc nét, nhưng 64 mẫu từ 64 seed khác nhau gần như cùng một gương mặt, dù dữ liệu thật rất đa dạng. Điều này nói lên gì?
Chất lượng từng mẫu và độ phủ phân phối là hai tiêu chí khác nhau. G có thể lừa D bằng vài kiểu ảnh tốt. Loss GAN không theo quy tắc “giảm là tốt” như loss supervised, vì đối thủ cũng đang thay đổi. Số chiều của chưa chắc là nguyên nhân. Quan sát này là dấu hiệu cần đo và điều tra thêm, chưa chỉ ra một cách sửa duy nhất.
Câu 8
Một đội viết optimizer_g = torch.optim.SGD(list(generator.parameters()) + list(discriminator.parameters()), lr=0.1), và ở bước G không đóng băng D. Phần còn lại giữ như code của bài. Dòng kiểm nào lộ ra lỗi, và D bị đẩy theo hướng nào?
Không đóng băng thì loss_g.backward() ghi gradient cho cả tham số của D. optimizer_g.step() cập nhật chúng theo hướng giảm , tức là dạy D chấm ảnh giả là thật, ngược với mục tiêu của D. Dòng kiểm D vì vậy in False. Optimizer cập nhật mọi tham số được truyền vào, không chỉ tham số của G. Gradient của G không bị “chia” đi đâu, nên G vẫn thay đổi.
Câu 9
Một noise predictor nhỏ có MSE đoán noise trên batch kiểm tra, cùng quy tắc sinh dữ liệu và cùng lịch nhiễu, giảm từ 1.0 xuống 0.6 sau khi train. Bằng chứng này cho phép kết luận điều gì?
Đây là kết quả của việc đoán noise trên đúng dữ liệu và lịch nhiễu đã mô tả. Muốn biết chất lượng mẫu sinh thì phải chạy sampler và đánh giá các mẫu. MSE giảm 40% không có nghĩa là ảnh “đẹp hơn 40%”. Lịch nhiễu khác làm đổi phân phối của ở từng , nên phải kiểm lại. Còn sampler thì chưa hề được chạy trong phép đo này.
Câu 10
Đội có 300 ảnh thật có nhãn. Họ sinh thêm 3000 ảnh bằng diffusion theo prompt của từng lớp, trộn tất cả, rồi chia ngẫu nhiên 80/20 thành train và validation. Validation accuracy tăng từ 71% lên 90%. Con số này có đáng tin không?
Khoảng 600 trong 660 ảnh validation là ảnh sinh, cùng prompt và cùng kiểu với ảnh sinh trong train, nên dễ hơn ảnh thật. 90% chủ yếu đo khả năng nhận ra ảnh sinh. Test của đề là ảnh thật, nên validation phải gồm ảnh thật, và phải tách ra trước khi thêm ảnh sinh vào train. Sinh thêm theo tín hiệu của một validation hỏng chỉ khuếch đại sai lệch.
Đọc thêm
- Goodfellow và cộng sự - Generative Adversarial Networks: đọc hai vai trò và phân biệt minimax với loss generator thực hành.
- Ho, Jain, Abbeel - Denoising Diffusion Probabilistic Models: đọc forward noise, noise prediction và reverse sampler.
- Rombach và cộng sự - High-Resolution Image Synthesis with Latent Diffusion Models: đọc vì sao khử nhiễu trong latent và cách đưa prompt vào qua cross-attention.
- Ho, Salimans - Classifier-Free Diffusion Guidance: đọc cách train một model cho cả hai chế độ và đánh đổi giữa mức bám điều kiện với đa dạng.
- Diffusers - Stable Diffusion pipelines: đối chiếu điều kiện, sampler và cách nạp pipeline khi có asset.
Tải gói recipe của chương - gồm các module phụ và hướng dẫn chuẩn bị asset.