Câu lạc bộ chỉ có vài buổi cần thêm người hỗ trợ, và muốn model báo trước những buổi ấy. Trong 100 buổi chỉ có ba buổi cần hỗ trợ, nên một model lúc nào cũng đoán “không cần” vẫn đúng 97 buổi. Accuracy 97% nghe tốt, nhưng model bỏ sót cả ba buổi quan trọng.
Vì vậy phải xem model sai kiểu nào: bỏ sót buổi cần hỗ trợ, hay báo nhầm buổi không cần. Bài này học confusion matrix, precision, recall, F1, ROC-AUC và cách chọn ngưỡng xác suất.
Bốn ô trước một con số tổng
Quy ước lớp dương (positive) là cần hỗ trợ, nhãn 1. Lớp âm (negative), nhãn 0, là chưa cần hỗ trợ. Dương không có nghĩa tốt, âm không có nghĩa xấu; chúng là tên hai vai trò trong phép đo.
True positive (TP) là báo cần và thật sự cần. False positive (FP) là báo cần nhưng thật sự chưa cần. False negative (FN) là báo chưa cần nhưng thật sự cần. True negative (TN) là báo chưa cần và đúng là chưa cần.
Cách nhớ: chữ thứ hai (positive, negative) là điều model báo; chữ đầu (true, false) cho biết báo đúng hay sai. Mỗi buổi rơi vào đúng một ô, và tổng bốn ô bằng số buổi. Bảng bốn ô này gọi là confusion matrix: hai ô trên đường chéo (TP, TN) là đoán đúng, hai ô còn lại cho biết model nhầm lớp nào thành lớp nào. Trong scikit-learn, với labels=[0, 1], nó được in theo thứ tự [[TN, FP], [FN, TP]]; tài liệu khác có thể vẽ theo chiều khác, nên luôn đọc nhãn hàng, cột trước.
Khi hai loại lỗi có giá khác nhau, nhân số lỗi với giá rồi so tổng: nếu một FP tốn 1 và một FN tốn 10, thì 20 FP và 30 FN tốn .
Hỏi nhanh
Mô hình báo buổi ấy không cần hỗ trợ, nhưng thực tế lại cần. Trường hợp này nằm ở ô nào?
Buổi thực tế cần hỗ trợ là mẫu dương, mà mô hình lại báo âm. Đó là bỏ sót, tức FN (false negative).
Precision, recall và F1 nhìn những nhóm khác nhau
Accuracy đo tỉ lệ dự đoán đúng trên mọi mẫu:
Precision hỏi: trong những buổi model đã báo cần, bao nhiêu buổi thật sự cần? Recall hỏi: trong những buổi thật sự cần, model phát hiện được bao nhiêu?
Precision thấp thì người hỗ trợ phải đến nhiều buổi không cần. Recall thấp thì nhiều buổi cần hỗ trợ bị bỏ sót. Model luôn báo “cần” có recall bằng 1, nhưng precision chỉ bằng tỉ lệ buổi cần trong dữ liệu. Ngoài ra còn specificity , tức recall của lớp âm.
Ưu tiên cái nào là tùy bài toán. Sàng lọc bệnh hay quét mã độc: bỏ sót rất đắt, còn báo nhầm thì đã có người kiểm lại, nên ưu tiên recall. Lọc thư rác mà vứt nhầm thư công việc, hay ẩn nhầm bình luận bình thường: báo nhầm gây hại, nên ưu tiên precision.
F1 là trung bình điều hòa của precision và recall :
Chỉ cần một trong hai thấp là F1 bị kéo thấp: , cho , thấp hơn trung bình cộng 0.75. F1 không dùng đến TN. Khi model không báo dương lần nào, precision có mẫu số 0; khi dữ liệu không có mẫu dương nào, recall có mẫu số 0. Code trong bài ghi rõ zero_division=0 để những trường hợp đó tính là 0.
Hỏi nhanh
Có TP = 3, FP = 3, FN = 1. Precision và recall lần lượt bằng bao nhiêu?
Precision là , recall là . Phương án đảo ngược là nhầm mẫu số. là F1, không phải hai tỉ lệ kia. là chia TP cho tất cả các ô có chữ T, F lẫn lộn.
Một validation nhỏ để tính và đối chiếu
Giả sử mô hình đã trả xác suất cần hỗ trợ cho mười buổi validation. Ta cố ý dùng một mảng nhỏ để tính tay; code không huấn luyện mô hình trong bài này. Score lớn hơn nghĩa là model đánh giá khả năng cần hỗ trợ cao hơn. Threshold biến score thành nhãn:
bằng 1 khi điều kiện đúng, bằng 0 khi sai. Quy tắc dùng dấu lớn hơn hay lớn hơn hoặc bằng phải thống nhất, nhất là khi score đúng bằng threshold.
import numpy as np
from sklearn.metrics import (
    confusion_matrix, accuracy_score, precision_score, recall_score, f1_score,
)

y_valid = np.array([1, 0, 1, 0, 0, 1, 0, 0, 1, 0])
p_valid = np.array([0.95, 0.80, 0.70, 0.65, 0.60, 0.55, 0.40, 0.30, 0.20, 0.10])
prediction = (p_valid >= 0.5).astype(int)
cm = confusion_matrix(y_valid, prediction, labels=[0, 1])
tn, fp, fn, tp = cm.ravel()
print(cm)
print('TN, FP, FN, TP:', tn, fp, fn, tp)
print(f'Accuracy={accuracy_score(y_valid, prediction):.3f}')
print(f'Precision={precision_score(y_valid, prediction, zero_division=0):.3f}')
print(f'Recall={recall_score(y_valid, prediction, zero_division=0):.3f}')
print(f'F1={f1_score(y_valid, prediction, zero_division=0):.3f}')
[[3 3]
[1 3]]
TN, FP, FN, TP: 3 3 1 3
Accuracy=0.600
Precision=0.500
Recall=0.750
F1=0.600
Ở ngưỡng 0.5, sáu buổi được báo cần; trong đó ba buổi thật sự cần. Có bốn buổi dương thật và ta tìm được ba. Vì vậy precision 0.5, recall 0.75, F1 . Accuracy cũng bằng 0.6 ở dữ liệu này, nhưng hai metric trùng số chỉ là tình cờ.
Hỏi nhanh
Vẫn mười score ở trên, giờ đổi ngưỡng thành . Precision và recall lần lượt bằng bao nhiêu?
Có ba buổi score từ 0.7 trở lên: 0.95 là dương, 0.80 là âm, 0.70 là dương. Vậy TP = 2, FP = 1. Hai buổi dương còn lại, score 0.55 và 0.20, bị bỏ sót, nên FN = 2. Precision là , recall là . So với ngưỡng 0.5, precision tăng còn recall giảm. F1 lúc này là 0.571, khớp với dòng t=0.7 ở mục sau.
Quay lại ví dụ 100 buổi đầu bài: luôn đoán 0 cho TP = 0, FN = 3, FP = 0, TN = 97. Accuracy 0.97, nhưng recall và F1 đều bằng 0. Accuracy không tính sai, chỉ là nó không đo điều ta cần: tìm ra lớp hiếm.
Threshold là một lựa chọn phải đánh giá
Hạ threshold thì nhiều mẫu được báo dương hơn: recall không bao giờ giảm, còn precision lên hay xuống tùy mẫu mới được thêm vào là dương thật hay âm thật. Vì vậy không có công thức chung; ta thử vài ngưỡng trên validation và chọn theo metric của đề.
Nếu biết giá của hai loại lỗi và xác suất của model đáng tin, có một cách tính thẳng: báo dương khi chi phí kỳ vọng của việc không báo, , lớn hơn chi phí kỳ vọng của việc báo, . Tức là báo dương khi . Bỏ sót đắt gấp 10 lần báo nhầm thì ngưỡng là .
thresholds = np.array([0.3, 0.5, 0.7, 0.9])
valid_f1 = []
for threshold in thresholds:
    prediction = p_valid >= threshold
    score = f1_score(y_valid, prediction, zero_division=0)
    valid_f1.append(score)
    print(f't={threshold:.1f}: F1={score:.3f}')
chosen_threshold = float(thresholds[np.argmax(valid_f1)])
print('Chọn trên validation:', chosen_threshold)
t=0.3: F1=0.500
t=0.5: F1=0.600
t=0.7: F1=0.571
t=0.9: F1=0.400
Chọn trên validation: 0.5
argmax chọn ngưỡng có F1 lớn nhất; nếu hòa thì lấy ngưỡng đầu tiên. Threshold cũng là một thứ ta chọn bằng dữ liệu, giống các tham số khác (bài 1.7 gọi là hyperparameter), dù nó không đổi trọng số nào của model.
Chọn xong, ta áp đúng ngưỡng đó lên một tập test riêng. Không thử lại bốn ngưỡng trên test rồi đổi ý.
y_test = np.array([0, 1, 0, 0, 1, 0, 1, 0])
p_test = np.array([0.70, 0.80, 0.20, 0.40, 0.55, 0.10, 0.30, 0.65])
test_prediction = p_test >= chosen_threshold
print(f'Test F1 với ngưỡng đã chốt={f1_score(y_test, test_prediction, zero_division=0):.3f}')
Test F1 với ngưỡng đã chốt=0.571
Điểm test khác validation vì là những mẫu khác. Nếu xem test xong lại thử ngưỡng khác rồi báo điểm tốt nhất, test đã thành một phần của việc chọn. Khi validation quá nhỏ, ngưỡng chọn được dễ chạy theo nhiễu; có thể chọn ngưỡng trên dự đoán OOF (bài 1.3) để có nhiều mẫu hơn.
Hỏi nhanh
Trọng số của mô hình chỉ học trên train, nhưng ngưỡng phân lớp lại được chọn bằng nhãn test. Điểm trên test còn độc lập không?
Ngưỡng cũng là một phần của quy tắc ra nhãn. Nó đã được chỉnh theo nhãn test, nên điểm test quá lạc quan. Khi đánh giá cuối, cả mô hình lẫn ngưỡng phải được chốt từ trước, và ngưỡng thì chọn trên validation.
ROC-AUC: thứ tự trước khi cắt ngưỡng
ROC dùng trục ngang false positive rate (FPR) và trục dọc true positive rate (TPR, chính là recall):
Hạ threshold từ rất cao xuống rất thấp, mỗi ngưỡng cho một điểm (FPR, TPR); nối các điểm lại được đường ROC. ROC-AUC là diện tích dưới đường đó.
Có một cách tính tay cho cùng kết quả: xét mọi cặp gồm một mẫu dương và một mẫu âm; cặp nào score của mẫu dương cao hơn thì được 1 điểm, bằng nhau được 0.5, thấp hơn được 0; AUC là trung bình số điểm. Vậy:
- AUC chỉ phụ thuộc thứ tự các score. Biến đổi score mà giữ nguyên thứ tự, như , không đổi AUC.
- AUC bằng 0.5 là xếp hạng không hơn đoán bừa, bằng 1 là hoàn hảo. Nó không phải accuracy.
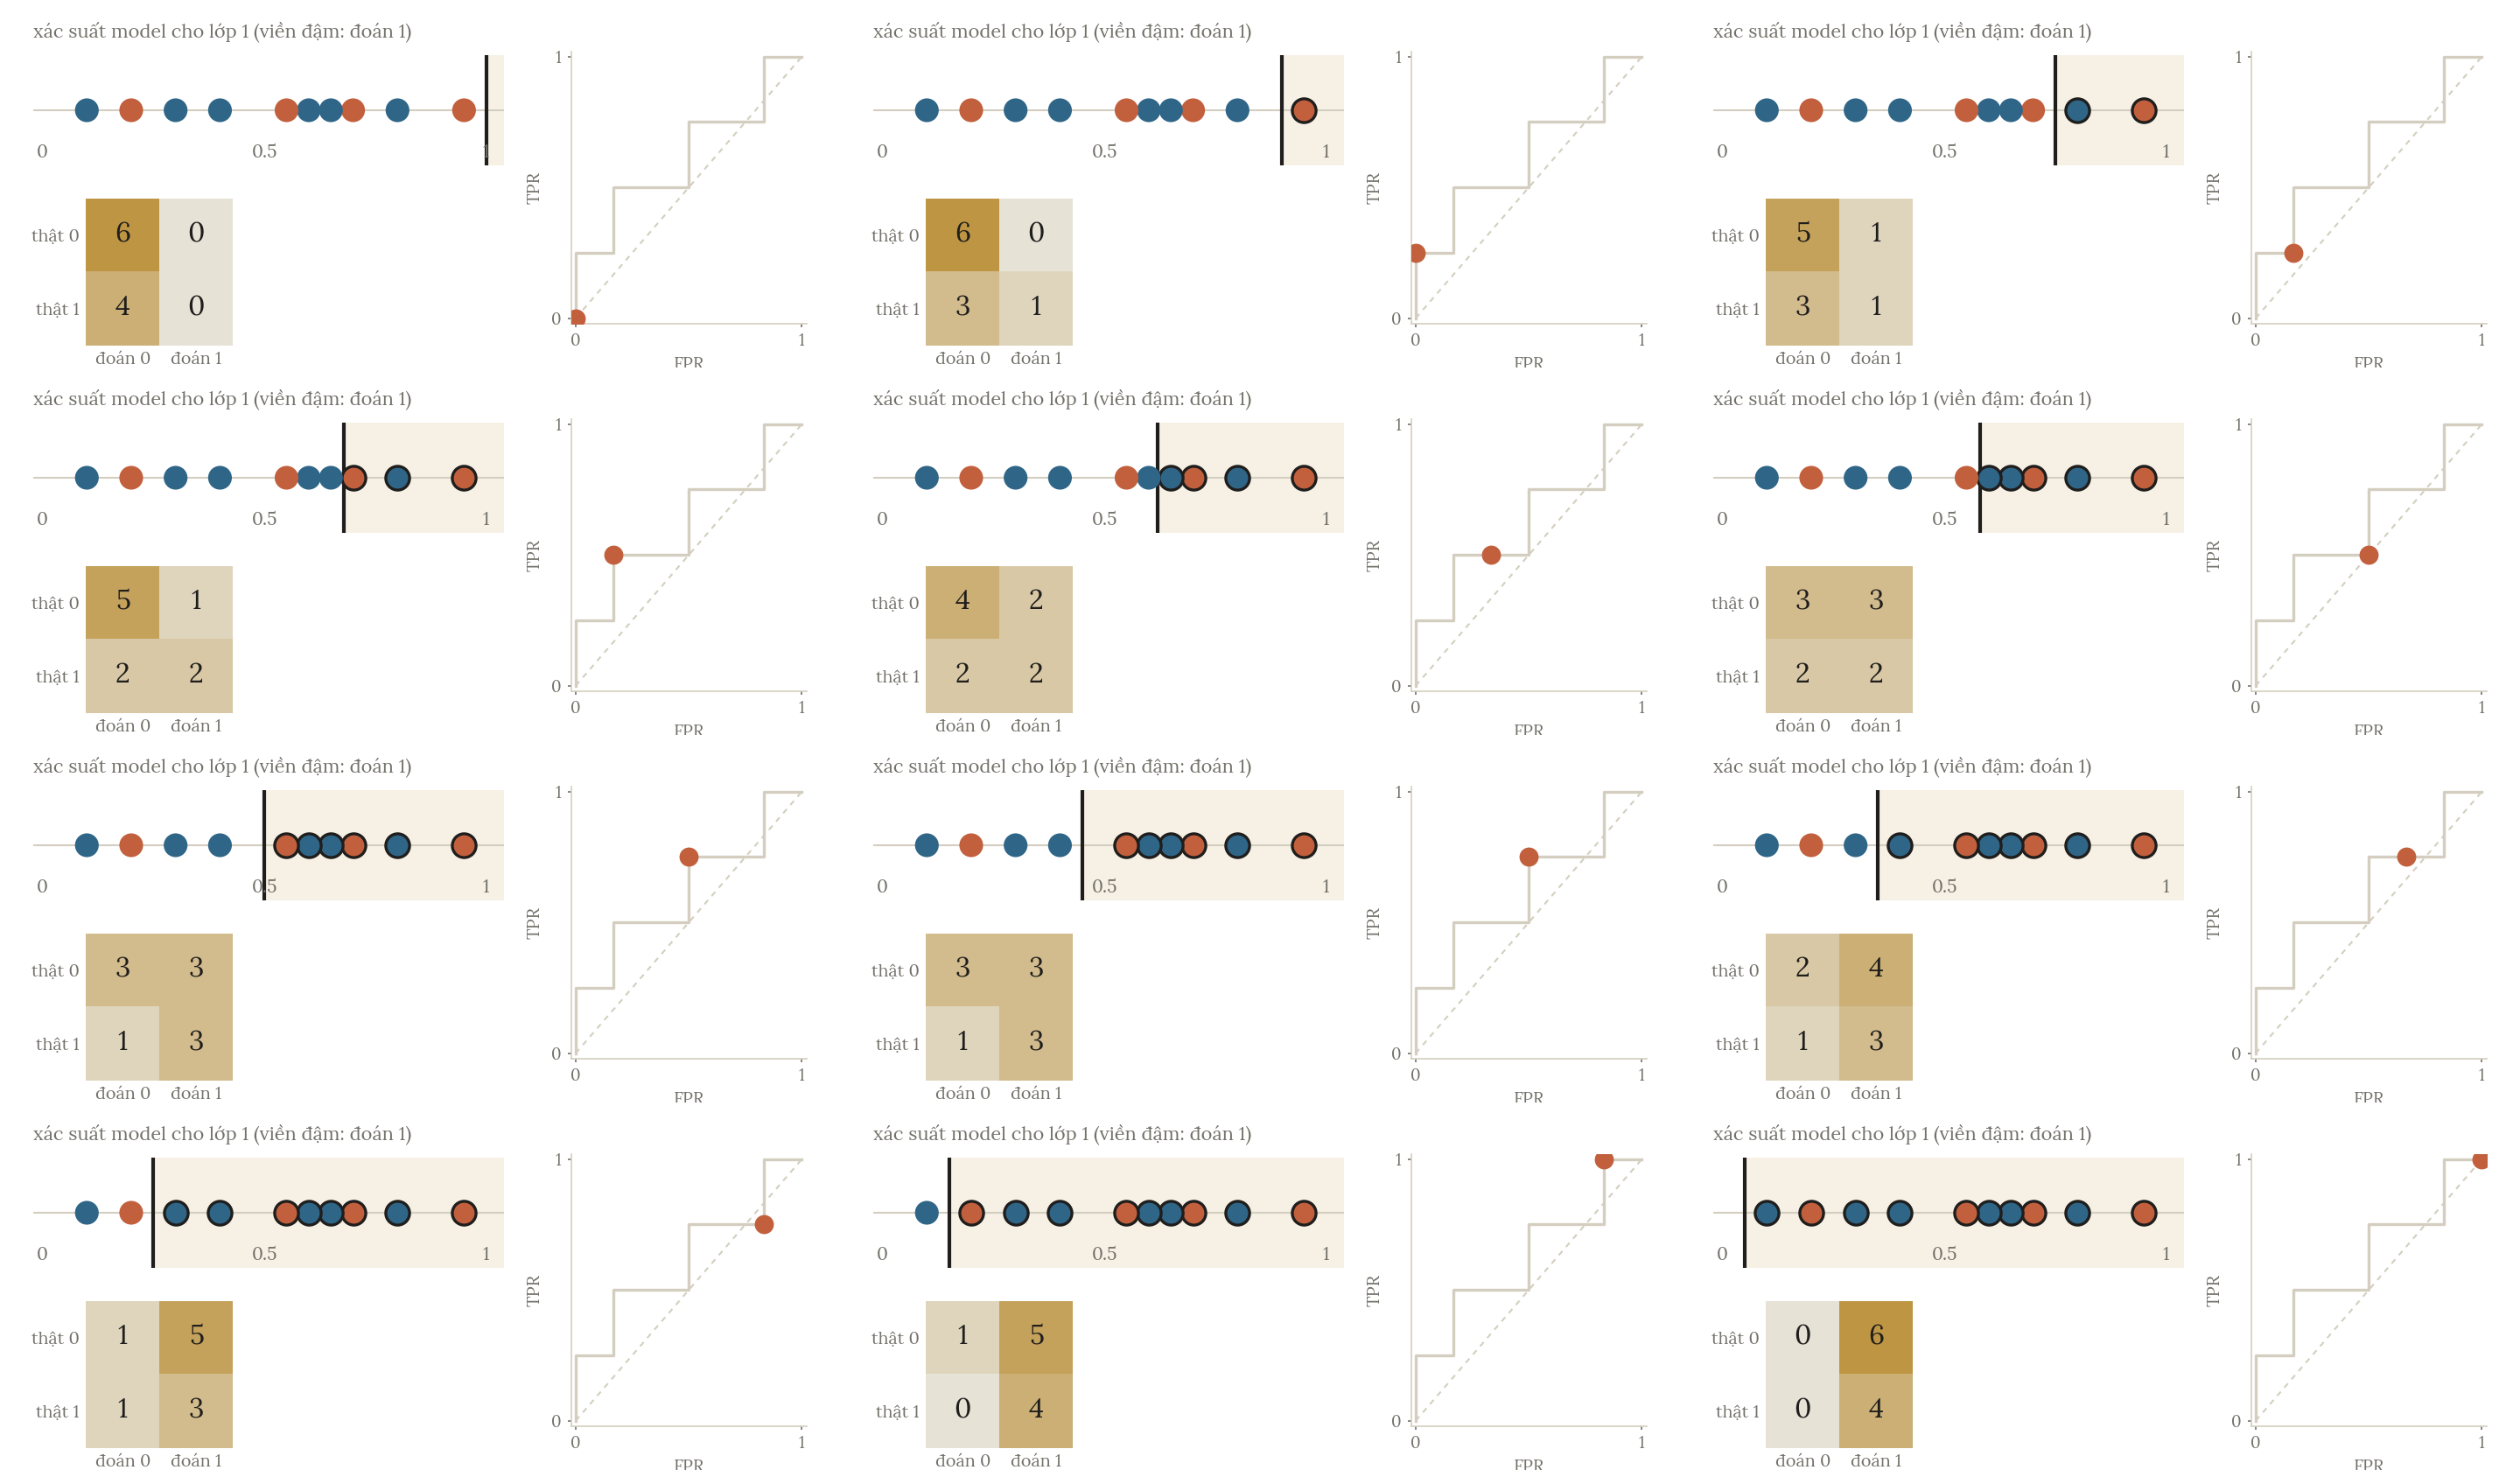
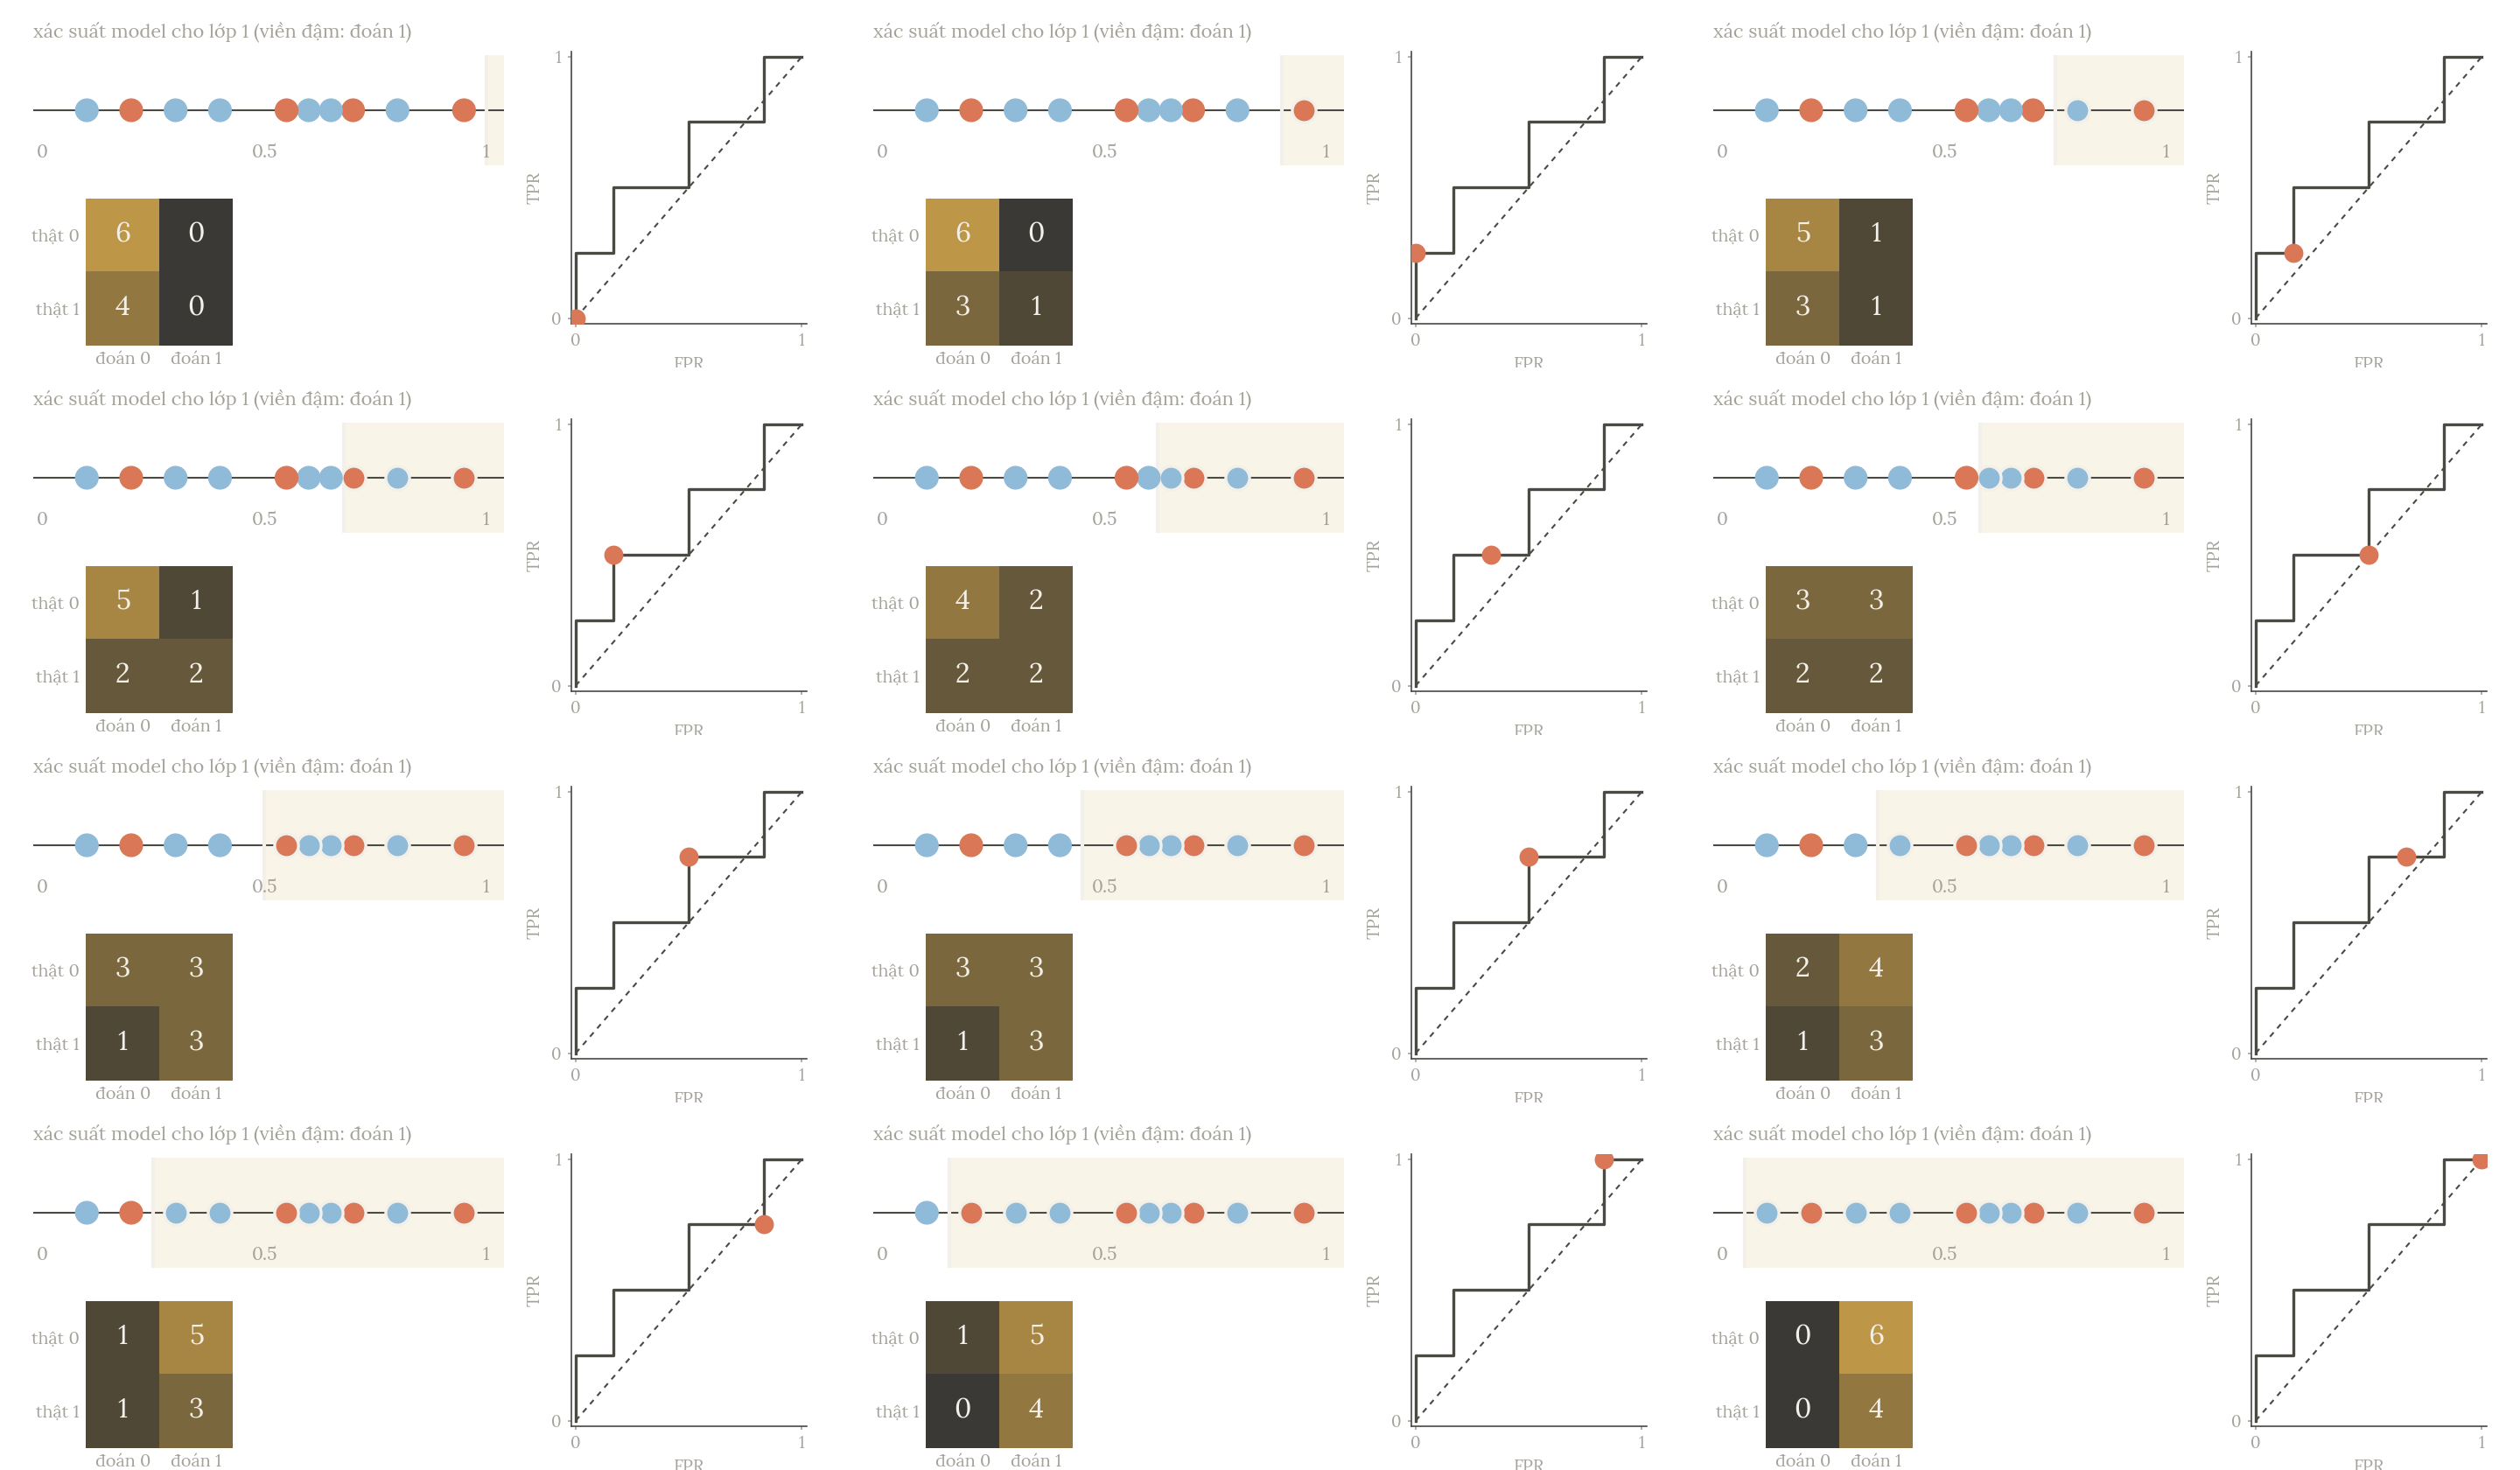
Với mảng validation, bốn score dương là 0.95, 0.70, 0.55, 0.20. Sáu score âm là 0.80, 0.65, 0.60, 0.40, 0.30, 0.10. Số cặp xếp đúng lần lượt là 6, 5, 3, 1: AUC .
from sklearn.metrics import roc_auc_score, average_precision_score

positive_scores = p_valid[y_valid == 1]
negative_scores = p_valid[y_valid == 0]
pair_points = []
for positive in positive_scores:
    for negative in negative_scores:
        pair_points.append(float(positive > negative) + 0.5 * float(positive == negative))
print(f'AUC tính theo cặp={np.mean(pair_points):.3f}')
print(f'AUC thư viện={roc_auc_score(y_valid, p_valid):.3f}')
print(f'Average precision={average_precision_score(y_valid, p_valid):.3f}')
AUC tính theo cặp=0.625
AUC thư viện=0.625
Average precision=0.653
Hai dòng AUC trùng nhau, xác nhận cách đếm cặp. Với lớp hiếm, ROC có thể trông tốt dù số báo nhầm tuyệt đối vẫn lớn, vì FPR chia cho một số TN khổng lồ; khi ấy nên đọc thêm đường precision-recall và average precision (AP), một cách tổng hợp precision khi recall tăng dần.
AUC cần cả hai lớp và phải nhận score liên tục, không dùng nhãn đã cắt 0/1 để đo khả năng xếp hạng. Nếu một fold chỉ có một lớp, hãy sửa phép đánh giá hoặc ghi rõ metric không xác định ở đó, không lặng lẽ thay bằng 1.
Hỏi nhanh
Hai mô hình xếp các mẫu theo đúng cùng một thứ tự score, chỉ khác nhau ở mức tự tin. ROC-AUC có phân biệt được hai mô hình này không?
AUC chỉ hỏi mẫu dương có được xếp trên mẫu âm hay không. Hai mô hình có cùng thứ tự score thì có cùng AUC, dù một bên tự tin hơn hẳn. Muốn chấm độ đúng của chính các xác suất, ta dùng một thước đo khác, chẳng hạn log loss ở mục sau.
Xác suất và nhiều lớp
Log loss chấm mức xác suất chứ không chỉ nhãn. Với binary classification,
ở đây là logarithm tự nhiên. Đoán sai rất tự tin bị phạt nặng: với một mẫu dương, cho loss , còn cho khoảng 0.916. Thư viện xử lý xác suất sát 0 hoặc 1 để tránh log(0); khi tự cài cần xem quy ước chính xác.
from sklearn.metrics import log_loss

truth = np.array([1, 0])
confident_wrong = np.array([0.01, 0.99])
less_confident_wrong = np.array([0.4, 0.6])
print(f'Sai rất tự tin: log loss={log_loss(truth, confident_wrong):.3f}')
print(f'Sai ít tự tin: log loss={log_loss(truth, less_confident_wrong):.3f}')
Sai rất tự tin: log loss=4.605
Sai ít tự tin: log loss=0.916
Ở ngưỡng 0.5, cả hai đều sai hai nhãn, nhưng log loss khác nhau rất xa.
Xác suất của model gọi là hiệu chỉnh tốt (well-calibrated) khi nó khớp tần suất thật: trong các mẫu được đoán khoảng 0.7, có khoảng 70% thật sự dương. Nếu trong 100 ca được đoán 0.9 mà chỉ 60 ca dương thật, model đang quá tự tin. Điều này phải kiểm trên nhiều mẫu, không nhìn một mẫu mà biết được. Hiệu chỉnh xác suất chỉ đổi các con số, không đổi thứ tự xếp hạng, nên không đổi AUC.
Với nhiều lớp, tính F1 cho từng lớp bằng cách coi lớp đó là dương, các lớp còn lại là âm. Trong confusion matrix nhiều lớp (hàng là nhãn thật, cột là dự đoán), precision của một lớp đọc theo cột của lớp ấy, recall đọc theo hàng. Rồi gộp lại thành một số theo một trong ba cách:
- Macro-F1: trung bình đều F1 của các lớp; lớp hiếm nặng ngang lớp đông.
- Weighted-F1: trung bình có trọng số theo số mẫu của từng lớp.
- Micro-F1: cộng TP, FP, FN của mọi lớp rồi mới tính; khi mỗi mẫu có đúng một nhãn, micro-F1 bằng accuracy.
Đề chấm macro-F1 thì báo macro-F1, đừng đổi sang weighted chỉ vì nó cao hơn.
Hỏi nhanh
Bài phân loại 3 lớp, đề chấm macro-F1. Lớp A chiếm 60% số mẫu, lớp B 35%, lớp C 5%. F1 của mô hình trên từng lớp là 0.95, 0.90 và 0.20. Weighted-F1 khoảng 0.90, còn macro-F1 chỉ 0.68. Ta nên làm gì tiếp?
Macro-F1 lấy trung bình đều ba lớp, nên lớp C hiếm kéo điểm xuống mạnh, và đó đúng là điều đề muốn đo. Nâng F1 của lớp C từ 0.20 lên 0.50 thì macro-F1 tăng 0.10, nhiều hơn mọi cải thiện còn có thể làm ở A hay B. Đổi sang metric khác hay gộp lớp là trả lời một câu hỏi khác với đề.
Lớp hiếm
Khi một lớp rất hiếm, model dễ lờ nó đi. Hai cách hay dùng:
class_weight: lỗi trên lớp hiếm bị tính nặng hơn khi học, không thêm bớt mẫu nào.class_weight='balanced'đặt trọng số cho lớp , với là tổng số mẫu, là số lớp, là số mẫu của lớp . Ví dụ 900 và 100 mẫu cho trọng số 0.56 và 5.- Resampling: nhân bản mẫu lớp hiếm hoặc bớt mẫu lớp đông. Chỉ làm trên train của mỗi fold; validation giữ nguyên tỉ lệ thật.
Cả hai đều không bảo đảm F1 tăng, nên vẫn phải đo trên validation và chọn lại ngưỡng.
Hỏi nhanh
Bài phát hiện gian lận có 9800 giao dịch hợp lệ và 200 giao dịch gian lận. Mô hình để mặc định thì đoán gần như tất cả là hợp lệ. Trong bốn cách sửa sau, cách nào vừa dễ làm vừa hiệu quả nhất?
class_weight khiến mỗi lỗi trên lớp gian lận bị tính nặng hơn khoảng 49 lần khi học, mà không thêm hay bớt dòng nào. Cách này rẻ và dùng được với hầu hết mô hình. Nhân bản mỗi mẫu gian lận 49 lần dễ khiến mô hình học thuộc đúng 200 mẫu ấy. Bỏ bớt dữ liệu là vứt đi 98% số giao dịch hợp lệ. Tạo mẫu giả có thể giúp, nhưng tốn công hơn và phải làm riêng trong từng fold. Dù chọn cách nào, ngưỡng vẫn phải chọn lại trên validation.
Khi đi thi
- Xem đề chấm metric nào: chấm ROC-AUC hay log loss thì nộp xác suất, đừng nộp nhãn 0/1.
- In confusion matrix và tỉ lệ lớp, không chỉ một con số tổng.
- Chọn threshold trên validation, rồi giữ nguyên threshold ấy khi dự đoán test.
Tóm tắt
- Precision: trong các cảnh báo, bao nhiêu đúng. Recall: trong các ca thật, phát hiện được bao nhiêu.
- F1 gộp precision và recall, không dùng TN.
- Chọn threshold trên validation; test dùng đúng ngưỡng đã chọn.
- ROC-AUC chấm thứ tự xếp hạng, log loss chấm xác suất, macro-F1 cho các lớp nặng ngang nhau.
Kiểm tra cuối bài
Câu 1
Có 10 000 giao dịch, trong đó 200 gian lận. Sau khi dùng class_weight, mô hình cho TP = 180, FP = 294, FN = 20, TN = 9506. Mỗi vụ gian lận bị bỏ sót gây thiệt hại khoảng 500 đơn vị. Mỗi cảnh báo nhầm chỉ tốn 1 đơn vị cho một lần kiểm tra bằng tay. Mô hình này có dùng được không?
Tổng thiệt hại là đơn vị. Nếu đoán mọi giao dịch là hợp lệ, thiệt hại là đơn vị. Precision 38% đúng là thấp, nhưng ở đây một lần báo nhầm rẻ hơn 500 lần một lần bỏ sót. Accuracy gần như không khác mô hình “đoán hết là hợp lệ” (98%), nên không nói lên gì. ROC-AUC chấm thứ tự score, không chấm ngưỡng ta đã chọn để dùng.
Câu 2
Khi nào ta thường nên dùng F1 thay cho accuracy?
Khi có lớp hiếm, accuracy bị lớp đông chi phối: đoán toàn lớp âm vẫn được điểm cao, như ví dụ 97% ở đầu bài. F1 chỉ nhìn TP, FP và FN của lớp dương, nên không bị số TN rất lớn che đi. Cỡ dữ liệu, loại mô hình hay số feature không quyết định việc chọn metric.
Câu 3
Có TP = 8, FP = 4, FN = 2. F1 của lớp dương bằng bao nhiêu?
. Precision là , recall là , còn là trung bình cộng của hai số ấy, không phải F1.
Câu 4
Một hệ thống có 98% giao dịch hợp lệ và 2% gian lận. Mô hình đoán tất cả là hợp lệ, nên accuracy là 98%. Bỏ sót gian lận thì tốn kém hơn báo nhầm. Ta kết luận được gì?
Lớp hợp lệ chiếm đa số, nên accuracy vẫn cao dù mọi vụ gian lận đều bị bỏ sót. Metric phải bám theo mục tiêu khi dùng thật và thiệt hại của từng loại lỗi. F1 cũng không tự động là lựa chọn tốt nhất.
Câu 5
Quy tắc ra nhãn là: gán nhãn 1 khi , với ngưỡng . Một mẫu có xác suất lớp dương nhận nhãn gì?
Quy tắc dùng dấu , nên trường hợp bằng đúng ngưỡng nhận nhãn 1. Khi viết code hay đọc đề, luôn ghi rõ dấu bằng nằm ở phía nào, vì score đúng bằng ngưỡng xuất hiện nhiều hơn ta tưởng.
Câu 6
Trên cùng tập validation, ta thử ba ngưỡng. Ngưỡng 0.3 cho FP = 30, FN = 2. Ngưỡng 0.5 cho FP = 12, FN = 6. Ngưỡng 0.7 cho FP = 4, FN = 12. Mỗi FP tốn 1 đơn vị, mỗi FN tốn 5 đơn vị, ngoài ra không có chi phí nào khác. Ta chọn ngưỡng nào?
Chi phí của ba ngưỡng lần lượt là , và . Ngưỡng 0.3 rẻ nhất. Đề tính theo chi phí, nên tổng số lỗi hay riêng số FP không phải là tiêu chí.
Câu 7
Xét 20 cặp gồm một mẫu dương và một mẫu âm. Có 12 cặp mẫu dương có score cao hơn, 4 cặp bằng nhau, 4 cặp thấp hơn. Cặp bằng nhau được tính nửa điểm. ROC-AUC bằng bao nhiêu?
. Bỏ qua các cặp bằng nhau thì ra 0.60. Tính chúng là thắng thì ra 0.80. Loại chúng khỏi mẫu số thì ra 0.75.
Câu 8
Đã có p = model.predict_proba(X)[:, 1], nhãn dương là 1. Tính ROC-AUC bằng dòng nào?
roc_auc_score nhận nhãn thật trước, rồi đến score chưa cắt ngưỡng. Cắt p >= 0.5 thì mất thông tin về thứ tự. Đảo hai đối số là đảo vai trò của nhãn và score. Còn score hằng số thì không xếp được mẫu nào trên mẫu nào.
Câu 9
Một mẫu có nhãn thật là 1. Mô hình A cho xác suất lớp 1 là 0.40, mô hình B cho 0.01. Ở ngưỡng 0.5, cả hai đều xếp mẫu này vào lớp 0. Theo log loss, mô hình nào bị phạt nặng hơn ở mẫu này?
Với nhãn thật là 1, log loss phạt . B sai mà gần như chắc chắn, nên bị phạt nặng hơn nhiều. Nhãn sau khi cắt ngưỡng không giữ được thông tin này.
Câu 10
Ba lớp có F1 là 0.90, 0.30 và 0.60. Số mẫu thật của chúng lần lượt là 80, 10 và 10. Macro-F1 bằng bao nhiêu?
Macro-F1 lấy trung bình đều các lớp: . Nếu lấy trung bình theo số mẫu thì được weighted-F1 là 0.81.
Đọc thêm
- scikit-learn - Classification metrics. Tra averaging, ROC-AUC, AP và log loss theo đúng dạng đầu vào.
- scikit-learn - Tuning the decision threshold. Đọc vì sao chọn threshold là một quyết định cần dữ liệu validation riêng.
- James và cộng sự - An Introduction to Statistical Learning, chương 4. Đọc ý nghĩa score phân loại và các loại lỗi.