Dữ liệu nhiều cột thường có những cột thay đổi cùng nhau. Ví dụ điểm toán và điểm lý của một lớp hay tăng giảm cùng nhau: vẽ lên mặt phẳng thì các điểm nằm gần một đường thẳng, nên thay hai số bằng một số (vị trí trên đường đó) chỉ mất ít thông tin. Giảm chiều (dimensionality reduction) làm việc này với dữ liệu nhiều chiều.
Bài này học PCA, cách vẽ dữ liệu nhiều chiều bằng t-SNE, UMAP, và trường hợp phần bị bỏ đi lại chứa đúng thông tin cần để dự đoán.
PCA: hướng có phương sai lớn nhất
Phân tích thành phần chính (Principal Component Analysis) tìm các hướng mà dữ liệu trải ra nhiều nhất. Ý tưởng: hướng nào dữ liệu ít thay đổi thì chiếu bỏ đi cũng ít mất thông tin.
Trước hết trừ trung bình để dữ liệu có tâm ở gốc tọa độ. Với ma trận dữ liệu đã trừ trung bình , ma trận hiệp phương sai (covariance) là
Ô trên đường chéo là phương sai của cột , vì hiệp phương sai của một biến với chính nó là phương sai; ô đo hai cột cùng tăng giảm với nhau mạnh đến đâu.
Chiếu mỗi điểm lên hướng đơn vị cho các số , có phương sai . Ta cần
Lời giải là hướng thỏa : là vector riêng (eigenvector) của , và phương sai thu được chính là trị riêng . Thành phần chính thứ nhất là vector riêng ứng với trị riêng lớn nhất; thành phần thứ hai là vector riêng kế tiếp, tự động vuông góc với thành phần thứ nhất; và cứ thế.
Giữ thành phần đầu, tỉ lệ phương sai giữ lại (explained variance ratio) là
Ba thành phần đầu giữ 60%, 25%, 10% thì giữ hai thành phần là giữ 85%. Cách chọn thường gặp: giữ đủ để đạt khoảng 95% phương sai, hoặc chọn bằng cross-validation nếu PCA là bước tiền xử lý cho một mô hình khác.
Tính thử trên bốn điểm đã có trung bình bằng 0: , , , . Ma trận hiệp phương sai là
Phương trình đặc trưng cho , . Thành phần thứ nhất giữ phương sai: bốn điểm gần như nằm trên một đường thẳng. Vector riêng tương ứng có thể chọn ; hướng ngược lại cũng biểu diễn cùng một trục.
Có một cách nhìn tương đương: trong các phép chiếu tuyến tính trực giao xuống chiều, PCA là phép chiếu làm tổng bình phương khoảng cách tái tạo nhỏ nhất. Giữ nhiều phương sai nhất và mất ít thông tin nhất là cùng một bài toán.
Hỏi nhanh
Dữ liệu hai chiều đã trừ trung bình có ma trận hiệp phương sai với hai trị riêng 4 và 1. Chiếu lên PC1 thì giữ được bao nhiêu phần phương sai, và tọa độ trên PC1 có độ lệch chuẩn bao nhiêu?
Tỉ lệ giữ lại là . Trị riêng là phương sai của tọa độ sau khi chiếu, nên độ lệch chuẩn là . Nhầm trị riêng với độ lệch chuẩn là lỗi hay gặp khi đọc kết quả PCA.
Tính bằng SVD
Có thể tránh lập bằng phân tích giá trị kỳ dị (singular value decomposition) của chính :
Các cột của là các thành phần chính, tọa độ mới của dữ liệu là , và trị riêng . Phương sai theo mỗi thành phần tỉ lệ với , không phải : giá trị kỳ dị 6 và 2 cho thành phần đầu .
Hỏi nhanh
SVD của dữ liệu đã trừ trung bình cho các giá trị kỳ dị . Giữ hai thành phần đầu thì giữ được bao nhiêu phần phương sai?
Trị riêng tỉ lệ với , tức 36, 9 và 1. Tỉ lệ giữ lại là . Ra là cộng thẳng các , quên bình phương. Hệ số chung thì triệt tiêu trong tỉ số.
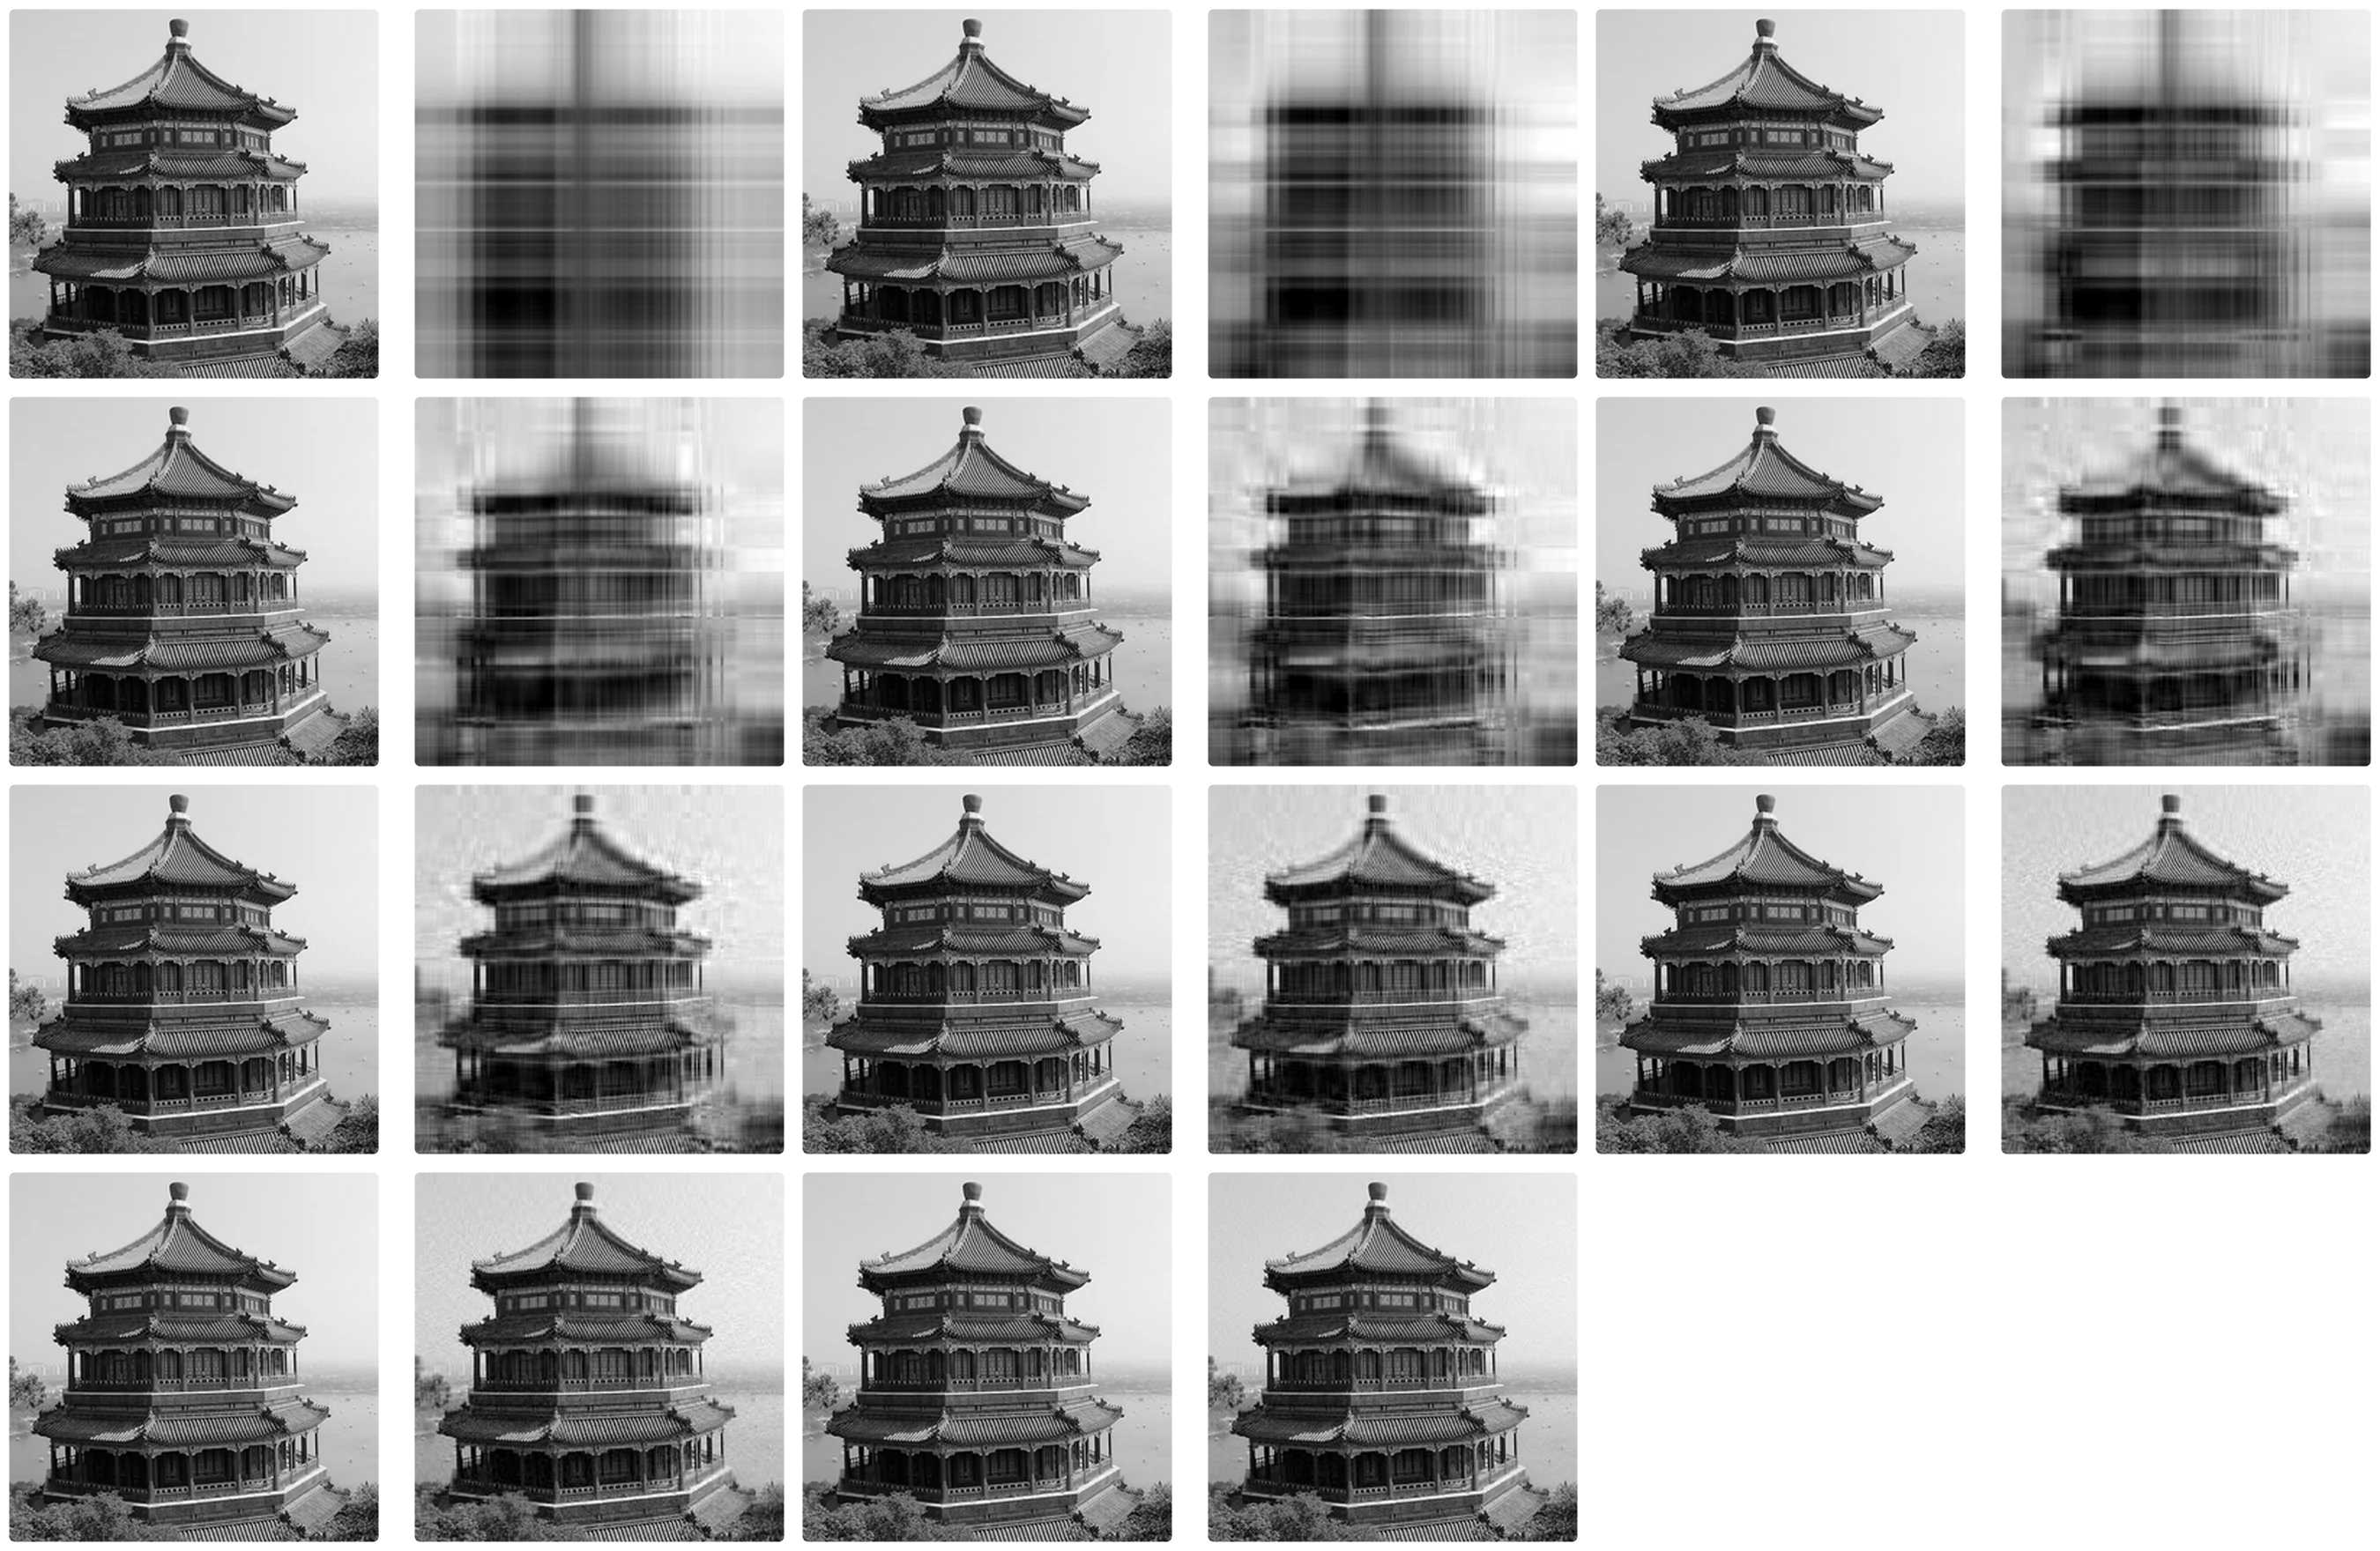
Lưu ý khi dùng PCA
- Chuẩn hóa nếu đơn vị khác nhau. Không chuẩn hóa thì một cột đo bằng đồng sẽ “nuốt” toàn bộ phương sai và thành phần chính chỉ là cột đó. Dời cả bảng đi một hằng số không đổi gì, vì PCA trừ trung bình trước; nhưng nhân riêng một cột với hằng số là đổi phương sai của cột đó và đổi các thành phần chính.
- PCA không biết nhãn. Hướng phương sai nhỏ có thể lại là hướng phân biệt các lớp (hình dưới). Giảm chiều quá tay trước khi phân loại có thể làm mất đúng thông tin cần thiết.
- Fit PCA trên train, rồi biến đổi validation và test bằng cùng phép chiếu, như mọi bước tiền xử lý khác (bài 1.4).
- Với dữ liệu thưa như TF-IDF, dùng
TruncatedSVDthay cho PCA để không phải trừ trung bình làm mất tính thưa. Kỹ thuật này có tên là latent semantic analysis.
Hỏi nhanh
Hai lớp chỉ khác nhau ở một cột có biến thiên rất nhỏ. Cột còn lại là nhiễu, biên độ lớn. PCA không dùng nhãn sẽ ưu tiên giữ hướng nào?
PCA tìm cách tái tạo dữ liệu tốt nhất, chứ không trực tiếp tìm accuracy cao nhất. Vì vậy số chiều giữ lại phải được chọn theo validation của bài toán dùng sau đó.
Hỏi nhanh
Có hai cột: thu nhập tính bằng đồng, độ lệch chuẩn cỡ , và tuổi, độ lệch chuẩn cỡ 10. Chạy PCA mà không chuẩn hóa. PC1 gần như là hướng nào?
Phương sai của thu nhập lớn hơn của tuổi cỡ lần, nên hướng trải rộng nhất gần như là trục thu nhập. Con số “giữ 99.99% phương sai” lúc này chỉ phản ánh đơn vị đồng. Phải chuẩn hóa trước thì PC1 mới nói lên quan hệ giữa hai cột.
t-SNE và UMAP: để nhìn, không phải để đo
PCA là phép chiếu tuyến tính, nên không “duỗi” được dữ liệu nằm trên mặt cong. t-SNE và UMAP là các phương pháp phi tuyến, cố giữ láng giềng gần của mỗi điểm khi đưa xuống 2 chiều. Chúng cho những hình rất đẹp: các cụm tách bạch rõ ràng. Nhưng đọc hình phải cẩn thận:
- Kích thước cụm và khoảng cách giữa các cụm trên hình gần như không mang ý nghĩa.
- Kết quả phụ thuộc tham số (
perplexitycủa t-SNE,n_neighborscủa UMAP) và seed ngẫu nhiên. Chạy vài cấu hình trước khi kết luận. - Triển khai t-SNE trong scikit-learn không có transform cho điểm mới, nên không dùng làm đặc trưng cho train/test. UMAP thì có
transform, nhưng vẫn nên ưu tiên PCA khi cần đặc trưng ổn định.
Hỏi nhanh
Trên hình t-SNE, cụm A nằm rất xa cụm B, còn A thì sát C. Ta được phép kết luận gì?
t-SNE cố giữ các láng giềng gần của từng điểm. Khoảng cách giữa các cụm và kích thước cụm trên hình gần như không mang thông tin. Muốn so A với B và C, hãy đo trong không gian gốc hoặc trên PCA, và thử vài giá trị perplexity, vài seed.
| PCA | t-SNE | UMAP | |
|---|---|---|---|
| Loại | Tuyến tính | Phi tuyến | Phi tuyến |
| Giữ | Cấu trúc toàn cục, phương sai | Láng giềng gần | Láng giềng gần, phần nào cấu trúc toàn cục |
| Áp lên điểm mới | Có | Không | Có |
| Dùng chủ yếu để | Tiền xử lý, nén, khử nhiễu | Trực quan hóa | Trực quan hóa, đôi khi làm đặc trưng |
Tự cài PCA bằng NumPy
Với X có hàng, cột, các bước kèm shape:
- Trừ trung bình từng cột (vector shape
(d,)) để dữ liệu có tâm ở 0, đượcX_centered. - SVD của
X_centeredvớifull_matrices=FalsechoU,s,Vt. Hàng đầu củaVtlà PC1, shape(d,). - Giữ hướng:
Vt[:k].Tcó shape(d, k). NhânX_centeredvới nó, mỗi mẫu còn tọa độ. - Tái tạo: nhân tọa độ với ma trận chuyển vị, rồi cộng lại trung bình.
Code dưới chạy trên bốn điểm ở mục PCA và đối chiếu với scikit-learn.
import numpy as np
from sklearn.decomposition import PCA

X_pca = np.array([[-2., -1.], [-1., -1.], [1., 1.], [2., 1.]])
center = X_pca.mean(axis=0)
X_centered = X_pca - center
U, s, Vt = np.linalg.svd(X_centered, full_matrices=False)
components = Vt[:1].T
coordinates = X_centered @ components
reconstructed = coordinates @ components.T + center
ratio = s[0] ** 2 / np.sum(s ** 2)
library = PCA(n_components=1).fit(X_pca)
print("shape:", components.shape, coordinates.shape, reconstructed.shape)
print("tỉ lệ:", round(float(ratio), 4))
print("MSE tái tạo:", round(float(np.mean((reconstructed - X_pca) ** 2)), 6))
print("khớp tái tạo:", np.allclose(reconstructed, library.inverse_transform(library.transform(X_pca))))
shape: (2, 1) (4, 1) (4, 2)
tỉ lệ: 0.9792
MSE tái tạo: 0.036475
khớp tái tạo: True
Hai điểm hay bị tưởng là lỗi:
- Dấu ngược. SVD có thể cho thay vì . Hai vector mô tả cùng một đường: tọa độ đổi dấu nhưng dữ liệu tái tạo không đổi. Vì vậy so hai cách cài PCA bằng dữ liệu tái tạo, không so từng hệ số.
- Mẫu số . scikit-learn tính phương sai với mẫu số , bài này dùng . Tỉ lệ giữ lại không đổi vì mọi trị riêng cùng nhân một hệ số.
Dùng thư viện
import numpy as np
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

X, y = load_digits(return_X_y=True)          # 1797 ảnh 8×8 = 64 chiều
for name, data in [("thô", X), ("chuẩn hóa", StandardScaler().fit_transform(X))]:
    pca = PCA().fit(data)
    k = np.searchsorted(np.cumsum(pca.explained_variance_ratio_), 0.95) + 1
    print(f"{name}: cần {k} trên 64 thành phần để giữ 95% phương sai")
thô: cần 29 trên 64 thành phần để giữ 95% phương sai
chuẩn hóa: cần 40 trên 64 thành phần để giữ 95% phương sai
Chuẩn hóa làm cần nhiều thành phần hơn. Các pixel ở viền ảnh gần như luôn trắng, phương sai rất nhỏ; chuẩn hóa chia chúng cho độ lệch chuẩn bé xíu nên chúng thành những chiều có phương sai 1, ngang các pixel giữa ảnh chứa nét chữ. Ở ảnh, các pixel đã cùng đơn vị, nên chuẩn hóa không bắt buộc và cần kiểm bằng validation.
Ví dụ này cũng cho thấy “giữ 95% phương sai” là 95% tổng phương sai theo thang đo đang dùng: đổi thang thì con số đổi. Nó không phải 95% thông tin về nhãn, và không bảo đảm accuracy còn 95%.
Hỏi nhanh
Với bộ digits, dữ liệu thô cần 29 thành phần để giữ 95% phương sai, còn dữ liệu đã chuẩn hóa cần tới 40. Vì sao chuẩn hóa lại cần nhiều hơn?
Sau khi chuẩn hóa, pixel nào cũng có phương sai 1, kể cả những pixel ở viền gần như không đổi. Tổng phương sai trải đều hơn trên 64 chiều, nên phải giữ nhiều thành phần hơn mới đủ 95%. Con số 95% luôn gắn với thang đo đang dùng.
Khi đi thi
- Fit scaler và PCA trên train của từng fold, rồi transform phần còn lại.
- Embedding hàng nghìn chiều thì thử PCA xuống vài trăm chiều; chỉ giữ nếu validation không tụt.
- Dùng t-SNE, UMAP để nhìn, không đưa tọa độ của chúng làm feature.
Tóm tắt
- PCA chiếu dữ liệu lên các hướng có phương sai lớn nhất, chính là các vector riêng của ma trận hiệp phương sai; tính bằng SVD.
- Tỉ lệ phương sai giữ lại giúp chọn số chiều; chuẩn hóa trước khi đơn vị khác nhau; fit trên train.
- PCA không dùng nhãn, nên có thể bỏ mất hướng phân biệt lớp.
- t-SNE, UMAP dùng để nhìn cấu trúc láng giềng; không đọc khoảng cách giữa cụm, không dùng t-SNE làm đặc trưng.
Kiểm tra cuối bài
Mười câu kiểm cả cách hiểu, phép tính và quy trình. Câu sai chỉ ra phần cần đọc lại; hãy làm trước khi mở lời giải.
Câu 1
PCA fit trên X_train có shape (120, 7) và giữ 3 thành phần. Transform X_valid có shape (40, 7) thì đầu ra có shape gì?
Số hàng theo dữ liệu đang transform, số cột theo n_components đã học. PCA không bắt validation phải có cùng số mẫu với train.
Câu 2
Tự cài PCA bằng SVD. Với X có shape (n, d), dòng nào trừ trung bình đúng cho từng feature?
PCA thông thường trừ trung bình của từng cột. Trừ trung bình từng mẫu, trừ trung bình cả bảng, hay chỉ chia cho độ lệch chuẩn là ba phép biến đổi khác.
Câu 3
PCA có ba trị riêng là 6, 3 và 1. Giữ hai thành phần đầu thì giữ được bao nhiêu phần phương sai?
. Ra 0.6 là chỉ tính PC1. Ra 0.3 là tỉ lệ của riêng PC2.
Câu 4
Với , vector đơn vị cùng hướng với là gì?
Độ dài của là . Chia cho độ dài thì giữ nguyên hướng, còn đổi dấu cả vector là thành hướng ngược lại. Mỗi thành phần chính trong PCA đều là một vector đơn vị như vậy.
Câu 5
Trên cùng các fold, hai cấu hình PCA giữ 95% và 99% phương sai có accuracy validation lần lượt là 0.88 và 0.84. Ta chọn theo accuracy. Kết luận nào đúng?
Phương sai mô tả , không trực tiếp nói gì về tín hiệu cho . Ta quyết định dựa trên kết quả đánh giá của bài toán sau PCA.
Câu 6
Code fit PCA trên toàn bộ X_dev, rồi mới chạy cross_val_score cho classifier. Sửa thế nào để PCA không học thống kê từ fold validation?
Không dùng nhãn không có nghĩa là không học gì từ dữ liệu. PCA phải fit trên phần train của từng fold, rồi dùng đúng phép chiếu ấy cho phần validation.
Câu 7
Ma trận hiệp phương sai chia cho hay thì tỉ lệ phương sai giữ lại có đổi không?
Mọi trị riêng cùng nhân với một hệ số, và hệ số chung ấy triệt tiêu khi chia cho tổng các trị riêng.
Câu 8
Mặc định, TruncatedSVD trên ma trận TF-IDF có trừ trung bình như PCA không?
Trừ trung bình biến hầu hết các số 0 thành khác 0, nên ma trận thưa thành ma trận dày và tràn bộ nhớ. TruncatedSVD phân rã ma trận mà không trừ trung bình, nên kết quả không trùng với PCA.
Câu 9
UMAP vẽ một bản đồ 2 chiều cho các embedding. Khi đọc khoảng cách trên hình, câu nào đúng với điều UMAP ưu tiên?
Hình giúp ta khảo sát cấu trúc lân cận. Khoảng cách toàn cục và khoảng cách giữa các cụm thì phải đọc thận trọng, và kiểm lại với vài tham số, vài seed. UMAP là phép chiếu phi tuyến, và mục tiêu của nó không phải lỗi tái tạo.
Câu 10
PCA tự cài cho một thành phần đúng bằng âm của thành phần mà thư viện cho, còn trị riêng và trung bình thì khớp. Đối chiếu thế nào để kiểm đúng phép chiếu, thay vì chỉ so hướng?
và cho cùng một phép chiếu . Tọa độ cũng đổi dấu theo, nên dữ liệu tái tạo vẫn y như cũ. Đổi dấu từng phần tử riêng lẻ thì không phải là đổi hướng cả vector.
Đọc thêm
- James, Witten, Hastie, Tibshirani - An Introduction to Statistical Learning, chương 12. PCA từ góc nhìn thống kê, kèm cách đọc explained variance.
- Géron - Hands-On Machine Learning, chương 8. PCA, randomized PCA và các phương pháp giảm chiều khác trong scikit-learn.
-
van der Maaten, Hinton (2008) - Visualizing Data using t-SNE; McInnes và cộng sự (2018) - UMAP. Bài gốc của hai phương pháp trực quan hóa.
-
scikit-learn - PCA. Centering, SVD, explained variance và quan hệ với sparse data.
- Distill - How to Use t-SNE Effectively. Các thí nghiệm trực quan giúp tránh đọc quá mức hình t-SNE.