Một căn chung cư 70 m², cách trung tâm 8 km, rao bán 4,2 tỷ. Giá đó cao hay thấp? Nếu có giá của 200 căn đã bán quanh đó, ta có thể ước lượng: căn rộng hơn thì đắt hơn, xa trung tâm thì rẻ hơn. Linear regression (hồi quy tuyến tính) viết cách ước lượng ấy thành công thức và tìm hệ số từ dữ liệu. Đây là model đơn giản nhất của học máy, và các model sau, từ logistic regression tới mạng neural, đều dùng lại ý của nó.
Dữ liệu và mô hình
Ta bắt đầu từ dữ liệu. Để không phải tải dữ liệu từ Internet, ta tự sinh 200 căn hộ theo một công thức định giá có sẵn: giá (tỷ đồng), cộng thêm một chút nhiễu. Như vậy ta biết trước đáp án và kiểm được model học đúng hay sai.
import numpy as np

rng = np.random.default_rng(0)
n = 200
area = rng.uniform(30, 120, n)                                # diện tích, m²
dist = rng.uniform(1, 15, n)                                  # khoảng cách đến trung tâm, km
y = 0.05 * area - 0.15 * dist + 1.0 + rng.normal(0, 0.3, n)   # giá, tỷ đồng

X = np.column_stack([area, dist])
print(X.shape, y.shape)
print(X[:3].round(1))
print(y[:3].round(2))
(200, 2) (200,)
[[87.3 5.5]
[54.3 3.6]
[33.7 10.4]]
[4.48 3. 1.28]
Ý tưởng của mô hình: mỗi đặc trưng đóng góp vào giá một lượng tỉ lệ với nó, rồi cộng tất cả lại. Viết thành công thức, với mỗi mẫu có đặc trưng (ở ví dụ này : diện tích và khoảng cách), mô hình dự đoán
là vector trọng số (weights), là hệ số tự do (bias, intercept). là giá trị dự đoán khi mọi đặc trưng bằng 0, và cũng được học như trọng số; model có trọng số cộng 1 bias, tức tham số. Một nơ-ron ở chương 3 cũng tính đúng tổng có trọng số này: đầu vào 2 và 3, trọng số 1 và 2, bias 0 cho .
Đọc như sau: nếu tăng thêm một đơn vị trong khi mọi đặc trưng khác giữ nguyên, thì dự đoán tăng thêm . Điều kiện “giữ nguyên” rất quan trọng; cuối bài sẽ quay lại điểm này.
Khi tính cho cả mẫu một lúc, ta xếp các mẫu thành các hàng của ma trận , ở đây là 200 hàng, 2 cột:
là một vector, còn là một số: phép cộng ở đây là cộng vào từng phần tử, vì căn nào cũng được cộng cùng một khoản . NumPy cũng tự làm đúng như vậy.
Trước khi viết code, nên ghi rõ shape của từng đại lượng. Trong C++ kích thước mảng được khai báo tường minh; NumPy thì không yêu cầu, nên người viết phải tự kiểm soát.
| Ký hiệu | Ý nghĩa | Shape |
|---|---|---|
| Ma trận đặc trưng, mỗi hàng một mẫu | (n, d) |
|
| Trọng số | (d,) |
|
| Bias | số thực | |
| Dự đoán | (n,) |
|
| Giá trị thật | (n,) |
Cách viết (d,) là NumPy đang nói “mảng một chiều có phần tử”. Cả khóa này ta thống nhất: vector là mảng một chiều (n,), không dùng mảng cột (n, 1). Lý do được giải thích ở phần bẫy cài đặt.
Hỏi nhanh
X có shape (200, 2), w có shape (2,). X @ w + b có shape gì?
Mỗi hàng của X nhân vô hướng với w cho ra một số, nên 200 hàng cho 200 số. Chọn (200, 1) là nhầm theo thói quen viết vector cột trong sách toán. NumPy không tự sinh thêm chiều thứ hai ấy.
Hàm mất mát
Muốn chọn và “tốt nhất” thì trước hết phải nói rõ thế nào là tốt. Với mỗi căn, ta đo độ lệch giữa dự đoán và giá thật, gọi là phần dư (residual) . Rồi lấy trung bình bình phương các phần dư, gọi là sai số bình phương trung bình (mean squared error):
là loss của bài này: một con số đo dự đoán đang lệch đáp án bao nhiêu; học là tìm làm loss nhỏ nhất. Bài hồi quy đo độ lệch giữa hai con số, như MSE; bài phân loại đo xác suất model dành cho nhãn đúng, như cross-entropy ở bài 2.3.
Vì sao bình phương mà không dùng trị tuyệt đối? Trị tuyệt đối cũng dùng được, và hay được chọn khi dữ liệu có nhiều điểm bất thường. Nhưng bình phương có hai ưu điểm. Nó trơn, có đạo hàm tại mọi điểm, nên có công thức nghiệm và dễ tối ưu bằng gradient. Nó phạt lỗi lớn nặng hơn hẳn lỗi nhỏ: sai 10 bị phạt 100, gấp bốn lần sai 5. Cái giá là MSE rất nhạy với điểm ngoại lai (outlier): một căn bị nhập nhầm giá có thể kéo lệch cả đường thẳng.
Viết hai hàm nhỏ, rồi thử mô hình đơn giản nhất có thể: đoán mọi căn đều có giá bằng giá trung bình.
def predict(X, w, b):
    return X @ w + b

def mse(y_hat, y):
    return np.mean((y_hat - y) ** 2)

print(mse(np.full(n, y.mean()), y))   # đoán mọi căn đều có giá trung bình
print(y.var())
2.34147721596206
2.34147721596206
Hai con số bằng nhau, và đây không phải trùng hợp: phương sai được định nghĩa đúng là trung bình bình phương độ lệch so với giá trị trung bình, tức là MSE của mô hình đoán trung bình. Con số này là mốc so sánh: mô hình nào có MSE không thấp hơn mốc này thì chưa học được gì. Người ta đo mức thắng bằng hệ số xác định : bằng 0 là ngang với đoán theo trung bình, bằng 1 là đoán trúng hết.
Hỏi nhanh
Đổi đơn vị giá từ tỷ đồng sang triệu đồng, tức nhân mọi với 1000. MSE thay đổi thế nào?
Đơn vị của MSE là bình phương đơn vị của , ở đây là tỷ đồng bình phương. Đổi sang triệu thì mỗi phần dư nhân 1000, bình phương lên thành . Vì thế khi báo cáo, người ta hay dùng , cùng đơn vị với giá, hoặc dùng , không phụ thuộc đơn vị.
Nghiệm đóng
Với MSE, bài toán tìm và có lời giải chính xác bằng công thức, gọi là nghiệm đóng. Trước tiên là một kỹ thuật sẽ dùng lại nhiều lần: thêm vào một cột toàn số 1. Gọi ma trận mới là (shape (n, d+1)) và gộp ; khi đó , và chỉ còn là một trọng số như mọi trọng số khác, nhân với cột số 1.
là hàm bậc hai lồi theo , hình dung như một cái bát. Gradient, ký hiệu , là vector gồm đạo hàm của theo từng tham số; nó chỉ hướng mà tăng nhanh nhất. Đáy bát là nơi gradient bằng 0. Nếu chưa quen đạo hàm theo vector, hãy nghĩ như với một biến: có đạo hàm . Bản ma trận dưới đây chỉ là thay bằng và thêm chuyển vị cho khớp chiều:
Đây là hệ phương trình chuẩn (normal equation), gồm phương trình với ẩn. Nếu khả nghịch thì nghiệm là . Code dưới giải hệ này bằng np.linalg.solve, không tính nghịch đảo. (Trong thực tế, np.linalg.lstsq(Xb, y, rcond=None) giải thẳng bài least squares và ổn định hơn về số.)
Xb = np.column_stack([X, np.ones(n)])            # thêm cột 1, shape (200, 3)
theta = np.linalg.solve(Xb.T @ Xb, Xb.T @ y)     # giải hệ phương trình chuẩn
w_cf, b_cf = theta[:2], theta[2]
print(w_cf.round(4), round(b_cf, 4))
print(mse(predict(X, w_cf, b_cf), y))
print(predict(np.array([70, 8]), w_cf, b_cf))    # căn hộ ở đầu bài
[ 0.0499 -0.1453] 0.9809
0.0880761518040597
3.309815169606735
Ba con số đầu, , và , rất gần với hệ số trong công thức sinh dữ liệu. Mô hình đã khôi phục gần đúng công thức đó chỉ từ 200 ví dụ.
MSE còn lại là , xấp xỉ phương sai của nhiễu (): phần còn lại chính là nhiễu, không model nào đoán được (bài 1.2).
Còn căn hộ ở đầu bài? Model định giá khoảng 3,3 tỷ. Giá rao 4,2 tỷ cao hơn 0,9 tỷ, gấp ba lần độ lệch chuẩn của nhiễu, nên khó coi là giá rẻ.
Phương trình chuẩn có một cách hiểu hình học. Coi là một vector trong không gian chiều; các cột của sinh ra một “mặt phẳng” trong không gian đó, và mọi dự đoán có thể có đều nằm trên mặt phẳng ấy. Least squares chọn đúng cái bóng của khi chiếu vuông góc xuống. Khó hình dung chiều thì cứ nghĩ : là một mũi tên trong phòng, các dự đoán nằm trên mặt sàn, và nghiệm là bóng của mũi tên khi đèn chiếu thẳng từ trên xuống. Phương trình chuẩn thật ra chỉ nói một điều: phần dư vuông góc với mọi cột. Vì một trong các cột là cột số 1, nên tổng các phần dư luôn bằng 0. Chỗ đoán cao và chỗ đoán thấp luôn bù trừ nhau.
Với một đặc trưng, hệ phương trình chuẩn rút gọn thành công thức tính được trên giấy:
Lấy ba điểm , , : , . Tử số bằng , mẫu số bằng . Vậy , , đường hồi quy là với .
Nghiệm đóng không phải lúc nào cũng dùng được. Khi có đặc trưng là tổ hợp tuyến tính của các đặc trưng khác (đa cộng tuyến, multicollinearity), hoặc khi số đặc trưng nhiều hơn số mẫu, không khả nghịch và bài toán có vô số nghiệm. np.linalg.lstsq hay np.linalg.pinv vẫn trả về một nghiệm (trong vô số nghiệm, nó chọn vector ngắn nhất), còn cách chữa tận gốc là regularization ở bài 2.2. Ngoài ra, chi phí của nó là : vài trăm đặc trưng thì tức thì, vài chục nghìn đặc trưng thì quá chậm.
Hỏi nhanh
Thêm vào X một cột “diện tích tính bằng dm²”, đúng bằng 100 lần cột diện tích. Nghiệm đóng sẽ ra sao?
Cột mới chỉ là cột cũ nhân 100, không thêm chút thông tin nào. Có vô số cách chia trọng số giữa hai cột mà dự đoán vẫn y hệt, nên suy biến. Nhờ sai số làm tròn, solve đôi khi vẫn chạy, nhưng trả về những hệ số rất lớn, trái dấu, triệt tiêu lẫn nhau. Thấy hệ số lớn bất thường thì nên nghĩ ngay tới chuyện các cột phụ thuộc nhau.
Gradient descent
Nghiệm đóng chỉ có với MSE, và phải giải một hệ . Sang các bài sau, loss phức tạp hơn, dữ liệu lớn hơn, sẽ không còn công thức nào để giải ngay nữa. Khi đó cần một phương pháp tổng quát: gradient descent, thuật toán dùng để huấn luyện mọi mạng neural.
Hình dung một người đứng trên sườn núi trong sương mù, không thấy đáy thung lũng ở đâu, chỉ cảm nhận được độ dốc dưới chân. Cách hợp lý là bước một bước nhỏ về phía dốc xuống, cảm nhận lại, rồi bước tiếp. Gradient chỉ hướng dốc lên nhanh nhất, nên ta đi ngược nó.
Ở đây tách riêng để thấy rõ từng thành phần. Đặt ; theo quy tắc đạo hàm hàm hợp (chain rule) , cộng lại rồi chia :
Mỗi bước, ta cập nhật với tốc độ học (learning rate) :
Đọc công thức thành lời: phần dư được “chia” về cho từng trọng số, đặc trưng nào góp phần gây lỗi nhiều thì trọng số của nó bị chỉnh nhiều. Khi đoán cao, dương, gradient của dương, bị trừ bớt và dự đoán hạ xuống. Ví dụ với một tham số: , gradient bằng 4, thì mới . Mỗi bước ở đây dùng cả tập dữ liệu, nên thứ tự các mẫu không ảnh hưởng gì; thứ tự chỉ quan trọng khi mỗi bước chỉ dùng một phần dữ liệu (bài 3.5).
Trong code, ta gộp và vào một mảng theta (bias ở cuối, cùng thứ tự với nghiệm đóng) cho các hàm gọn hơn. Mỗi vòng lặp dùng toàn bộ dữ liệu để tính gradient một lần, và người ta gọi một vòng như thế là một epoch:
def loss(theta, X, y):                   # theta = (w_1, ..., w_d, b)
    return mse(predict(X, theta[:-1], theta[-1]), y)

def grad(theta, X, y):
    weights = theta[:-1]
    bias = theta[-1]
    residual = predict(X, weights, bias) - y  # (n,)
    grad_weights = 2 * (X.T @ residual) / len(y)  # (d,)
    grad_bias = 2 * residual.mean()               # một số
    return np.append(grad_weights, grad_bias)

def gd(X, y, lr, epochs):
    theta = np.zeros(X.shape[1] + 1)
    history = []
    for _ in range(epochs):
        history.append(loss(theta, X, y))
        theta -= lr * grad(theta, X, y)
    return theta, history
Trước khi chạy, lưu ý rằng grad là hàm dễ sai nhất trong ba hàm trên: nhầm dấu, quên hệ số 2, gõ X @ r thay vì X.T @ r. Đáng ngại là viết sai mà code vẫn chạy, loss vẫn có thể giảm, chỉ là giảm về sai chỗ. Mục kiểm tra gradient bên dưới trình bày cách phát hiện các lỗi này.
Thử một bước trên ba điểm , , của mục trước, xuất phát từ với . Lúc này , nên và
Sau một bước: , , mất mát giảm từ xuống , đã gần nghiệm đóng , . Một bước đã gần tới đích chỉ vì bài toán quá nhỏ và quá đẹp; dữ liệu thật thường cần hàng trăm, hàng nghìn bước.
Hỏi nhanh
Đặt r = y_hat - y. Dòng nào cập nhật bias đúng?
r.mean() dương nghĩa là mô hình đang đoán cao, nên phải hạ b xuống, tức là dấu trừ. r.sum() lớn gấp lần r.mean(), giống như nhân learning rate lên 200 lần. Còn b -= lr * r trừ đi cả một vector, biến b thành 200 số thay vì một bias chung.
Kiểm tra gradient
Làm sao biết hàm grad đúng? Cách làm giống viết code trâu để đối chiếu trong lập trình thi đấu. Đạo hàm là giới hạn của tỉ sai phân, nên chỉ cần gọi hàm loss là xấp xỉ được gradient, chậm nhưng khó sai. Với là vector đơn vị thứ :
Dịch về cả hai phía như thế (sai phân trung tâm, central difference) cho sai số : giảm đi 10 lần thì sai số giảm 100 lần. Dịch một phía chỉ đạt , giảm 10 lần thì sai số cũng chỉ giảm 10 lần. Chọn khoảng là vừa; nhỏ quá thì phép trừ hai số gần bằng nhau lại sinh sai số làm tròn. Hai vector gradient được so bằng sai số tương đối, với là độ dài vector:
Sai số cỡ trở xuống là gradient gần như chắc đúng; cỡ trở lên thì công thức gradient nhiều khả năng sai.
def numerical_grad(f, theta, h=1e-5):
    g = np.zeros_like(theta)
    for j in range(len(theta)):
        e = np.zeros_like(theta)
        e[j] = h
        g[j] = (f(theta + e) - f(theta - e)) / (2 * h)
    return g

def rel_error(a, b):
    return np.linalg.norm(a - b) / (np.linalg.norm(a) + np.linalg.norm(b))

theta0 = rng.normal(size=3)                    # một điểm bất kỳ
f = lambda t: loss(t, X, y)
print(rel_error(grad(theta0, X, y), numerical_grad(f, theta0)))

def grad_buggy(theta, X, y):                   # quên hệ số 2
    r = predict(X, theta[:-1], theta[-1]) - y
    return np.append(1 / len(y) * X.T @ r, r.mean())

print(rel_error(grad_buggy(theta0, X, y), numerical_grad(f, theta0)))
7.159601417180615e-13
0.3333333333335514
Bản đúng lệch cỡ , bản quên hệ số 2 lệch đúng . Cách kiểm này tốn lần tính loss nên chỉ dùng để kiểm trên dữ liệu nhỏ, không dùng để huấn luyện. Với linear regression, bước này có vẻ thừa; nhưng khi tự viết backpropagation ở Chương 3, đây là cách nhanh nhất để biết đạo hàm đúng hay sai.
Hỏi nhanh
Vì sao ta dùng sai phân trung tâm thay vì ?
Khai triển Taylor và rồi trừ cho nhau, các số hạng bậc chẵn triệt tiêu, chỉ còn sai số bậc ba chia cho . Cái giá là phải tính loss hai lần.
Chọn learning rate
Gradient đã được kiểm tra, giờ chạy gradient descent. Câu hỏi đầu tiên là chọn learning rate bao nhiêu. Thử trên dữ liệu gốc với ba giá trị:
for lr in [1e-3, 2e-4, 1e-4]:
    theta_gd, hist = gd(X, y, lr, 1000)
    print(f"lr = {lr:g}: loss sau 1000 vòng = {hist[-1]:.4g}")
print(theta_gd.round(3))                      # lr = 1e-4
lr = 0.001: loss sau 1000 vòng = nan
lr = 0.0002: loss sau 1000 vòng = inf
lr = 0.0001: loss sau 1000 vòng = 0.1541
[ 0.057 -0.107 0.01 ]
Hai learning rate đầu làm loss nổ tung: inf là vô cùng, còn nan (not a number) là kết quả của những phép như vô cùng trừ vô cùng. Khi chạy trên notebook, NumPy còn in cảnh báo overflow (tràn số). Cái thứ ba không nổ, nhưng sau 1000 vòng loss vẫn còn , trong khi đáy là . Riêng mới đi được trên quãng đường tới .
Khoảng learning rate dùng được rất hẹp, nhưng có thể tính trước mà không cần thử. là hàm bậc hai, nên ma trận Hessian (ma trận đạo hàm bậc hai) của nó là hằng số . Gọi sai số là hiệu giữa vị trí hiện tại và đáy. Phân tích sai số theo các vector riêng của thì thấy: ứng với trị riêng , mỗi bước gradient descent nhân sai số với . Muốn mọi thành phần đều co lại, cần với mọi , tức là
Nếu chưa học trị riêng, có thể hiểu là độ cong của cái bát theo một hướng nào đó: hướng nào cong gắt thì bước chân phải ngắn, không thì bước qua đáy rồi văng lên vách bên kia, mỗi lần một xa hơn. Kết luận dùng được ngay; chứng minh chặt chẽ thuộc về đại số tuyến tính. Với thì nên cần : nhân với mỗi bước, từ thành rồi . Loss lúc giảm lúc tăng, dao động mà không hội tụ là dấu hiệu learning rate quá lớn; quá nhỏ thì loss giảm đều nhưng rất chậm.
Tính thử cho dữ liệu căn hộ:
H = 2 / n * Xb.T @ Xb
eig = np.linalg.eigvalsh(H)          # trị riêng, xếp tăng dần
print(2 / eig[-1])                    # learning rate lớn nhất còn hội tụ
print(eig[-1] / eig[0])               # số điều kiện
0.0001434720214166643
99638.12391867978
Ngưỡng là . Learning rate vượt ngưỡng nên nổ, nằm dưới nên hội tụ, khớp đúng với thí nghiệm.
Con số thứ hai là số điều kiện (condition number) , và nó giải thích vì sao hội tụ chậm. Mặt loss lúc này là một thung lũng dài và hẹp: theo chiều này, độ cong lớn gấp khoảng trăm nghìn lần chiều kia. Bước chân phải đủ nhỏ để khỏi văng ra khỏi vách dốc, mà nhỏ như thế thì theo chiều thoải gần như đứng yên tại chỗ.
Hỏi nhanh
Linear regression tối ưu MSE, loss qua các vòng là 15.9, 41.2, 260, 17 000, rồi NaN. Shape và công thức gradient đều đã kiểm. Ta nên thử gì trước?
Mỗi vòng loss bị nhân lên một bội ngày càng lớn, tức là cập nhật đang mất ổn định. Hai nghi phạm hàng đầu là learning rate quá lớn và các feature chênh thang đo. Chỉ nhìn dãy loss thì chưa biết chắc là cái nào, nên thử cả hai.
Chuẩn hóa đặc trưng
Nguyên nhân làm thung lũng hẹp là thang đo. Diện tích tính bằng m², cỡ vài chục đến hơn trăm; khoảng cách cỡ vài km; cột bias thì luôn bằng 1. Ba thang đo chênh nhau quá xa. Cách chữa là chuẩn hóa (standardization) mọi đặc trưng về trung bình 0, độ lệch chuẩn 1.
mu, sigma = X.mean(axis=0), X.std(axis=0)
Xs = (X - mu) / sigma
Xsb = np.column_stack([Xs, np.ones(n)])
eig_s = np.linalg.eigvalsh(2 / n * Xsb.T @ Xsb)
print(2 / eig_s[-1], eig_s[-1] / eig_s[0])

for lr in [0.01, 0.1, 0.5, 1.0]:
    theta_s, hist = gd(Xs, y, lr, 100)
    print(f"lr = {lr:g}: loss sau 100 vòng = {hist[-1]:.4g}")
0.951931951010249 1.1063612539062566
lr = 0.01: loss sau 100 vòng = 0.3736
lr = 0.1: loss sau 100 vòng = 0.08808
lr = 0.5: loss sau 100 vòng = 0.08808
lr = 1: loss sau 100 vòng = 3.703e+08
So với dữ liệu gốc: số điều kiện rơi từ xuống , thung lũng hẹp đã thành một cái bát gần tròn, và ngưỡng learning rate tăng từ lên . Đo cụ thể hơn: để loss xuống sát đáy (trong vòng 0.1%), dữ liệu gốc cần khoảng 180 nghìn vòng dù learning rate đã chọn sát ngưỡng, còn dữ liệu chuẩn hóa với chỉ cần 28 vòng. Nhanh hơn khoảng sáu nghìn lần, chỉ nhờ hai dòng code. Còn vượt ngưỡng nên vẫn nổ, đúng như lý thuyết.
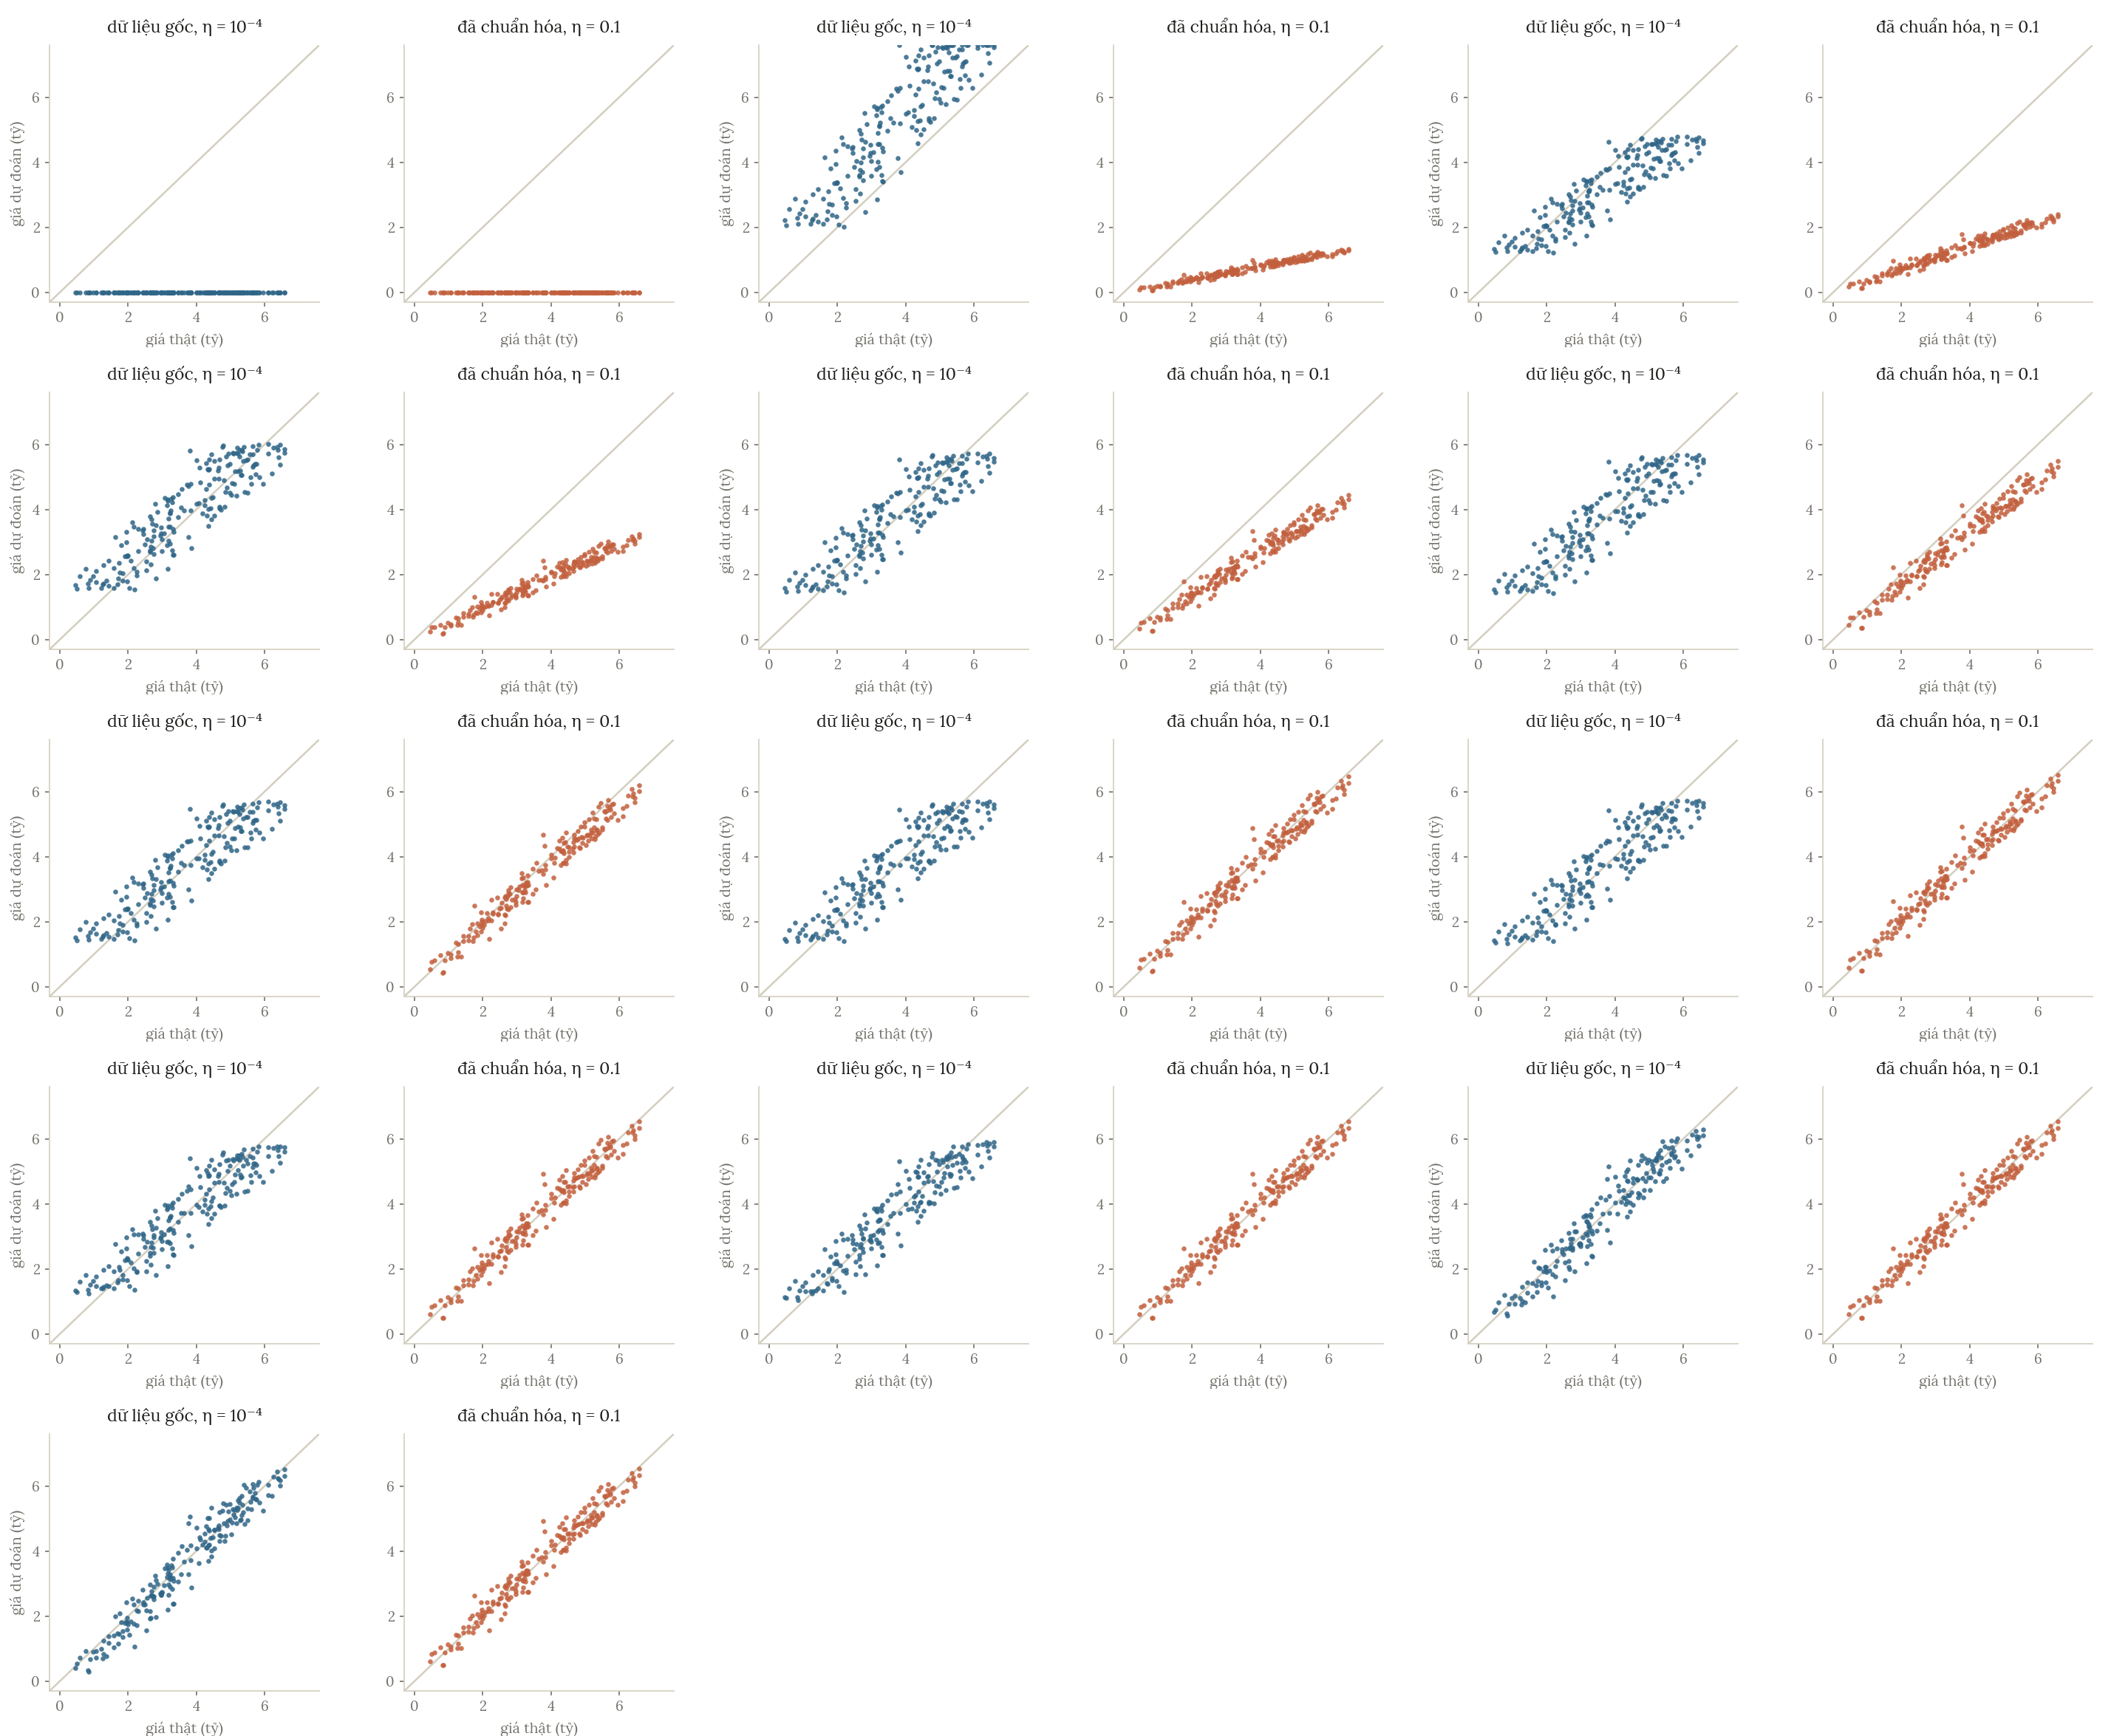
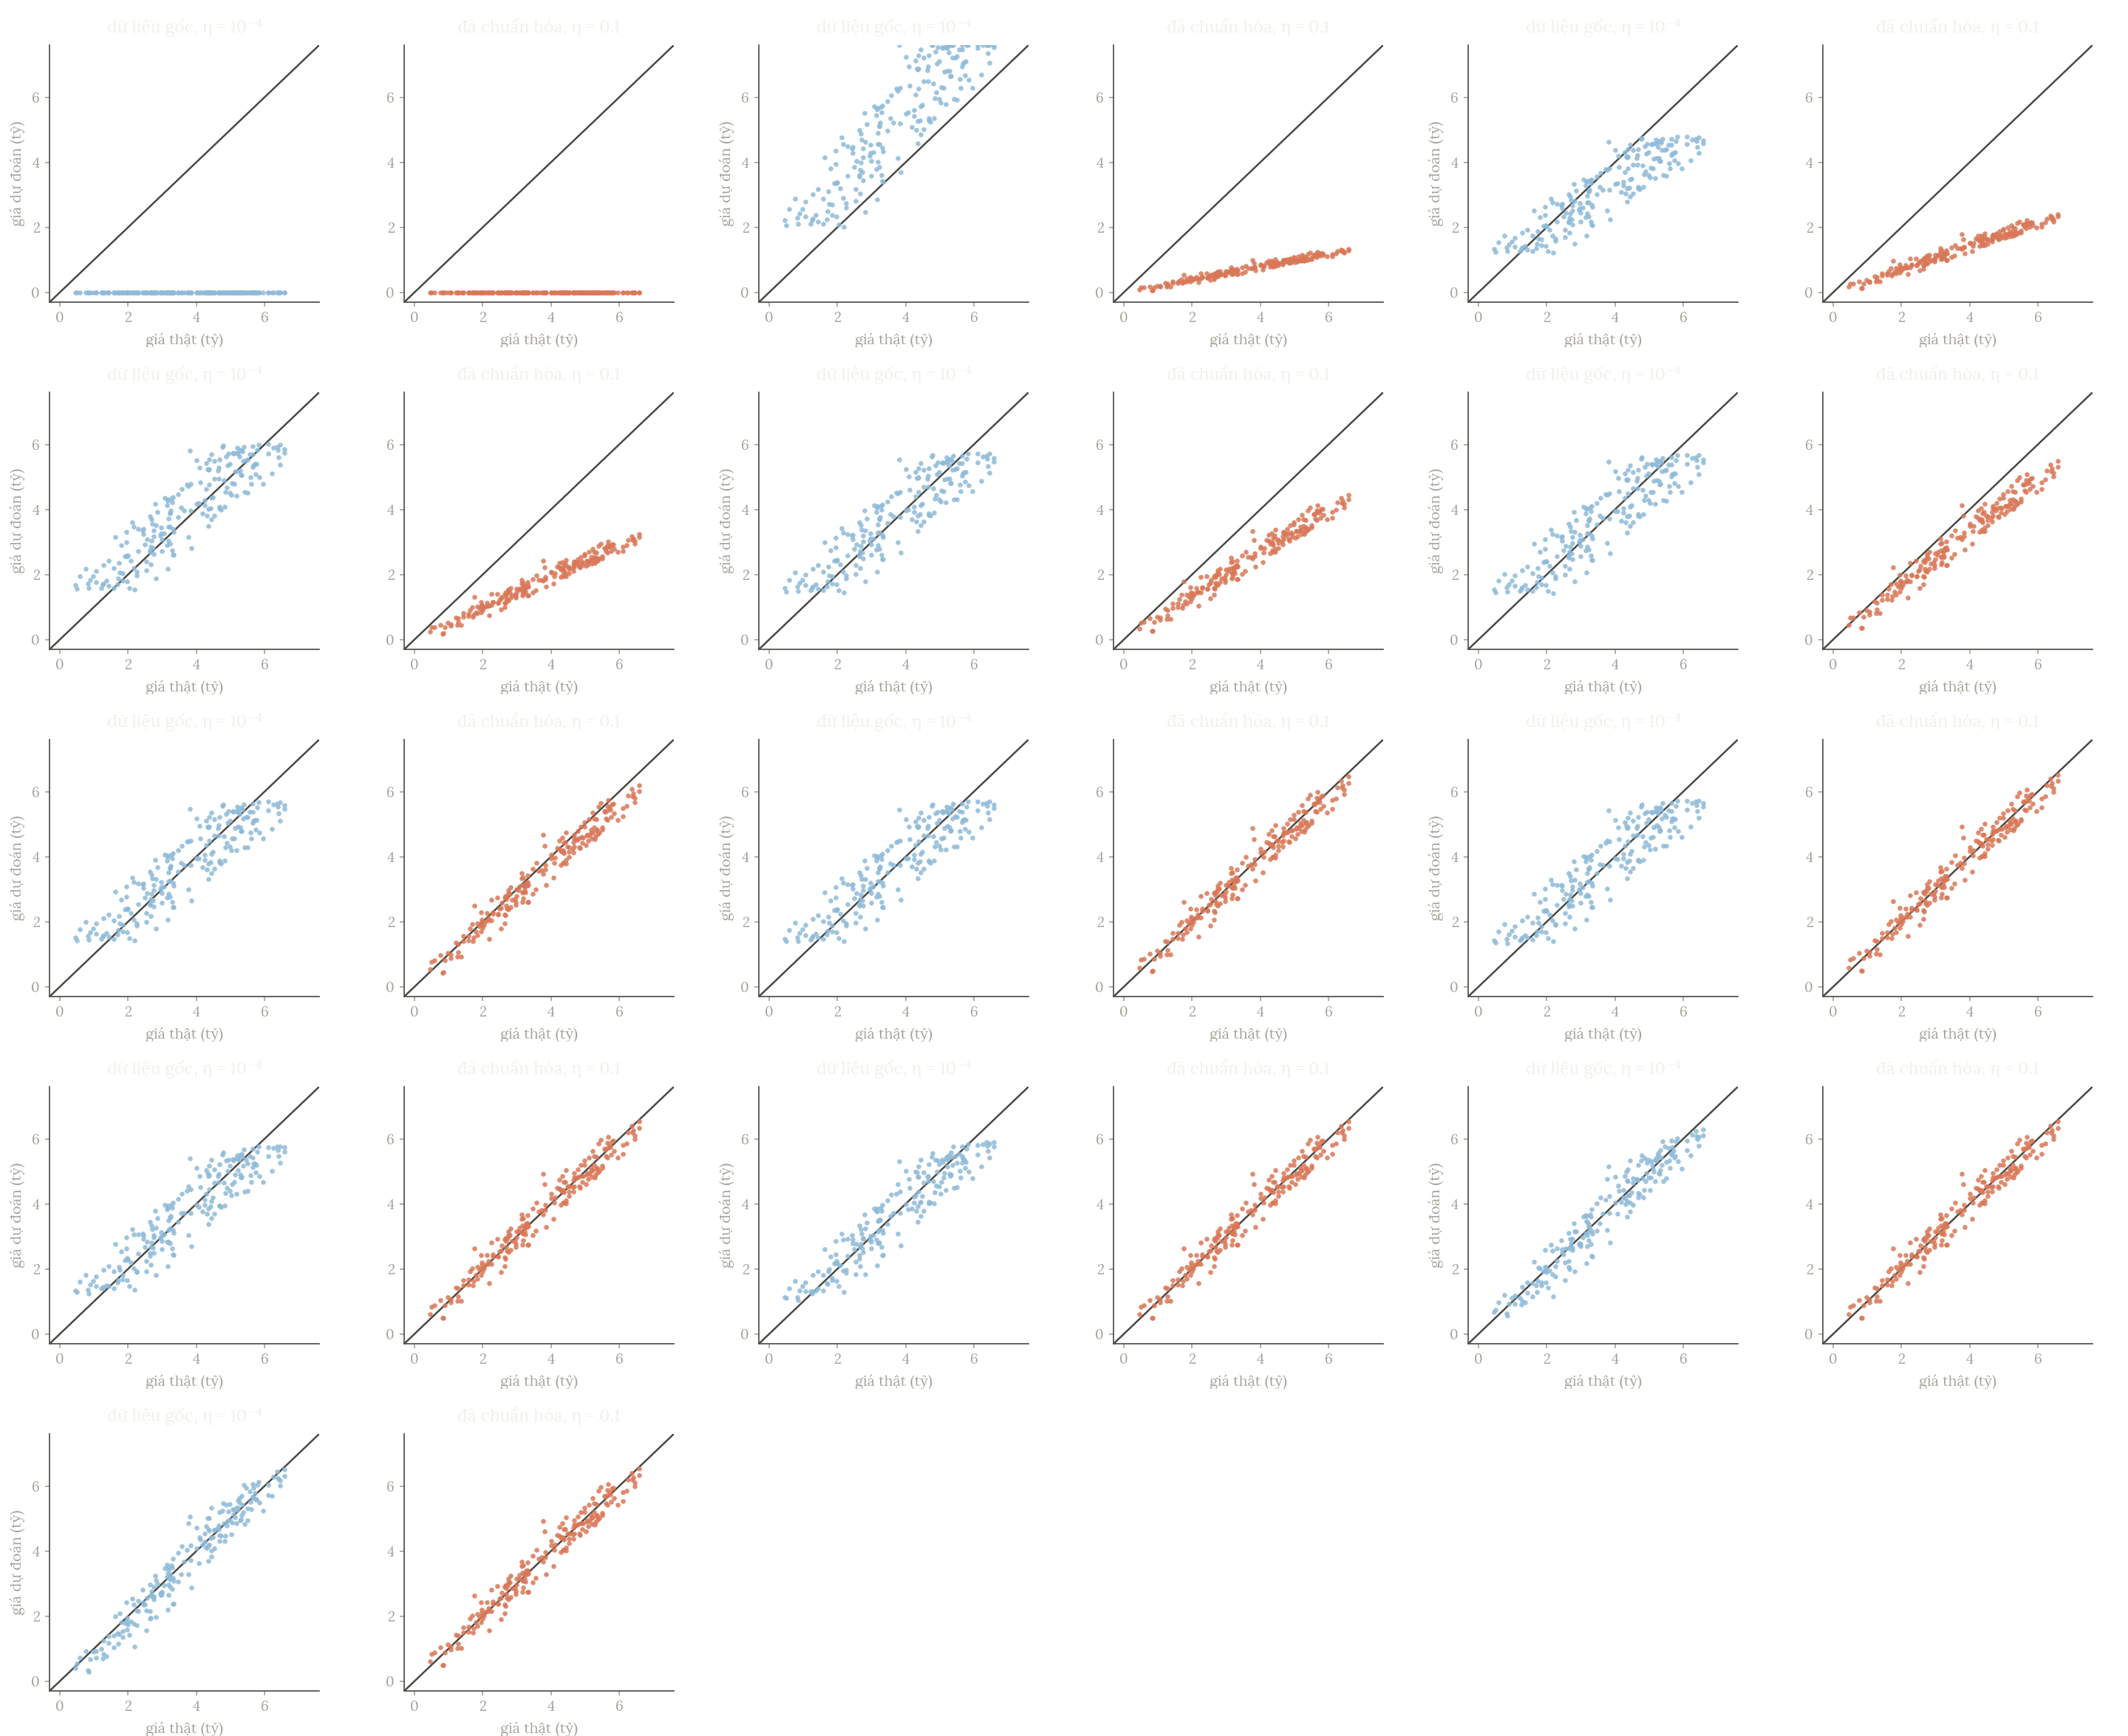
Dữ liệu đã bị biến đổi, vậy mô hình học được có còn là mô hình định giá nhà ban đầu không? Vẫn là nó, chỉ khác cách viết. Mô hình học trên nên trọng số cũng theo thang đo của . Muốn đọc lại bằng m² và km như ban đầu, ta thay vào:
nên trọng số và bias theo đơn vị gốc là
theta_s, _ = gd(Xs, y, 0.1, 200)
w_gd = theta_s[:2] / sigma
b_gd = theta_s[2] - np.sum(theta_s[:2] * mu / sigma)
print(w_gd.round(4), round(b_gd, 4))
[ 0.0499 -0.1453] 0.9809
Khớp với nghiệm đóng đến chữ số thứ tư.
Hỏi nhanh
Chuẩn hóa feature rồi học lại cho tới khi MSE chạm đáy. So với mô hình học trên dữ liệu gốc, cái gì thay đổi?
Chuẩn hóa là một phép đổi biến tuyến tính, nên tập các mô hình học được vẫn như cũ, và đáy của MSE vẫn cho cùng dự đoán. Công thức đổi ngược ở trên cho lại đúng trọng số gốc. Thứ thay đổi là hình dạng thung lũng, nên gradient descent tới đáy nhanh hơn hàng nghìn lần. LinearRegression giải trực tiếp, không lặp, nên chẳng có gì để “hội tụ nhanh hơn”.
Dùng scikit-learn
Trong thực tế, nhất là trong phòng thi, nên dùng thư viện cho nhanh và chắc. Quy trình chuẩn là chia dữ liệu, học trên tập train, chấm trên tập test:
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=0)
model = LinearRegression().fit(X_tr, y_tr)
print(model.coef_.round(4), round(model.intercept_, 4))
print(model.score(X_tr, y_tr), model.score(X_te, y_te))
[ 0.0496 -0.1437] 0.9966
0.9604123189943734 0.9689505848749018
model.score trả về , đúng đại lượng ta định nghĩa ở phần hàm mất mát. Điểm trên train () và trên test () sát nhau: không có dấu hiệu overfitting.
Điểm test cao hơn train một chút không có gì đặc biệt: tập test chỉ có 40 căn, nên chênh lệch cỡ này phụ thuộc cách chia, đổi random_state thì con số cũng đổi. Hệ số cũng hơi khác lúc nãy, vì lần này mô hình chỉ được học trên 160 căn.
LinearRegression giải least squares trực tiếp bằng phân tích ma trận, giống lstsq, chứ không dùng gradient descent, nên nó không cần chuẩn hóa mới hội tụ.
Còn code tự viết thì sao? Cho cả ba cách chạy trên cùng dữ liệu rồi so:
full = LinearRegression().fit(X, y)
print(np.allclose(full.coef_, w_cf), np.allclose(full.intercept_, b_cf))
print(np.allclose(w_gd, w_cf), np.allclose(b_gd, b_cf))
True True
True True
Cả bốn kết quả đều True. Lưu ý dùng np.allclose chứ không dùng ==: hai cách tính cùng đúng vẫn có thể lệch nhau ở chữ số thứ mười lăm. Tự cài lại rồi đối chiếu với thư viện giúp hiểu thư viện đang làm gì; khi cần kết quả thì dùng thư viện.
Sau khi huấn luyện, trọng số nằm ở model.coef_, bias ở model.intercept_: scikit-learn đặt mọi thứ học được vào thuộc tính có dấu gạch dưới ở cuối. Cần đọc chúng đúng cách. Có ba điểm cần nhớ.
Thứ nhất, hệ số phụ thuộc đơn vị. Hệ số của diện tích () nhỏ hơn hệ số của khoảng cách () về độ lớn, nhưng không có nghĩa là diện tích ít quan trọng hơn, vì một m² và một km không so sánh trực tiếp được. Muốn so thì so hệ số sau khi chuẩn hóa.
Thứ hai, hệ số đo mối liên hệ khi giữ các biến khác cố định, không phải quan hệ nhân quả. Doanh số kem và số vụ đuối nước cùng tăng vào mùa hè; mô hình sẽ cho hệ số dương, nhưng cấm bán kem không làm giảm số vụ đuối nước.
Thứ ba, luôn vẽ phần dư: trục ngang là dự đoán, trục dọc là phần dư. Mô hình ổn thì các điểm rải đều quanh đường 0, không theo hình thù gì. Phần dư uốn cong là mô hình đang thiếu đặc trưng phi tuyến; phần dư loe dần ra là nên biến đổi , chẳng hạn lấy log.
Hỏi nhanh
Linear regression cho hệ số dương giữa số kem bán ra và số vụ đuối nước mỗi tuần. Chỉ từ kết quả này, ta kết luận được gì?
Hệ số học từ dữ liệu quan sát chỉ cho biết hai đại lượng đi cùng nhau. Nó chưa nói được chuyện gì sẽ xảy ra nếu ta can thiệp vào việc bán kem. Nhiệt độ là nghi phạm hợp lý cho cả hai, nhưng cũng mới chỉ là giả thuyết.
Tuyến tính theo tham số
Quan hệ trong thực tế thường không thẳng: giá nhà không tăng đều theo diện tích mãi. Nhưng chữ “tuyến tính” trong tên model là tuyến tính theo , không phải theo . Ta được tự do biến đổi đặc trưng: thêm cột là polynomial regression (hồi quy đa thức); thêm , hay tích cũng được. Tất cả vẫn giải bằng đúng code của bài này. Ví dụ dữ liệu hình chữ U thì đường thẳng khớp kém, thêm cột là đủ.
Thêm đặc trưng không bao giờ làm lỗi train tăng, vì model luôn có thể đặt trọng số của cột mới bằng 0. Nhưng thêm quá nhiều thì model bắt đầu học thuộc nhiễu (overfitting, bài 1.2), và lỗi validation tăng.
Một ứng dụng cho lập trình thi đấu: đoán độ phức tạp của chương trình trước khi nộp. Nếu thời gian chạy thì lấy log hai vế:
Đó là một đường thẳng theo , và hệ số góc chính là số mũ . Đo thời gian chạy với vài giá trị , rồi hồi quy. np.polyfit(x, y, 1) chính là linear regression với một đặc trưng, trả về hệ số góc và hệ số tự do:
ns = np.array([1e3, 2e3, 5e3, 1e4, 2e4, 5e4])
t = np.array([0.0011, 0.0042, 0.026, 0.098, 0.41, 2.47])    # giây, đo trên máy nhà
k, c = np.polyfit(np.log(ns), np.log(t), 1)                  # least squares bậc 1
print(round(k, 2))
print(np.exp(c) * 2e5 ** k)                                  # dự đoán cho n = 2·10⁵
1.98
37.89981222044977
Hệ số góc xấp xỉ 2: thời gian tăng gần theo . Ngoại suy cho được khoảng 38 giây, quá xa giới hạn 1 giây, nên cần thuật toán tốt hơn trước khi nộp. (Vài phép đo không chứng minh được độ phức tạp, nhưng đủ để cảnh báo sớm.)
Hỏi nhanh
Sau khi tạo thêm feature, mô hình nào không giải được bằng code linear regression của bài này?
Ba mô hình đầu tuyến tính theo các tham số . Chỉ cần tạo thêm cột , hay là giải như thường. Ở mô hình cuối, nằm trong hàm mũ, nên mô hình không còn tuyến tính theo tham số.
Khi đi thi
- Gặp bài hồi quy, chạy
LinearRegressiontrước để có mốc so sánh. - Loss nổ thì chuẩn hóa đặc trưng trước, chỉnh learning rate sau.
- Tự viết gradient thì kiểm bằng sai phân trên dữ liệu nhỏ trước khi chạy thật.
Tóm tắt
- Linear regression dự đoán và học bằng cách cực tiểu MSE. Mô hình đoán trung bình có MSE bằng ; cho biết ta thắng mốc đó bao nhiêu.
- Nghiệm đóng: thêm cột 1 rồi giải hệ phương trình chuẩn bằng
solve. Về hình học, đó là phép chiếu vuông góc của . - Gradient descent đi từng bước ngược gradient và hội tụ khi . Số điều kiện quyết định nhanh hay chậm, và chuẩn hóa đặc trưng kéo nó về gần 1.
- Trong thực tế, dùng scikit-learn với train/test; đọc hệ số như mối liên hệ chứ không như nhân quả; giữ vector ở shape
(n,). - “Tuyến tính” là theo tham số, nên đặc trưng biến đổi tùy ý, kể cả để đoán độ phức tạp.
Kiểm tra cuối bài
Mười câu dưới đây bao quát cả bài. Làm hết rồi xem điểm; câu nào sai thì đọc lại mục tương ứng.
Câu 1
Hệ phương trình chuẩn của một bộ dữ liệu có số điều kiện cỡ . Vì sao điều này đáng lo khi giải bằng máy?
Số điều kiện cho biết sai lệch tương đối nhỏ ở đầu vào, kể cả sai số làm tròn, có thể bị phóng to tới cỡ lần ở nghiệm. Ma trận vẫn có thể khả nghịch, còn định thức hay số phần tử khác 0 là chuyện khác. Đây cũng là lý do gradient descent bò chậm khi trong bài, và chuẩn hóa chữa được cả hai.
Câu 2
Trên cùng một tập, MSE của mô hình bằng 1 và variance của bằng 4, cả hai đều chia cho số mẫu . không phải hằng số. bằng bao nhiêu?
. Công thức này chỉ đúng khi MSE và variance cùng chia cho . Ra 0.25 là quên lấy 1 trừ đi.
Câu 3
Với , gradient theo là gì?
Đạo hàm của bình phương phần dư cho hệ số 2, dấu theo hiệu dự đoán trừ target, và nhân với vector . Phương án thứ nhất quên nhân , phương án thứ ba sai dấu, phương án cuối thiếu hệ số 2.
Câu 4
Cho , xuất phát từ với . Sau một bước gradient descent, bằng bao nhiêu?
Tại , . Vậy .
Câu 5
Vẫn với . Learning rate nào làm gradient descent phân kỳ?
Đạo hàm bậc hai bằng 2, nên và cần . Với , mỗi bước sai số nhân với , vẫn co lại dù đổi dấu. Với thì nhân với , nên sai số lớn dần.
Câu 6
Công thức nghiệm dùng được khi nào?
Cần khả nghịch, tức là các cột của độc lập tuyến tính. Cột “diện tích theo dm²” ở trên phá đúng điều kiện này. Ma trận dữ liệu gần như không bao giờ vuông hay đối xứng, vì thường có nhiều mẫu hơn feature.
Câu 7
Một feature có độ lệch chuẩn . Học trên dữ liệu đã chuẩn hóa, nó nhận trọng số . Theo đơn vị gốc, trọng số của nó là bao nhiêu?
, vì tăng một đơn vị gốc thì chỉ tăng .
Câu 8
Ta đọc y = df[["price"]].to_numpy(), được shape (100, 1), còn y_hat có shape (100,). Dòng nào tính đúng MSE?
y.ravel() đưa y về (100,), để phần dư ghép đúng từng cặp mẫu. Trừ thẳng y hay y.T đều bị broadcasting thành ma trận 100 × 100. Phương án cuối là bình phương của trung bình phần dư, khác với trung bình của bình phương.
Câu 9
Gradient do hàm grad tự viết lệch tương đối so với gradient tính bằng sai phân. Ta nên làm gì?
Lỗi hay gặp nhất là sai dấu, thiếu hệ số, hoặc nhân ma trận sai thứ tự. Trong bài, bản đúng chỉ lệch cỡ . Lệch tới 0.5 thì gần như chắc chắn code sai. Giảm xuống không giúp gì, còn làm sai số làm tròn lớn thêm.
Câu 10
Mô hình định giá nhà có trọng số của diện tích là tỷ đồng mỗi m². Hai căn hộ giống nhau ở mọi feature khác, chỉ chênh nhau 10 m². Giá dự đoán chênh nhau bao nhiêu?
Khi các feature khác giữ nguyên, dự đoán chênh đúng tỷ. Hai căn có cùng khoảng cách, nên khoảng cách không ảnh hưởng tới phần chênh.
Đọc thêm
- James, Witten, Hastie, Tibshirani - An Introduction to Statistical Learning, chương 3. Linear regression từ góc nhìn thống kê: độ tin cậy của hệ số, tương tác giữa các đặc trưng, các vấn đề thường gặp. Sách miễn phí, có bản dùng Python.
- Géron - Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow, chương 4 “Training Models”. Nghiệm đóng, các biến thể của gradient descent, polynomial regression và learning curve, viết rất thực hành.
- Zhang và cộng sự - Dive into Deep Learning, chương 3. Linear regression được trình bày như một mạng neural một lớp, cài từ đầu rồi bằng PyTorch; cầu nối sang Chương 3.
- Andrew Ng - CS229 Lecture Notes, chương 1. Least squares, phương trình chuẩn, và lý do xác suất đứng sau việc dùng MSE.
- Boyd, Vandenberghe - Introduction to Applied Linear Algebra, chương 12-13. Least squares bằng đại số tuyến tính với nhiều ví dụ ứng dụng; dành cho ai muốn hiểu sâu phần nghiệm đóng. Sách miễn phí.
- 3Blue1Brown - Essence of Linear Algebra. Loạt video trực quan về vector, ma trận, phép chiếu và trị riêng.
- Gabriel Goh - Why Momentum Really Works, Distill (2017). Phân tích gradient descent trên hàm bậc hai qua trị riêng và số điều kiện, có hình tương tác; đọc sau mục chọn learning rate.
- Stanford CS231n - Gradient checks. Các lưu ý khi kiểm gradient bằng sai phân trong thực tế.
- Tài liệu chính thức: NumPy - Broadcasting, scikit-learn - Linear Models.