Robot học chính sách từ phần thưởng
Chương 9 · Bài 9.1
Robot tới bàn trả sách qua một lưới có ô chắn.
Mỗi lần thử một hành động, rồi thấy vị trí mới và phần thưởng.
Thưởng chỉ có ở đích: một bước còn xa đích có ích không?
Biết bản đồ: BFS là đủ.
Chưa biết kết quả hành động: học từ trải nghiệm.
St: trạng thái trước hành động.
At: hành động.
Rt+1, St+1: kết quả sau hành động.
Tính Markov: biết St,At là đủ để dự đoán bước kế, không cần lịch sử.
Pin ảnh hưởng di chuyển: thêm mức pin vào trạng thái.
Hỏi nhanh
Robot chỉ ghi lại vị trí ô. Khi pin yếu, lệnh “tiến” có lúc không làm robot di chuyển. Nên sửa mô tả trạng thái thế nào?
Cùng ô mà khác pin thì cùng một hành động cho kết quả khác nhau, nên vị trí chưa đủ để có tính Markov. Thêm mức pin là sửa đúng chỗ thiếu.
Hỏi nhanh
Đổi luật chơi: robot có hướng nhìn là N, E, S hoặc W, và chỉ còn ba hành động là quay trái, quay phải, và tiến một ô theo hướng đang nhìn. Trên lưới của bài, MDP mới có bao nhiêu trạng thái và bao nhiêu hành động?
Lệnh tiến phụ thuộc hướng nhìn, nên hướng nằm trong trạng thái: 11×4=44 trạng thái, còn hành động chỉ có 3.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.1
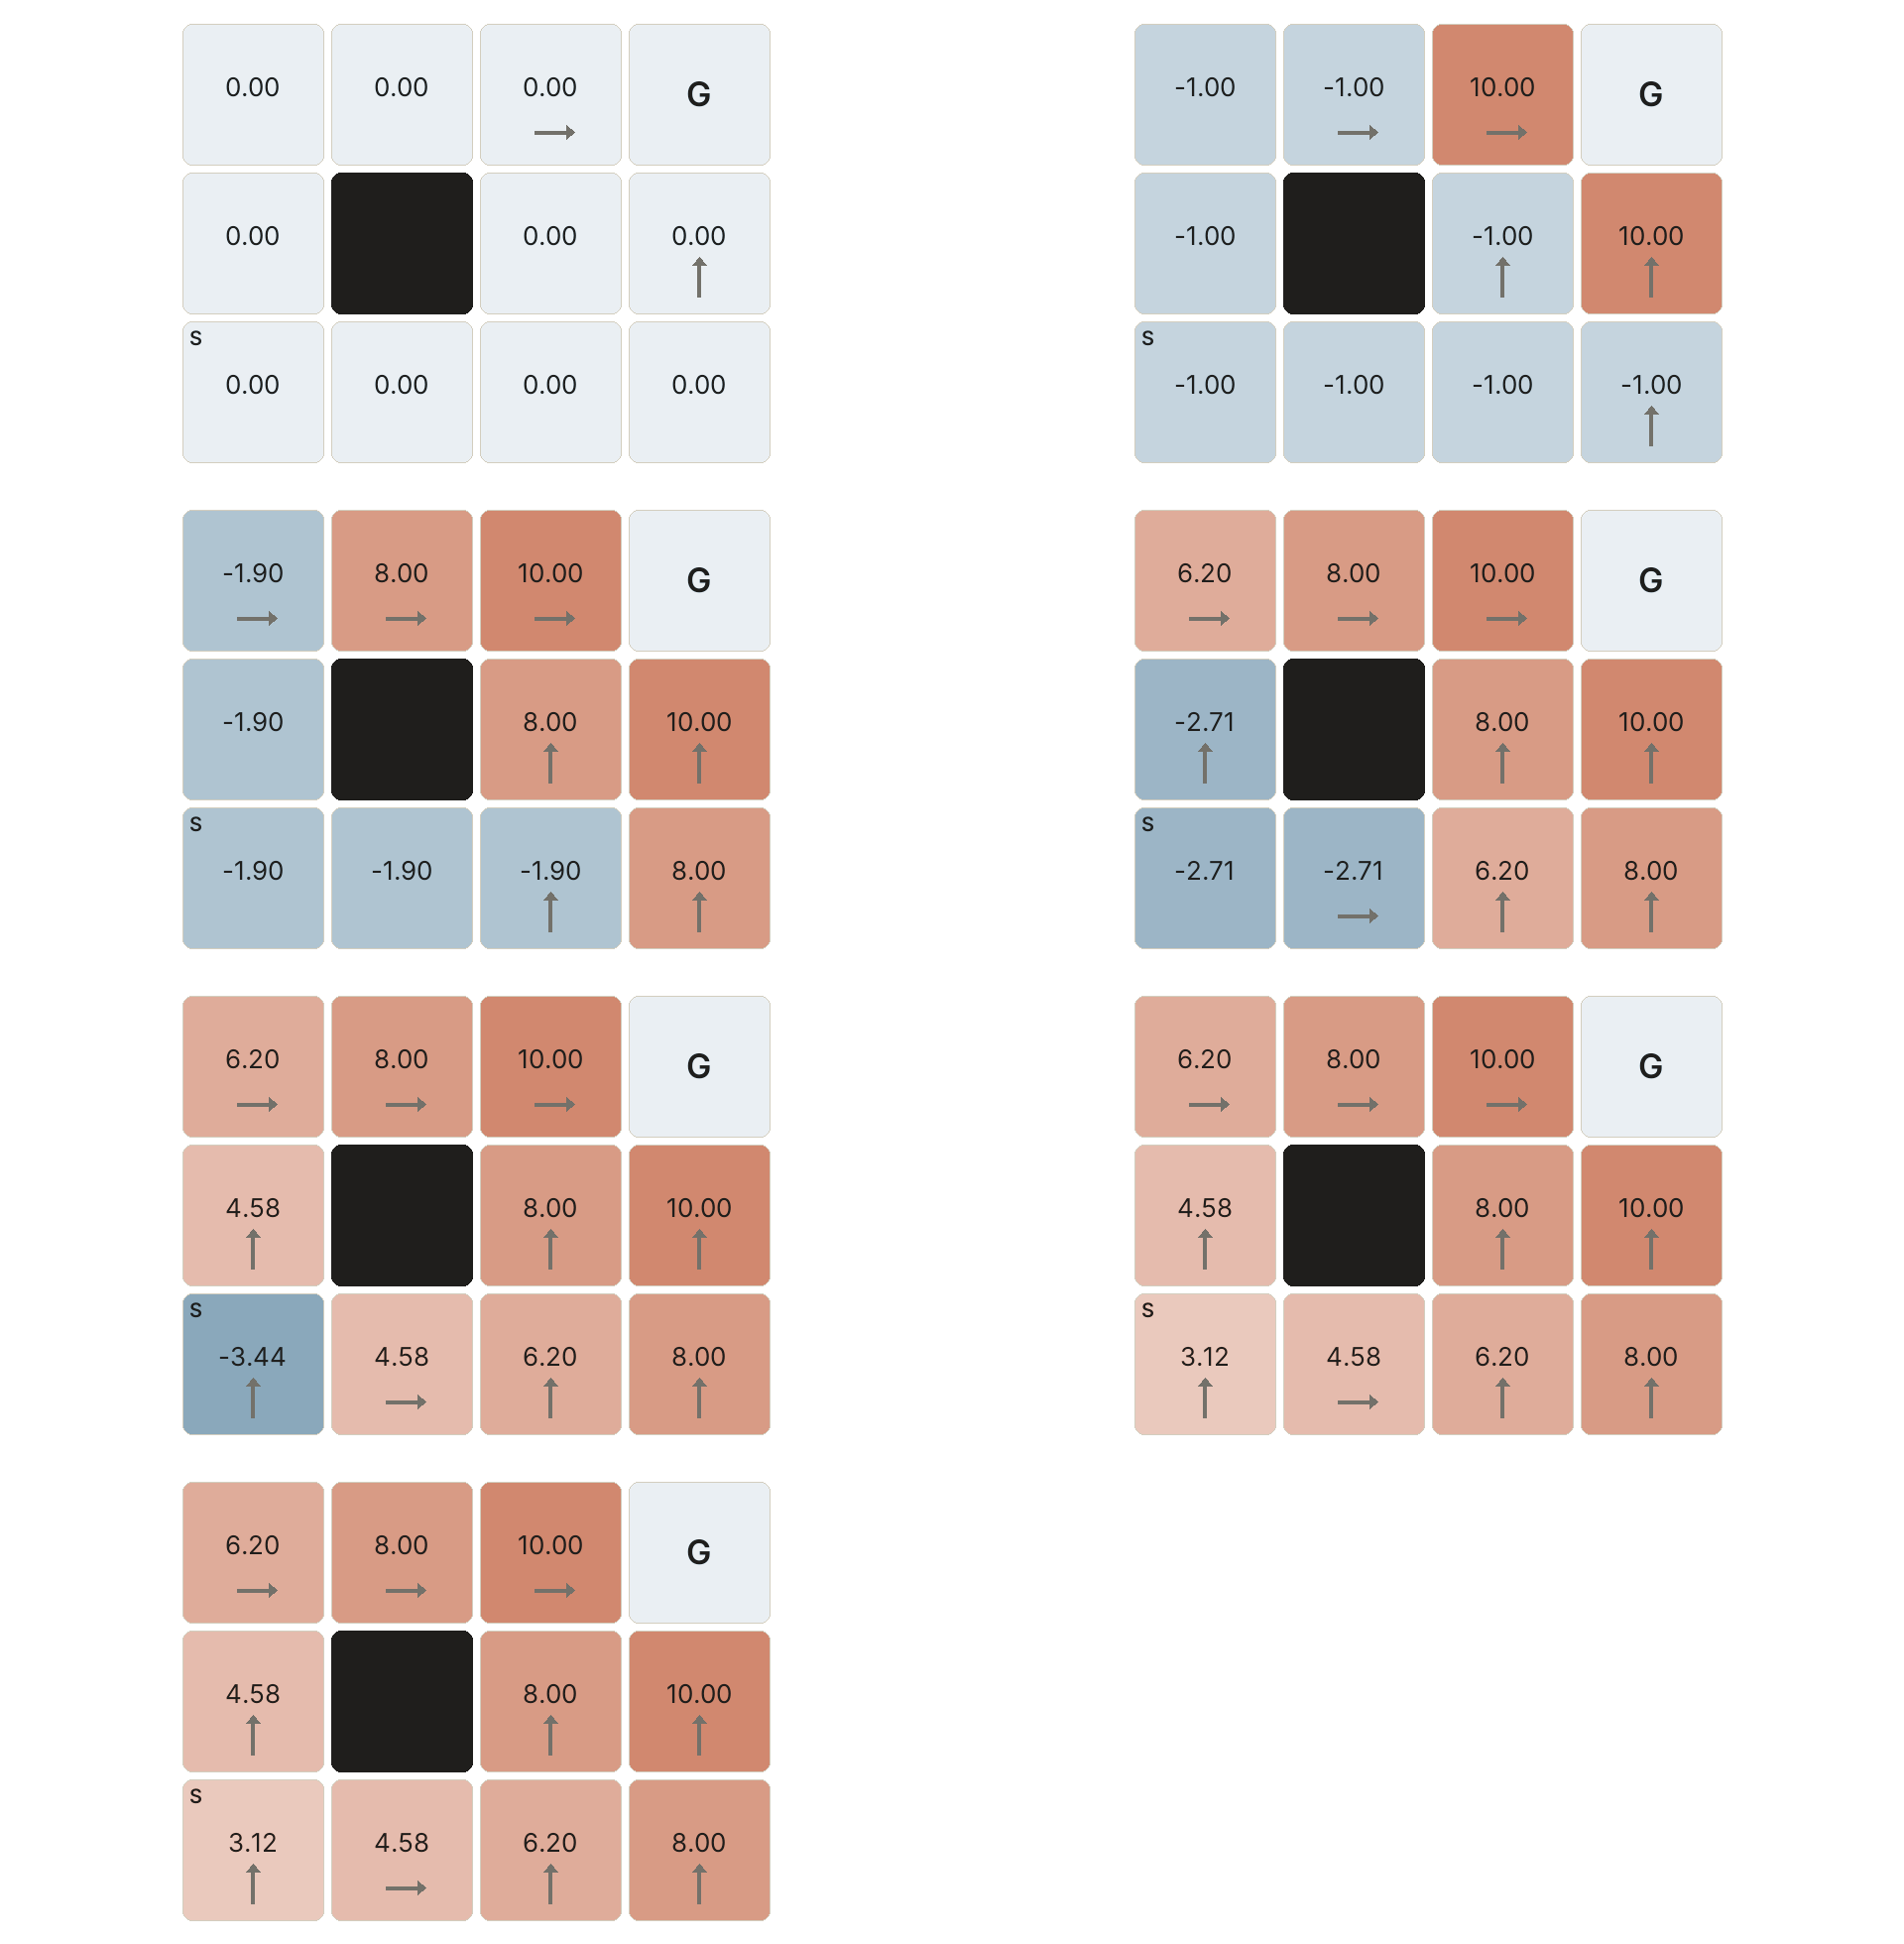
Đường 5 bước: (−1,−1,−1,−1,10).
G0=−1−0.9−0.92−0.93+10⋅0.94=3.122.Tổng không chiết khấu là 6 điểm. γ không phải learning rate.
Hỏi nhanh
Một bước đi vào terminal nhận thưởng 10. Return tính từ ngay trước bước đó bằng bao nhiêu?
Thưởng của chính bước kết thúc có hệ số 1, vì nó là Rt+1. Sau terminal không còn gì để cộng thêm.
Mỗi bước −1: đường dài mất thêm điểm.
γ<1: thưởng 10 đến muộn có giá trị nhỏ hơn.
Cả hai đẩy robot đi đường ngắn. Thưởng dương cho mỗi bước có thể khiến robot muốn kéo dài episode.
Hỏi nhanh
Đổi thiết kế: vào đích nhận 10, mọi bước khác nhận 0, và γ=1. Policy nào là tối ưu?
Không phạt mỗi bước và không chiết khấu thì mọi đường tới đích đều có return 10. Đứng yên mãi chỉ được 0.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.8
V∗(terminal)=0 vì sau terminal không còn phần thưởng tương lai.
Ở môi trường ngẫu nhiên, lấy kỳ vọng kết quả của từng hành động, rồi chọn max.
| Khoảng cách tới G | Giá trị tối ưu |
|---|---|
| 1 bước | 10 |
| 2 bước | 8 |
| 3 bước | 6.2 |
| 4 bước | 4.58 |
| 5 bước | 3.122 |
Mỗi bước lùi thêm: Vd=−1+0.9Vd−1, với V1=10.
print(f"Value iteration tại S: {V[start]:.3f}")
print(f"Giá trị terminal: {V[goal]:.3f}")
Kết quảValue iteration tại S: 3.122
Giá trị terminal: 0.000
Dùng mô hình đã biết: planning, chưa phải học.
Một vòng xét mọi s, mọi a, mọi s′:
Đồ thị có vòng nên không có thứ tự tính một lần là xong.
Bắt đầu từ V=0, mỗi vòng đưa thông tin từ đích lùi thêm một bước.
Hỏi nhanh
Chạy value iteration đồng bộ trên lưới của bài, bắt đầu từ V=0. Sau đúng 2 vòng, giá trị tại S bằng bao nhiêu?
Vòng 1 cho các ô cạnh S giá trị −1. Vòng 2 cho S giá trị −1+0.9⋅(−1)=−1.9.
Bảng (11, 4) lưu giá trị mỗi cặp (s,a).
Target chưa terminal:
r+γa′maxQ(s′,a′).Q=2, r=−1, maxQ(s′,⋅)=5.
γ=0.9, α=0.2:
Hỏi nhanh
Đề chỉ cấp env.reset() và env.step(a), trả về trạng thái mới, phần thưởng và cờ kết thúc. Không có bảng chuyển, cũng không có bản đồ. Cách nào chạy được ngay?
Q-learning chỉ cần các bộ (s,a,r,s′) thu được khi gọi step. Value iteration cần biết p(s′,r∣s,a) cho mọi cặp.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q5.1(iv)
def td_target(reward, next_values, terminated):
    if terminated:
        return reward
    return reward + gamma * np.max(next_values)
Thưởng terminal 10, target bằng 10.
Giới hạn thu mẫu bên ngoài MDP vẫn cho phép bootstrap.
Trong Gymnasium: đọc riêng terminated và truncated.
if rng.random() < epsilon:
    action = int(rng.integers(4))
else:
    best = np.flatnonzero(
        Q[state] == Q[state].max())
    action = int(rng.choice(best))
Exploration thử hành động để biết thêm về environment.
Search mở rộng trạng thái bằng quy tắc đã biết.
Chọn ngẫu nhiên mà không cập nhật Q hoặc policy chưa tạo ra phần học.
Hỏi nhanh
Epsilon-greedy có 4 hành động, đúng một hành động tốt nhất, ϵ=0.2, và nhánh explore chọn đều cả 4 hành động. Xác suất chọn hành động tốt nhất là bao nhiêu?
Nhánh khai thác góp 0.8, nhánh explore góp thêm 0.2/4=0.05.
Episode đầu, α=1, Q=0: chỉ cặp cuối nhận target có thưởng 10.
Các cặp trước đã cập nhật khi phía sau còn bằng 0.
Mỗi lần đi lại cùng đường, thông tin lùi thêm một bước.
Experience replay: lưu transition, cập nhật lại nhiều lần.
Hỏi nhanh
Episode đầu tiên đi 5 transition từ S tới đích, và tất cả đều được lưu lại. Q-learning với α=1, Q khởi tạo bằng 0. Phát lại 5 transition này theo thứ tự nào để Q tại S đạt 3.122 chỉ sau một lượt quét?
Cập nhật ngược thì mỗi cặp dùng giá trị phía sau vừa tính: 10, 8, 6.2, 4.58, rồi 3.122.
print("Hành động:", " ".join(actions_taken))
print(
    f"Số bước: {len(actions_taken)}, "
    f"return: {discounted:.3f}"
)
Kết quảHành động: R R U U R
Số bước: 5, return: 3.122
Evaluation tắt exploration và không cập nhật Q.
Đường ngắn nhất dài 5 bước: tối ưu từ S.
Kiểm cả policy: chạy từ mọi ô, so với V∗.
Hỏi nhanh
Một bảng Q mới học 20 episode. Đánh giá greedy từ S cho đường (2,0)→(2,1)→(2,0)→(2,1)→⋯ cho đến hết 30 lượt mà không tới đích. Ta kết luận gì, và nên làm gì?
Policy greedy theo một bảng Q chưa hội tụ có thể đi vòng. Bật ϵ khi đánh giá là đo một policy khác với policy sẽ nộp.
Trái nhận 1 điểm, phải nhận 3 điểm, rồi episode kết thúc.
p=π(phải)=σ(θ). J(θ)=1+2p,J′(θ)=2p(1−p).Bandit này giúp thấy đạo hàm. Nó chưa có vấn đề gán công lao qua nhiều bước.
θ=0 cho p=0.5 và J′=0.5.
Gradient ascent với η=0.1:
θ′=0+0.1⋅0.5=0.05.Kết quảMột bước exact gradient: theta=0.0500, p=0.5125
Tăng thưởng: dấu cộng. Giảm loss: dấu trừ.
Hỏi nhanh
Ta muốn cực đại hóa kỳ vọng thưởng J(θ), và đã có gradient bằng J′(θ). Dòng cập nhật nào đúng?
Cực đại hóa J thì đi theo gradient, tức gradient ascent.
Mẫu gradient:
g=(R−b)∇θlogπθ(A).Với Bernoulli, ∇θlogπ(A)=A−p.
reward = 3.0 if action else 1.0
sample_gradient = (
    (reward - 2.0) * (action - probability)
)
theta_policy += 0.05 * sample_gradient
Baseline b=2 không phụ thuộc vào hành động được chọn.
Hỏi nhanh
Bandit của bài, với θ=0 nên p=0.5, và baseline b=2. Mẫu vừa rút chọn trái và nhận 1 điểm. Sau một cập nhật REINFORCE như trong code, xác suất chọn phải thay đổi thế nào?
(R−b)(A−p)=(1−2)(0−0.5)=+0.5, nên θ tăng và xác suất chọn phải tăng.
Kết quảPolicy sau 400 mẫu: p(phải)=0.9641, E[R]=2.9282
Kỳ vọng tính bằng công thức 1+2p của bandit.
Kỳ vọng 2.9282 chưa bằng mức tối đa 3 vì policy vẫn còn ngẫu nhiên.
Gradient 2p(1−p) nhỏ dần khi p gần 1: càng chắc chắn càng học chậm.
Hành động ở bước t chỉ ảnh hưởng thưởng về sau, nên dùng Gt.
Baseline không đổi kỳ vọng, chỉ bớt dao động; thường là ước lượng V(St).
Actor-critic: thay Gt bằng Rt+1+γVϕ(St+1).
truncated (dừng thu mẫu) khác terminated (kết thúc thật).step bằng tay trước khi train.Luyện đề 1
Sàn trơn. Từ X, lệnh “tiến” đi một ô tới Y với xác suất 0.8, trượt thẳng vào đích với xác suất 0.2. Từ Y thì luôn vào đích. Vào đích nhận 10, bước khác nhận 0, γ=0.9. V∗(X) bằng bao nhiêu?
V∗(Y)=10. Tại X, lấy kỳ vọng theo các kết quả của một hành động: 0.2⋅10+0.8⋅0.9⋅10=2+7.2=9.2. 9.0 là bỏ qua khả năng trượt.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q3.9
Luyện đề 2
Q khởi tạo 0, α=1, γ=0.9. Nhận lần lượt (A, M, 0, B), (B, M, 0, C), (C, M, 1, A), (A, M, 0, B), (B, M, 0, C). Những ô nào của Q khác 0?
Với α=1, mỗi lần cập nhật ghi đè Q(s,a)=r+0.9maxQ(s′,⋅). Lần thứ hai qua A, B chưa có tin tốt nên Q(A,M) vẫn là 0. Lần thứ hai qua B cho 0.9. Thưởng lan ngược mỗi lượt một bước.
Phỏng theoMIT 6.036 · Final, Spring 2022 · Q7(a)
Luyện đề 3
Bandit của bài, p=0.5, mẫu REINFORCE là (R−b)(A−p). So sánh b=0 với b=2.
Với b=0, mẫu là 1.5 hoặc −0.5, trung bình 0.5, phương sai 1. Với b=2, cả hai trường hợp đều bằng 0.5, phương sai 0. Kỳ vọng không đổi vì E[A−p]=0, nên baseline chỉ bớt dao động.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q5.3(a)
Thưởng, γ và terminal định nghĩa bài toán; Bellman nối hiện tại với tương lai.
Value iteration dùng mô hình, Q-learning dùng transition, policy gradient chỉnh trực tiếp xác suất hành động.
Làm 10 câu kiểm tra cuối bài trên trang bài học.
Chạy notebook; thêm xác suất trượt vào step, đoán trước V∗(S) giảm ra sao rồi kiểm bằng value iteration.