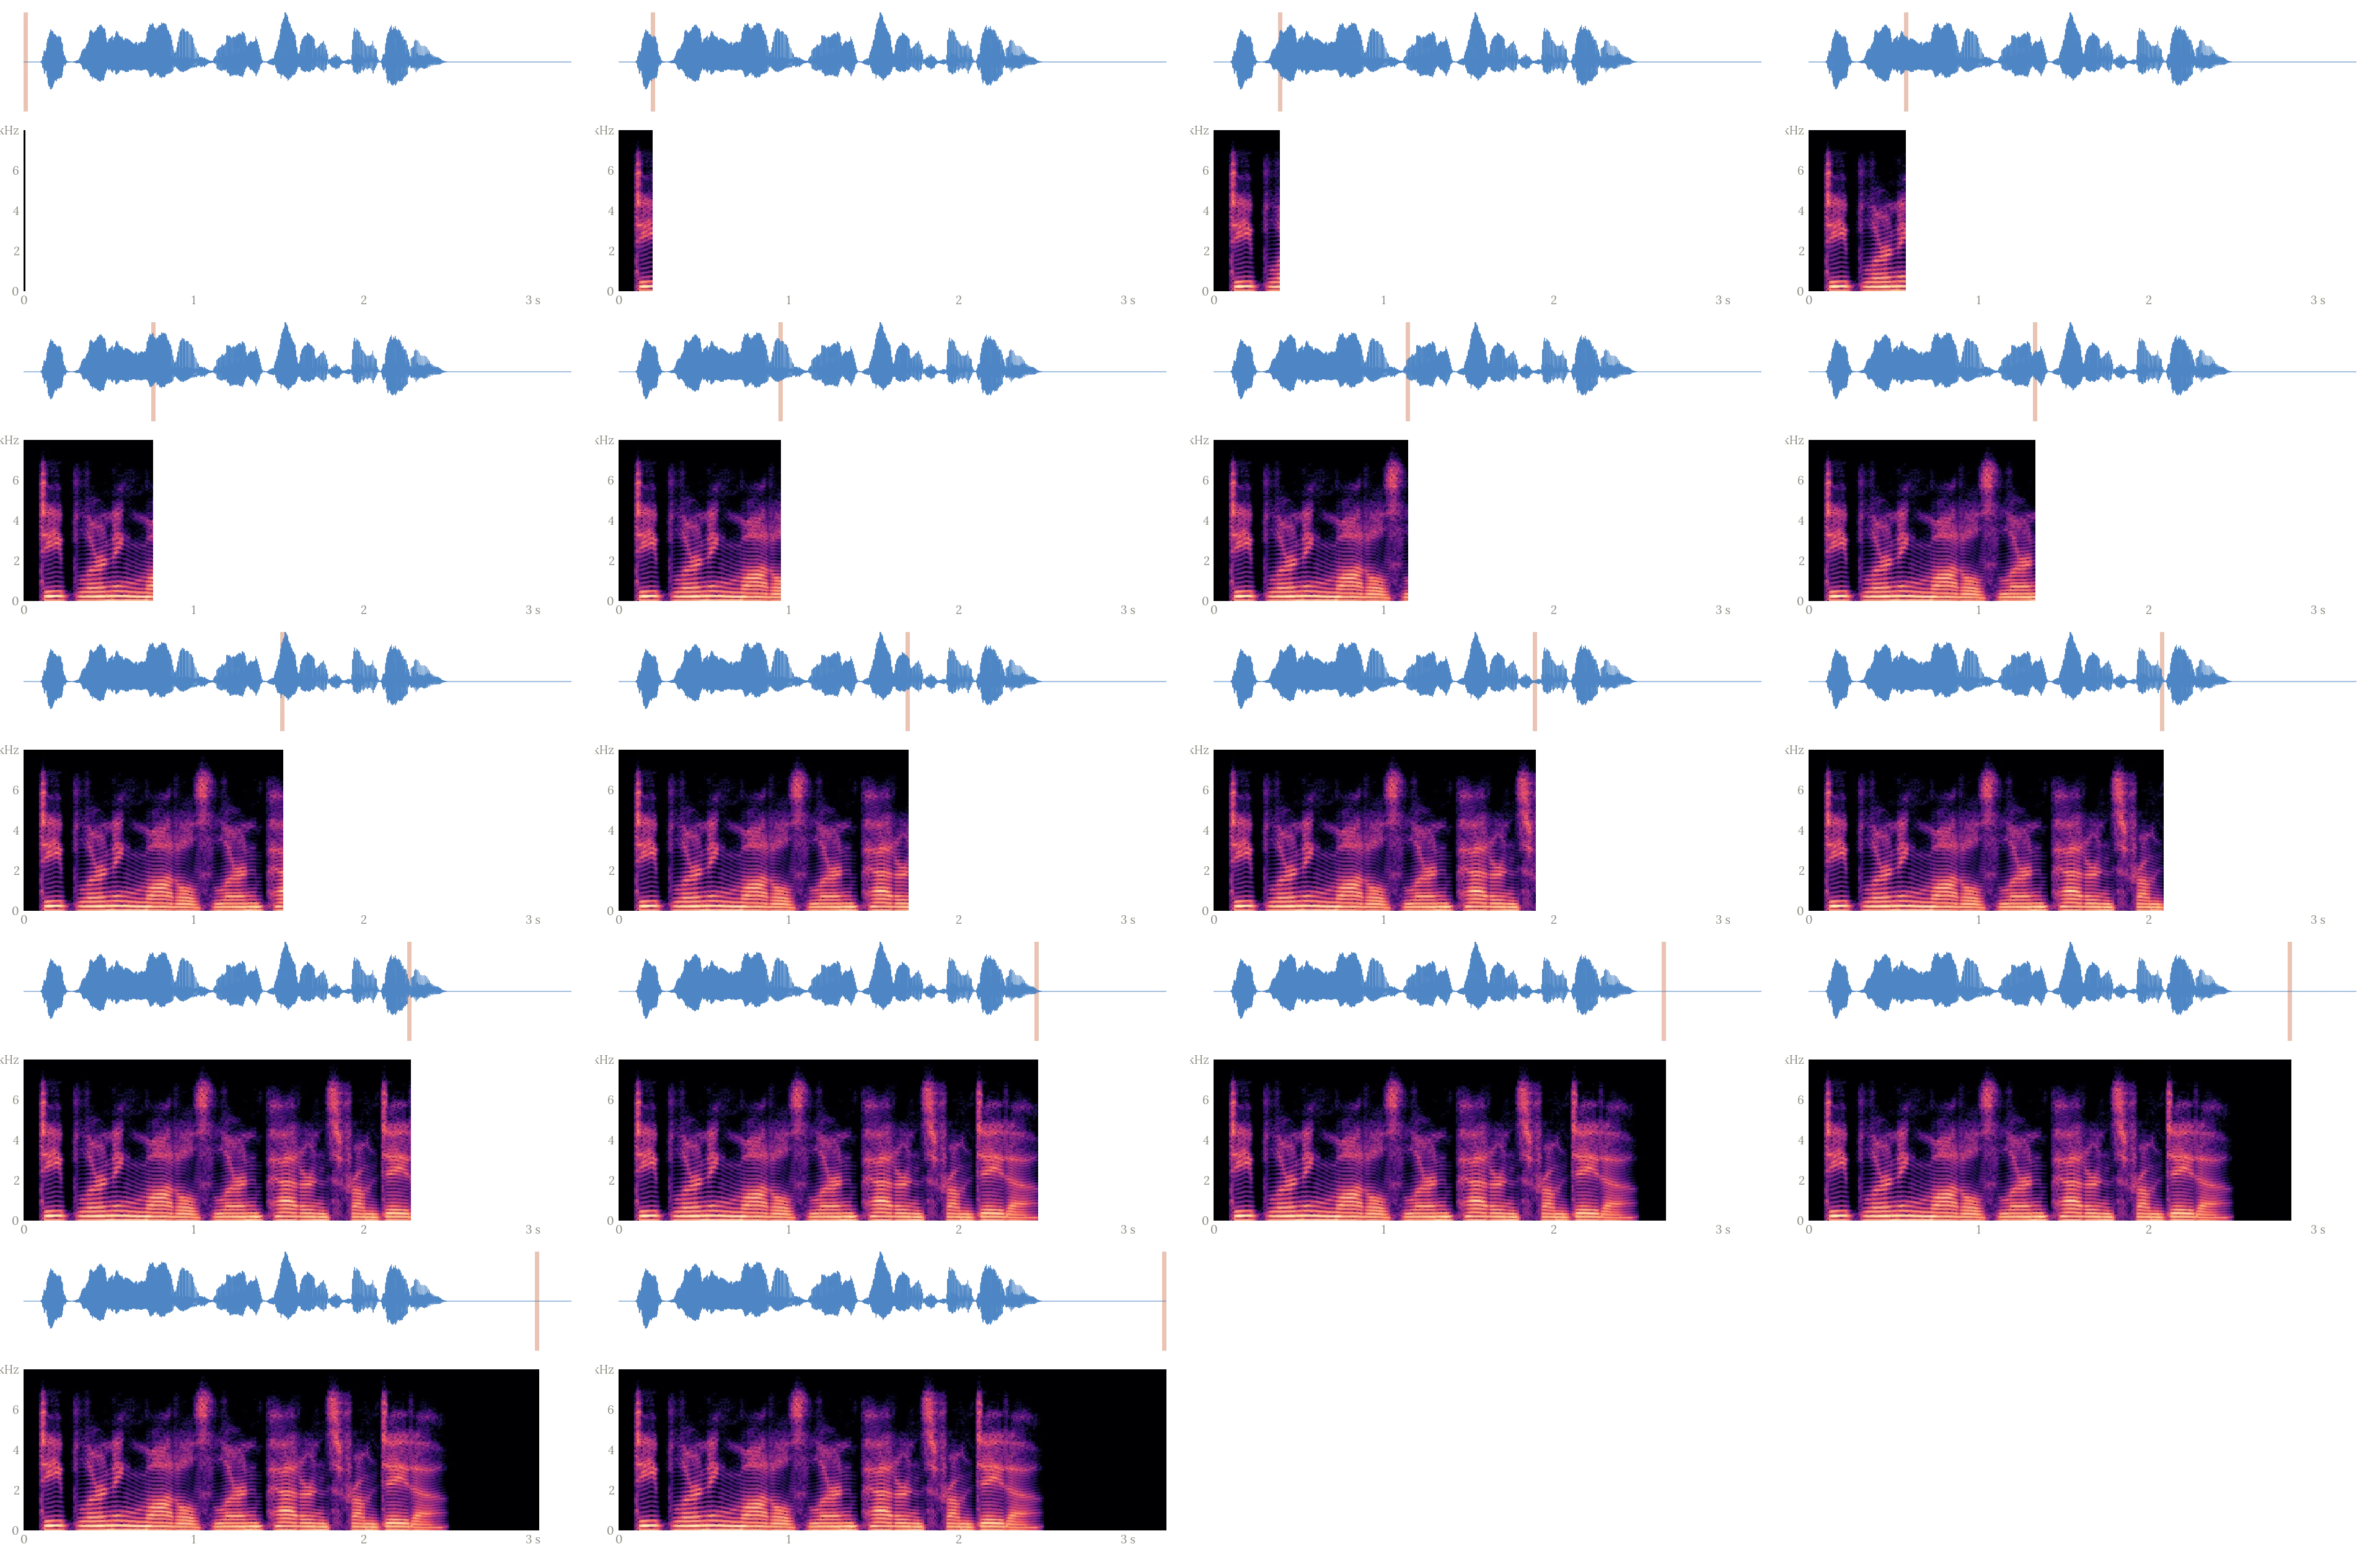
Từ một dãy số đến ảnh phổ có trục đúng
Chương 7 · Bài 7.1
Điện thoại trả hàng nghìn số.
Waveform dày đặc chưa cho biết âm nào xuất hiện trước, âm nào xuất hiện sau.
Cần một biểu diễn cho thấy tần số nào xuất hiện ở lúc nào: spectrogram.
fs là số mẫu mỗi giây; N là tổng số mẫu. n là chỉ số mẫu tính từ 0.
2000 mẫu ở 2000 Hz dài 1 giây.
WAV 16-bit: chia cho 32 768 để về [−1,1). Stereo: tính theo trục mẫu.
Nửa đầu: sine 200 Hz.
Nửa sau: sine 600 Hz.
Spectrogram đúng phải cho thấy 200 Hz rồi 600 Hz.
print(waveform.shape)
print(f"thời lượng = {duration:.3f} s")
print(f"khoảng mẫu = {interval_ms:.3f} ms")
Kết quả(2000,)
thời lượng = 1.000 s
khoảng mẫu = 0.500 ms
Hỏi nhanh
File WAV stereo 16 kHz được đọc thành mảng shape (48000, 2), tức 48 000 mẫu cho mỗi kênh. File dài bao nhiêu giây?
T=N/fs=48000/16000=3 giây. Thời lượng tính theo trục mẫu, không theo tổng số phần tử.
Hỏi nhanh
Microphone phải của một bản ghi stereo bị đấu ngược cực, nên kênh phải đúng bằng kênh trái đổi dấu. Downmix bằng cách lấy trung bình hai kênh thì được gì?
Tại mọi mẫu, (x+(−x))/2=0, nên bản mono thành im lặng dù từng kênh vẫn có âm.
Cosine 350 Hz và 650 Hz có cùng mẫu khi fs=1000 Hz.
Nyquist frequency: fs/2. Thành phần f∈(fs/2,fs) hiện ra ở fs−f.
print(np.allclose(low_tone, high_tone))
Kết quảTrue
Thông tin không còn phân biệt được trong input.
waveform[::2]: còn 1000 Hz, Nyquist 500 Hz.
Đoạn 600 Hz gập về 400 Hz, vì 1000−600=400.
Kết quảbỏ mẫu: 1000 mẫu, biên độ ở 400 Hz = 0.400
có lọc: 1000 mẫu, biên độ ở 400 Hz = 0.000
resample_poly lọc thông thấp trước: mất 600 Hz nhưng không bịa âm mới.
Giữ 2000 mẫu nhưng gắn 4000 Hz: phát trong 0.5 giây.
Resample lên 4000 mẫu ở 4000 Hz: vẫn 1 giây.
Kết quảđổi metadata: 0.500 s
resample: 1.000 s
Upsample không thêm âm cao mà bản ghi chưa từng có.
Hỏi nhanh
Thu âm ở 8000 Hz mà không có bộ lọc chống aliasing, trong khi trong phòng có tiếng rít 5000 Hz. Trên spectrogram của bản ghi, tiếng rít hiện ra ở đâu?
5000 Hz nằm giữa Nyquist 4000 Hz và 8000 Hz, nên bị gập về 8000−5000=3000 Hz, và trộn với âm thật ở đó.
Hỏi nhanh
Clip 16 kHz dài 2 giây chứa tiếng còi 1000 Hz. Một bước tiền xử lý chỉ sửa header thành 24 kHz, giữ nguyên mảng. Phát lại, hoặc đưa vào model 24 kHz, thì clip ra sao?
Đọc 32 000 mẫu ở 24 kHz thì dài 1.33 giây. Mỗi chu kỳ còi vẫn chiếm 16 mẫu, nên tần số thành 1500 Hz.
Window L=200 mẫu, tức 100 ms.
Hop H=100 mẫu, tức 50 ms.
Hann window làm hai đầu frame nhỏ dần.
Không padding:
F=1+⌊HN−L⌋=19.Hop quyết định bước trượt; window quyết định đoạn được quan sát.
center=True đệm L/2 mỗi đầu:
print(power.shape)
peaks = np.argmax(power[:, [0, -1]], axis=0)
print(frequencies[peaks])
print(centers[[0, -1]].round(2))
Kết quả(101, 19)
[200. 600.]
[0.05 0.95]
101 hàng: bin tần số.
19 cột: frame.
Power trong bài là bình phương biên độ tương đối, không phải watt/Hz.
Hỏi nhanh
Tiếng nói 16 kHz, window 400 mẫu tức 25 ms, không zero-padding. rfft của một frame cho bao nhiêu bin, và các bin cách nhau bao nhiêu Hz?
rfft cho L/2+1=201 bin, cách nhau fs/L=40 Hz.
Hỏi nhanh
Giữ window length 200 mẫu, giảm hop từ 100 xuống 50 mẫu trên waveform của bài. Điều gì thay đổi trực tiếp?
Hop là bước trượt giữa hai frame, nên số frame từ 19 thành 37. Window, Nyquist và khoảng cách bin đều không đổi.
Window dài: tách tần số gần nhau tốt hơn, nhưng nhòe theo thời gian.
Window ngắn: định vị sự kiện nhanh tốt hơn, đỉnh phổ rộng hơn.
Zero-padding: lưới bin dày hơn, fs/nfft thay cho fs/L.
Không thêm chu kỳ quan sát, nên không tăng độ phân giải thật.
Hỏi nhanh
Hai bài toán có cùng sample rate. Bài (1) định vị tiếng gõ phím chỉ kéo dài vài mili giây. Bài (2) phân biệt hai nốt nhạc ngân dài, cao độ chênh nhau vài Hz. Nên chọn window thế nào?
Window ngắn giữ được tiếng gõ không bị nhòe. Window dài chứa nhiều chu kỳ, nên tách được hai đỉnh tần số gần nhau.
Hỏi nhanh
Bộ lọc của bài đặt 22 mốc đều theo mel trên dải 0-1000 Hz. Hai mốc đầu cách nhau khoảng 30 Hz. Hai mốc cuối cách nhau khoảng bao nhiêu?
Mốc đều theo mel, nhưng ở tần số cao một bước mel ứng với khoảng Hz rộng hơn, nên hai mốc cuối cách nhau khoảng 70 Hz.
(20,101) @ (101,19) cho (20,19).
Mốc của hình là đỉnh clip; quy ước mel là HTK.
Hỏi nhanh
Mel power có phần tử bằng 0. Trước khi lấy log, vì sao người ta thường tính log(max(power,ε)) với ε>0?
log0=−∞, và một ô -inf đủ làm mean, loss và gradient thành nan.
Power (1,4,1), trọng số (0.5,1,0.5):
M=0.5+4+0.5=5.Mốc 5 cho 0 dB; power 0.5 cho −10 dB.
Kết quả(20, 101) (20, 19)
[-112.1    0. ]
True
True kiểm mọi giá trị log-mel đều hữu hạn. Chặn trước log để tránh -inf; dải hiển thị có thể hẹp hơn dải số.
(0,0.2,−0.4,0.2) chia cho 0.4:
Kết quả[ 0.   0.5 -1.   0.5]
[0. 0. 0. 0.]
RMS trước = 0.245
Clip toàn 0 giữ nguyên, không chia cho peak 0.
Chuẩn hóa từng clip có thể xóa thông tin âm lượng hữu ích.
Hỏi nhanh
Đề phân loại máy bơm “bình thường” và “kẹt”, ghi bằng cùng một microphone đặt cố định. Máy kẹt rung mạnh hơn: dạng sóng gần giống máy bình thường, nhưng biên độ gấp khoảng 3 lần. Một đội peak-normalize từng clip trước khi tính log-mel. Chuyện gì xảy ra?
Peak normalization chia mỗi clip cho đỉnh của chính nó, nên khác biệt biên độ giữa hai lớp bị xóa trước khi vào model.
Hỏi trước: sau biến đổi, đáp án còn là đáp án cũ?
Nhãn cao độ nốt: pitch shift đổi nhãn. Nhãn transcript: crop mất từ đổi nhãn.
SpecAugment che một dải thời gian hoặc tần số trên log-mel, chỉ lúc train.
Điền 0 sau z-score là điền mean của band.
Hỏi nhanh
Nhãn là transcript đầy đủ của câu nói. Crop ngẫu nhiên làm mất nửa cuối clip, nhưng vẫn giữ transcript cũ. Làm vậy có hợp lệ không?
Clip còn lại không chứa nửa sau câu nói, nên model bị dạy “nghe” ra những chữ không có trong âm thanh.
Hỏi nhanh
Nhãn là danh tính người nói, gồm 10 người trong một câu lạc bộ. Phép augmentation nào dễ làm sai nhãn nhất?
Cao độ là một phần danh tính của giọng. Đẩy lên 4 bán cung có thể làm giọng người này giống người khác.
Luyện đề 1
Clip 1 giây ở 16 kHz, window 400 mẫu, hop 160 mẫu. Số frame STFT khi không padding, và khi center=True, tức đệm 200 mẫu mỗi đầu, lần lượt là bao nhiêu?
Không padding: ⌊15600/160⌋+1=98. Với center=True: ⌊16000/160⌋+1=101.
Phỏng theoCMU 10-601 · Exam 3 Practice · Q1.2(b)
Luyện đề 2
STFT của bài, với window 200, hop 100 và Hann, có thể viết bằng nn.Conv1d(1, 202, kernel_size=200, stride=s, bias=False) với 202 kernel cố định, gồm 101 cosine và 101 sine đã nhân Hann. Với waveform shape (1, 1, 2000), s bằng bao nhiêu, và output có shape gì?
Stride đóng vai hop, nên có 19 vị trí. 202 kênh gồm phần thực và phần ảo của 101 bin.
Luyện đề 3
Đề cho mỗi mẫu là một chuỗi 500 giá trị cảm biến, không ghi sample rate. Một đội cắt frame dài 50, hop 25, rồi lấy rfft của mỗi frame làm token cho Transformer. Có bao nhiêu token, và trục tần số của mỗi token đọc thế nào?
Có 19 token. Không có sample rate thì trục tần số chỉ ghi được theo chu kỳ mỗi mẫu, tức k/50.
Waveform luôn đi cùng sample rate; giảm sample rate phải lọc trước.
STFT: window quyết định đoạn quan sát, hop quyết định bước trượt; log-mel nén lại cho model.
Làm 10 câu kiểm tra cuối bài trên trang bài học.
Chạy notebook; đổi hop của stft_power, dự đoán số frame trước rồi kiểm bằng power.shape.