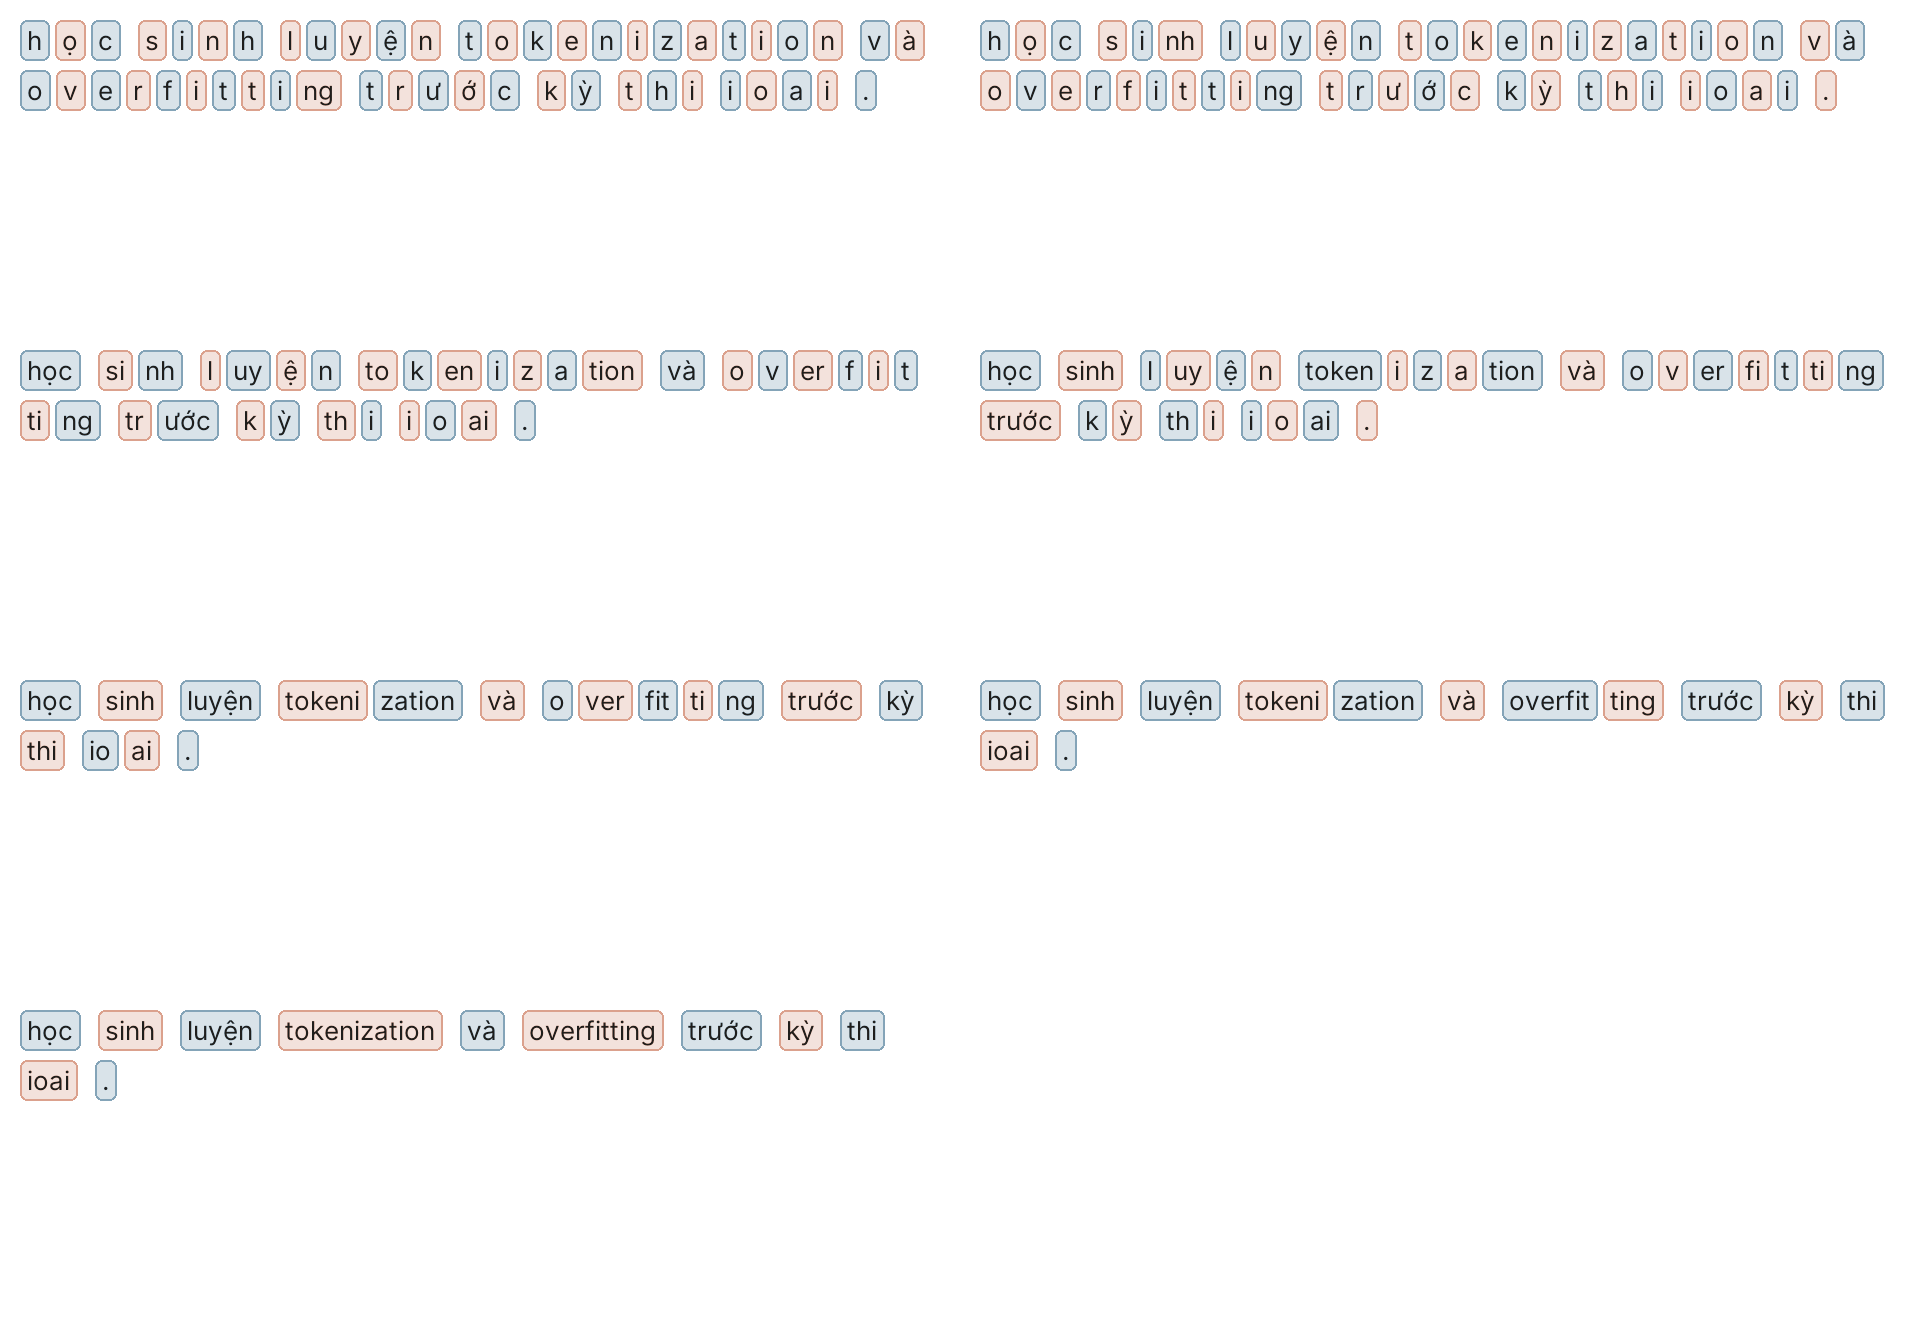
Từ nhận xét lớp học đến một baseline đọc được lỗi
Chương 6 · Bài 6.1
Nhận xét: “ví dụ hay”, “bài giảng khó hiểu”, “không tệ”.
Có vài nghìn nhận xét. Muốn tìm những phần cần sửa trước.
Chuỗi ký tự → token → vector → nhãn.
Câu hỏi: bước nào làm mất thông tin khi biến câu thành số?
print(normalize_text(sentence).split())
nfc = unicodedata.normalize("NFC", "ho\u0323c")
print(nfc == "học")
Kết quả['học', 'sinh', 'học', 'máy']
True
học_sinh.Hỏi nhanh
"học sinh".split() trả về hai mảnh. Từ đó ta rút ra được điều gì?
Khoảng trắng tiếng Việt ngăn âm tiết, còn “học sinh” là một từ hai âm tiết. Nối bằng _ là quy ước riêng của PhoBERT.
Hỏi nhanh
Chuỗi b in ra trông như “học”, nhưng b == "học" lại là False, và [hex(ord(ch)) for ch in b] cho ['0x68', '0x6f', '0x323', '0x63']. Trước khi đếm token, nên xử lý thế nào?
0x323 là dấu nặng kết hợp đứng sau chữ “o”. NFC gộp hai ký tự ấy thành “ọ”, nên hai chuỗi trùng nhau mà vẫn giữ dấu.
Train: low 3 lần, lower 2 lần, new 1 lần.
Cặp l,o: 3+2=5 lần.
Phá hòa theo thứ tự từ điển: gộp l,o trước. Lặp đến khi đủ từ vựng.
Kết quả('l', 'o') 5
low ['lo', 'w']
lower ['lo', 'w', 'e', 'r']
new ['n', 'e', 'w']
Đếm có trọng số, không đếm mỗi loại từ một lần.
Hỏi nhanh
Sau bước gộp l,o, corpus gồm lo w 3 lần, lo w e r 2 lần, và n e w 1 lần. Bước BPE thứ hai gộp cặp nào?
lo,w có trong low 3 lần và lower 2 lần. Sau bước một, o không còn đứng riêng, nên cặp o,w đã biến mất.
Từ vựng có play, ##ing: playing thành play, ##ing.
## đánh dấu mảnh nối tiếp (BERT).
Khi học: chọn cặp có f(a)f(b)f(a,b) cao nhất.
Không mảnh nào khớp: cả từ thành [UNK].
BPE lưu luật gộp; WordPiece chỉ giữ vocabulary cuối.
GPT-2: BPE trên byte, không cần token unknown.
Hỏi nhanh
Từ vựng WordPiece chỉ có un, una, ##able và [UNK]. Mã hóa từ unable thì được gì?
Thuật toán tham lam chọn una, rồi không mảnh nào khớp với ble, nên cả từ thành [UNK]. Nó không quay lui để thử un.
Số lần xuất hiện nhân IDF, rồi chuẩn hóa L2 từng câu.
Mục phổ biến giảm trọng số tương đối. Công thức không tự hiểu nghĩa: hai từ đồng nghĩa vẫn ở hai cột.
Hỏi nhanh
Sau TF-IDF có chuẩn hóa L2 mặc định, nhận xét “hay” và nhận xét “hay hay hay” cho ra hai vector thế nào?
Cả hai chỉ có một ô khác 0 ở cột “hay”. Chia cho độ dài thì ô ấy đều thành 1.
Nhãn 1: tích cực.
Nhãn 0: tiêu cực.
Unigram bỏ thứ tự; bigram giữ một phần thứ tự.
Làm trơn Laplace α=1: không có xác suất 0.
Giả định: token độc lập khi biết nhãn.
“theo” gần như luôn đi với “dõi”: bằng chứng bị cộng hai lần, xác suất quá tự tin.
Vẫn là bộ phân loại tuyến tính trên vector đếm.
baseline = Pipeline([
    ("tfidf", TfidfVectorizer(
        preprocessor=normalize_text,
        ngram_range=(1, 2))),
    ("classifier", LogisticRegression(
        C=4.0, random_state=0, max_iter=1000)),
])
baseline.fit(train_texts, train_labels)
12 câu train, 6 câu validation tự soạn.
Mỗi câu validation đổi accuracy 1/6≈0.167.
Đủ để soi lỗi, quá ít để so hai model.
Kết quảshape train: (12, 69)
accuracy: 0.667
macro-F1: 0.667
[[2 1]
 [1 2]]
69 cột: 31 âm tiết và 38 bigram của train.
Hàng: nhãn thật. Cột: nhãn đoán.
4/6 câu đúng, mỗi lớp có một câu bị nhầm.
Hỏi nhanh
Ta muốn chạy 5-fold cross-validation cho baseline trên cả 18 câu có nhãn. Làm cách nào thì điểm mới tin được?
cross_val_score fit lại cả Pipeline trên phần train của mỗi fold, nên vocabulary và IDF chỉ đến từ phần đó.
Kết quảthật=0 đoán=1 p1=0.597 | bài giảng không hay
thật=1 đoán=0 p1=0.448 | khóa học không tệ
'không' có trong vocabulary: False
Từ lạ không có cột.
Bigram chưa học cũng không có cột.
Đọc token và feature trước khi đổi model.
naive_bayes = Pipeline([
    ("count", CountVectorizer(
        preprocessor=normalize_text,
        ngram_range=(1, 2))),
    ("classifier", MultinomialNB(alpha=1.0)),
])
Kết quảNB đoán: [1 0 1 1 0 0]
thật:    [1 0 0 1 0 1]
Sai đúng hai câu “không”.
Cùng vocabulary nên cùng lỗi.
Hỏi nhanh
Cả logistic regression lẫn Naive Bayes đều đoán ngược hai câu có chữ “không”. Bước tiếp theo nào nhắm đúng nguyên nhân?
Hai model khác nhau cùng sai ở cùng hai câu, nên lỗi nằm ở biểu diễn chung: “không” chưa có cột.
3 câu: “hay dễ”, “hay rõ”, “khó”.
IDF của “hay” là 1.288, của “dễ” là 1.693.
Sau L2: (0.605,0.796).
Trọng số giả định (1,−1), bias 0:
z≈−0.191, p≈0.452.
Nếu “hay” có ở cả ba câu: IDF bằng 1, giảm tương đối chứ không bị xóa.
Hỏi nhanh
Giữ IDF như trên, trọng số giả định là (1,−1) và bias bằng 0. Câu “hay hay dễ” cho p xấp xỉ bao nhiêu?
Sau chuẩn hóa, vector là (0.836, 0.549), nên z≈0.286 và p≈0.571.
Luyện đề 1
Câu được mã hóa thành [BOS] + từ + [EOS], dài quá thì cắt tokens[:max_len]. Với max_len = 8 và một câu 9 từ, lỗi chính là gì?
Câu 9 từ thêm BOS và EOS thành 11 token. Cắt còn 8 thì giữ BOS và 7 từ, mất EOS. Sửa bằng cách cắt nội dung về max_len - 2 trước, rồi mới thêm hai token đặc biệt.
Phỏng theoNOAI 2026 Singapore · Chung kết · Câu 19
Luyện đề 2
Bình luận sản phẩm có nhiều tên hãng mới và lỗi gõ như “đẹppp”. Tokenizer theo từ đã có 300 nghìn mục mà test vẫn đầy từ lạ. Chuyển sang subword như BPE hay WordPiece thì được lợi chính ở đâu?
Subword chia tên hãng mới hay từ gõ sai thành những mảnh đã biết, thay vì một token unknown, mà từ vựng vẫn nhỏ.
Luyện đề 3
Corpus là list từ ["bun"]*5 + ["sun", "sing", "king", "ring"]. Một bạn đếm các cặp ký tự kề nhau trong vòng for word in set(corpus), và phá hòa theo thứ tự từ điển. Bước gộp BPE đầu tiên đúng ra là gì, và code này gộp gì?
Đếm có trọng số thì u,n có 6 lần. set bỏ các bản lặp, nên u,n chỉ còn 2, và code gộp i,n.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 5.1-5.2
Tokenization quyết định thông tin nào vào được model; TF-IDF chỉ giữ từ vựng.
Hai model cùng sai một câu: xem biểu diễn trước khi đổi model.
Làm 10 câu kiểm tra cuối bài trên trang bài học.
Chạy notebook và đọc hai câu phủ định trước khi thử một thay đổi có kiểm chứng.