Nạp đúng model và chạy dự đoán đầu tiên
Chương 4 · Bài 4.1
Ít ảnh có nhãn, muốn xếp nhóm để tìm lại.
Có model đã được công bố. Ta cần gì ngoài tên model?
Cần thêm: cách xử lý ảnh đầu vào, bảng nhãn, đúng phiên bản.
Sai một thứ thì code vẫn chạy, nhưng kết quả sai.
nn.Linear(2, 3) tạo các phép toán và trọng số ban đầu.
Pretrained cần trọng số đã học từ nhiệm vụ trước.
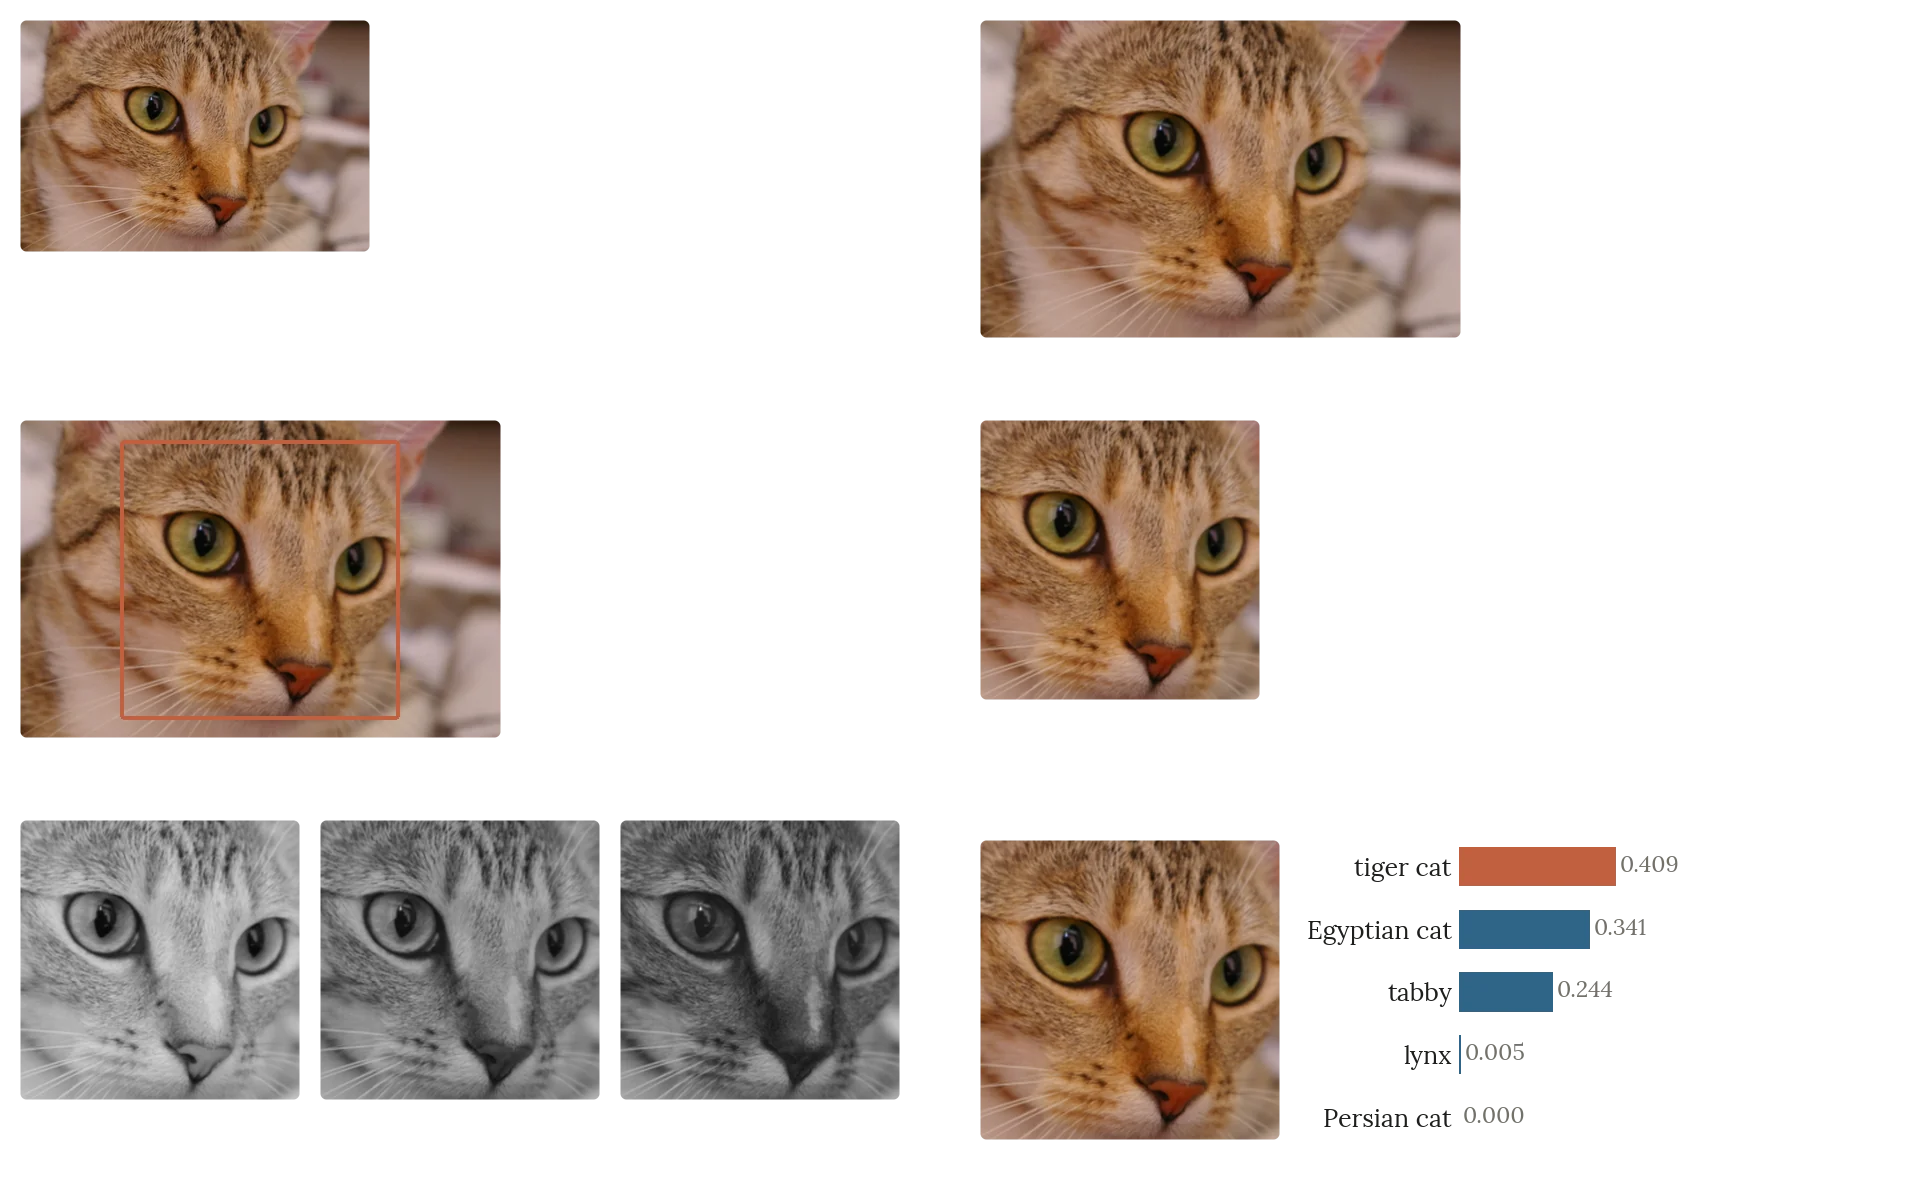
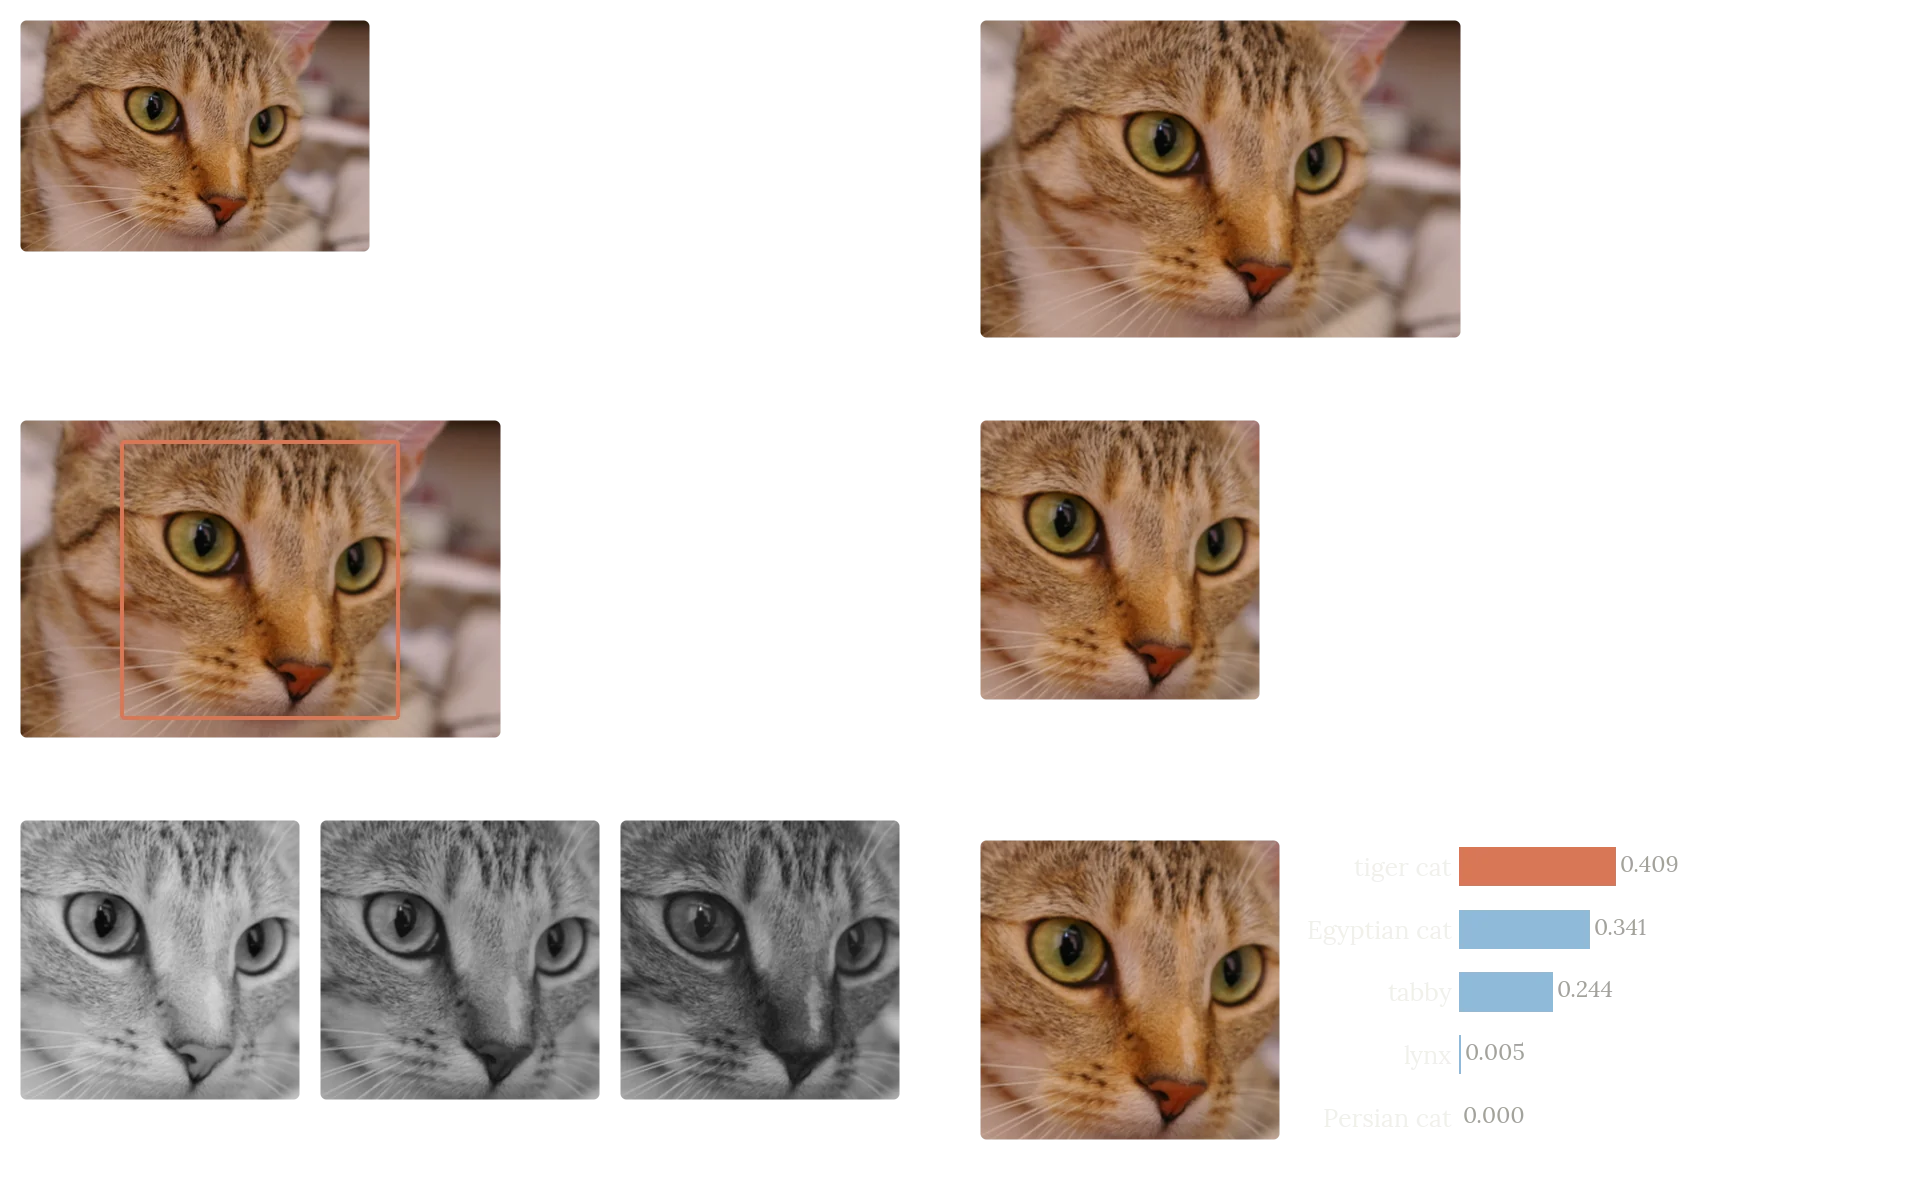
Processor quyết định input:
Hỏi nhanh
Có kiến trúc ResNet, và trọng số được khởi tạo ngẫu nhiên. Mô hình này đã là một model pretrained chưa?
“Pretrained” nằm ở trọng số đã học, không ở tên kiến trúc. eval() không thêm điều gì đã học.
| Loại input | Shape |
|---|---|
| Ảnh | (B, C, H, W) |
| Token IDs | (B, L) |
| Logits phân loại | (B, K) |
B: batch · K: lớp · L: độ dài token.
Ảnh có C kênh, chiều cao H và chiều rộng W.
ImageNet: chia 255, rồi chuẩn hóa mean/std từng kênh.
Hỏi nhanh
Processor của checkpoint nhận pixel từ 0 đến 255, tự chia cho 255, rồi trừ mean và chia std. Code của đội lại đã chia cho 255 trước khi gọi processor. Chuyện gì xảy ra?
Sau hai lần chia, mọi pixel nằm trong [0,1/255], nên sau chuẩn hóa ảnh nào cũng gần như một màu. Shape và kiểu dữ liệu vẫn đúng nên không có lỗi nào.
Trọng số đặt tay để kiểm được từng con số.
model.load_state_dict(
    loaded["state_dict"], strict=True)
model.eval()
print("shape W:", tuple(model.weight.shape))
Kết quảshape W: (3, 2)
strict=True: kiểm tên và shape.map_location="cpu": mở trên CPU.weights_only=True: chỉ mở tensor, số, chuỗi.Hỏi nhanh
Checkpoint được lưu từ một model bọc trong DataParallel, nên các khóa là module.weight và module.bias, trong khi model mới chờ weight và bias. Đội gọi load_state_dict(sd, strict=False). Kết quả là gì?
strict=False bỏ qua mọi khóa thiếu và thừa. Không khóa nào khớp, nên model giữ trọng số khởi tạo mà không báo lỗi. Bỏ tiền tố module. rồi nạp với strict=True.
Đây là logits của một mẫu. Lớp 0 thắng; argmax không cần softmax.
with torch.inference_mode():
    logits = model(process(raw))
    predicted = logits.argmax(dim=1)
print(logits.numpy().round(2))
Kết quả[[ 2.   -2.    0.25]
 [-2.    2.    0.25]
 [ 0.    0.    0.25]
 [ 4.   -4.    0.25]
 [-1.    1.    0.25]]
Hàng thứ ba chỉ còn bias: input ở đúng trung bình.
Hỏi nhanh
logits có shape (5, 3). Muốn mỗi mẫu có một nhãn, ta dùng gì?
Chiều 1 chạy qua ba lớp của cùng một mẫu, nên argmax theo chiều ấy cho mỗi mẫu một chỉ số.
print("batch khop:",
      torch.allclose(batched, logits))
print("NumPy khop:",
      np.allclose(batched.numpy(), expected))
print("so mau:", len(batched))
Kết quảbatch khop: True
NumPy khop: True
so mau: 5
Phép so batch kiểm việc ghép hàng.
Phép so NumPy kiểm công thức bằng một đường tính độc lập.
ID phải đi cùng mỗi output.
eval() và inference_mode() kiểm hai việc khác nhaumodel.eval():
Dropout và BatchNorm chuyển cách hoạt động.
torch.inference_mode():
Không theo dõi gradient cho suy luận.
Nó không tự gọi eval().
eval()Hỏi nhanh
CNN pretrained có BatchNorm. Đội quên gọi eval(), nhưng có inference_mode(). Chạy cùng tập test với batch 32 rồi với batch 8, hai file nộp khác nhau ở vài dòng. Vì sao?
Ở chế độ train, BatchNorm chuẩn hóa mỗi ảnh bằng thống kê của batch chứa nó, nên đổi batch là đổi logits. eval() dùng running statistics đã lưu.
Hỏi nhanh
Model đã gọi eval(), nhưng vòng dự đoán không bọc trong inference_mode() hay no_grad(). Tham số vẫn có requires_grad=True, còn input thì không. Câu nào đúng?
Graph được ghi khi có một đầu vào cần gradient, và tham số đã đủ điều kiện ấy. eval() không đụng tới autograd.
P là số tham số; s là byte mỗi tham số: FP32 dùng 4, FP16 dùng 2.
Một MiB bằng 220 byte.
Model 100 triệu tham số:
| Precision | Trọng số thô |
|---|---|
| FP32 | 381.47 MiB |
| FP16 | 190.73 MiB |
Chưa tính input, activation, buffer, optimizer.
Batch 16 ảnh RGB 224×224, float32:
Gấp đôi cạnh ảnh tốn ngang gấp bốn batch.
Đo một batch nhỏ trên đúng thiết bị rồi tăng dần.
Hỏi nhanh
Một batch 16 ảnh RGB 224×224 kiểu float32 chiếm 9.19 MiB. Đổi sang batch 32 và ảnh 448×448 thì tensor input chiếm bao nhiêu?
Batch gấp 2, số pixel mỗi ảnh gấp 4, nên tổng gấp 8: 73.5 MiB.
Hỏi nhanh
Đội đưa ảnh câu lạc bộ vào một ResNet học trên ImageNet, còn nguyên head, rồi lấy argmax trên 1000 logits. Kết quả là gì?
Head có đúng 1000 đầu ra, mỗi đầu ra là một lớp ImageNet, nên argmax luôn là một lớp ImageNet. Không có lỗi shape, vì model không biết đội muốn bao nhiêu nhãn.
Lượt có mạng:
Lượt offline:
local_files_only=True).Rồi mới chấm validation.
Hỏi nhanh
Hai tuần sau, đội tải lại cùng model ID từ nhánh main, chạy năm ảnh kiểm ở chế độ eval, và thấy logits khác lần trước ngay từ chữ số đầu. Nên kiểm gì đầu tiên?
Nhánh main có thể đã được cập nhật. So commit và SHA-256 với ASSET.json để biết các byte còn như cũ không. Suy luận ở chế độ eval không có yếu tố ngẫu nhiên.
Luyện đề 1
ResNet-50 nhận input (B, 3, 224, 224). Phần đầu, gồm conv stride 2 rồi max-pool stride 2, đưa ảnh về 56×56. layer1 giữ 56×56 và cho ra 256 kênh. Khối đầu của layer2 có conv 3×3 stride 2 trên 128 kênh, rồi conv 1×1 mở ra 512 kênh. Đầu ra của layer2 có shape gì?
Stride 2 chia đôi cạnh, 56→28, và số kênh ra là của conv cuối khối, 512.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 8.2
Luyện đề 2
Biểu thức nào đếm đúng số tham số học được của ResNet-50?
Đếm numel trên parameters() cho 25 557 032 tham số học được. state_dict() còn chứa buffer của BatchNorm, như running mean và variance, nên ra 25 610 205.
Phỏng theoUSA-NA-AIO 2026 · Vòng 1 · Part 8.1
Luyện đề 3
Trên Colab, đội lưu torch.save(model, "m.pt"), tức lưu cả đối tượng model. Máy chấm dùng PyTorch mới, và torch.load("m.pt") báo lỗi “Weights only load failed”. Lần sau nên lưu thế nào cho bền?
Lưu cả đối tượng model là pickle, phụ thuộc định nghĩa lớp, và bị weights_only=True chặn. Hãy lưu state_dict() kèm config, rồi dựng kiến trúc bằng code trước khi nạp.
Một model dùng được gồm kiến trúc, trọng số, processor và bảng nhãn; thiếu một thứ là kết quả sai mà không báo lỗi.
Chạy theo batch phải giữ ID; đo bộ nhớ trên thiết bị thật; model tải về phải nạp lại được khi không có mạng.
Làm 10 câu kiểm tra cuối bài trên trang bài học.
Chạy notebook: đổi batch size, kiểm thứ tự output không đổi.