Định giá căn hộ từ diện tích và khoảng cách
Chương 2 · Bài 2.1
Một căn hộ 70 m², cách trung tâm 8 km, rao bán 4,2 tỷ.
Có giá của 200 căn đã bán quanh đó (dữ liệu giả lập).
Căn rộng hơn thì đắt hơn, xa trung tâm thì rẻ hơn.
Linear regression viết cách ước lượng ấy thành công thức và tìm hệ số từ dữ liệu.
Mỗi đặc trưng đóng góp một lượng tỉ lệ với nó, rồi cộng lại:
y^=w1x1+⋯+wdxd+b=w⊤x+bwj: dự đoán tăng bao nhiêu khi xj tăng 1 đơn vị và các đặc trưng khác giữ nguyên.
Cho cả n mẫu cùng lúc:
y^=Xw+b| Ký hiệu | Shape |
|---|---|
| X | (n, d) |
| w | (d,) |
| y^, y | (n,) |
Tự sinh 200 căn theo một công thức biết trước, cộng nhiễu:
giaˊ=0.05⋅diện tıˊch−0.15⋅khoảng caˊch+1Biết trước đáp án thì kiểm tra được mô hình học đúng hay sai.
rng = np.random.default_rng(0)
n = 200
area = rng.uniform(30, 120, n)
dist = rng.uniform(1, 15, n)
y = 0.05 * area - 0.15 * dist + 1.0 \
    + rng.normal(0, 0.3, n)
X = np.column_stack([area, dist])
print(X.shape, y.shape)
Kết quả(200, 2) (200,)
Hỏi nhanh
X có shape (200, 2), w có shape (2,). X @ w + b có shape gì?
Mỗi hàng của X nhân vô hướng với w cho ra một số, nên 200 hàng cho 200 số. NumPy không tự thêm chiều thứ hai.
Vì sao bình phương?
Nhược điểm: nhạy với outlier.
Mô hình đoán mọi căn bằng giá trung bình có
MSE=Var(y)=2.34Trên cùng tập chấm, mô hình có MSE lớn hơn mốc này chưa cải thiện sai số so với dự đoán hằng số.
R2=1−Var(y)MSER2=0: ngang mốc · R2=1: đoán trúng hết
Hỏi nhanh
Đổi đơn vị giá từ tỷ đồng sang triệu đồng, tức nhân mọi y với 1000. MSE thay đổi thế nào?
Mỗi phần dư nhân 1000, bình phương lên thành 106. Vì vậy người ta hay báo RMSE, cùng đơn vị với giá.
Thêm cột 1 vào X: X~=[X1], gộp θ=(w,b), khi đó y^=X~θ.
Cực tiểu của J là nơi gradient bằng 0:
∇J(θ)=n2X~⊤(X~θ−y)=0⟺X~⊤X~θ=X~⊤yNếu các cột của X~ độc lập, hệ có nghiệm duy nhất và có thể giải bằng np.linalg.solve. Với hệ suy biến hoặc điều kiện kém, dùng lstsq/QR/SVD thay cho nghịch đảo ma trận.
Xb = np.column_stack([X, np.ones(n)])
theta = np.linalg.solve(Xb.T @ Xb, Xb.T @ y)
w_cf, b_cf = theta[:2], theta[2]
print(w_cf.round(4), round(b_cf, 4))
print(mse(predict(X, w_cf, b_cf), y))
print(predict(np.array([70, 8]), w_cf, b_cf))
Kết quả[ 0.0499 -0.1453] 0.9809
0.08807615180405967
3.309815169606732
y là một vector trong không gian n chiều. Mọi dự đoán X~θ nằm trên mặt phẳng sinh bởi các cột của X~.
Least squares chọn hình chiếu vuông góc của y lên mặt phẳng đó.
Phần dư vuông góc với mọi cột, kể cả cột số 1, nên tổng phần dư bằng 0.
Hỏi nhanh
Thêm vào X một cột “diện tích tính bằng dm²”, đúng bằng 100 lần cột diện tích. Nghiệm đóng sẽ ra sao?
Cột mới chỉ là cột cũ nhân 100. Có vô số cách chia trọng số cho hai cột mà dự đoán vẫn y hệt, nên X~⊤X~ suy biến. solve nếu vẫn chạy thì trả về những hệ số rất lớn, trái dấu.
Không thấy đáy, chỉ cảm nhận độ dốc dưới chân: bước một bước nhỏ về phía dốc xuống, rồi lặp lại.
Với ri=y^i−yi:
∂w∂J=n2X⊤r,∂b∂J=n2i∑ri w←w−η∂w∂J,b←b−η∂b∂Jdef grad(theta, X, y):
weights = theta[:-1]
bias = theta[-1]
residual = predict(X, weights, bias) - y
grad_weights = 2 * (X.T @ residual) / len(y)
grad_bias = 2 * residual.mean()
return np.append(grad_weights, grad_bias)
gd lặp: ghi loss, rồi theta -= lr * grad(...).
Hỏi nhanh
Đặt r = y_hat - y. Dòng nào cập nhật bias đúng?
r.mean() dương nghĩa là đang đoán cao, nên phải trừ bớt b. Dùng r.sum() thì bước lớn gấp n lần.
Ba điểm (1,2), (2,3), (3,5).
Công thức cho một đặc trưng:
w=∑(xi−xˉ)2∑(xi−xˉ)(yi−yˉ),b=yˉ−wxˉxˉ=2, yˉ=10/3, tử số =3, mẫu số =2:
w=1.5,b=31,J=0.056Tại w=b=0: r=(−2,−3,−5),
∂w∂J=−346,∂b∂J=−320Sau một bước: w=1.53, b=0.67, loss từ 12.67 xuống 0.22.
Xấp xỉ đạo hàm chỉ bằng hàm loss, như viết code trâu để đối chiếu:
∂θj∂J≈2hJ(θ+hej)−J(θ−hej)Sai số O(h2), chọn h≈10−5.
Phiên bản grad |
Sai số tương đối |
|---|---|
| Đúng | 7⋅10−13 |
| Quên hệ số 2 | 0.333 |
Sai số nhỏ xác nhận đạo hàm tại điểm đã kiểm. Kiểm vài điểm và thang bước sai phân; bước quá nhỏ có thể tăng sai số số học.
Hỏi nhanh
Vì sao ta dùng sai phân trung tâm 2hJ(θ+h)−J(θ−h) thay vì hJ(θ+h)−J(θ)?
Trừ hai khai triển Taylor cho nhau, các số hạng bậc chẵn triệt tiêu, nên sai số chỉ còn O(h2).
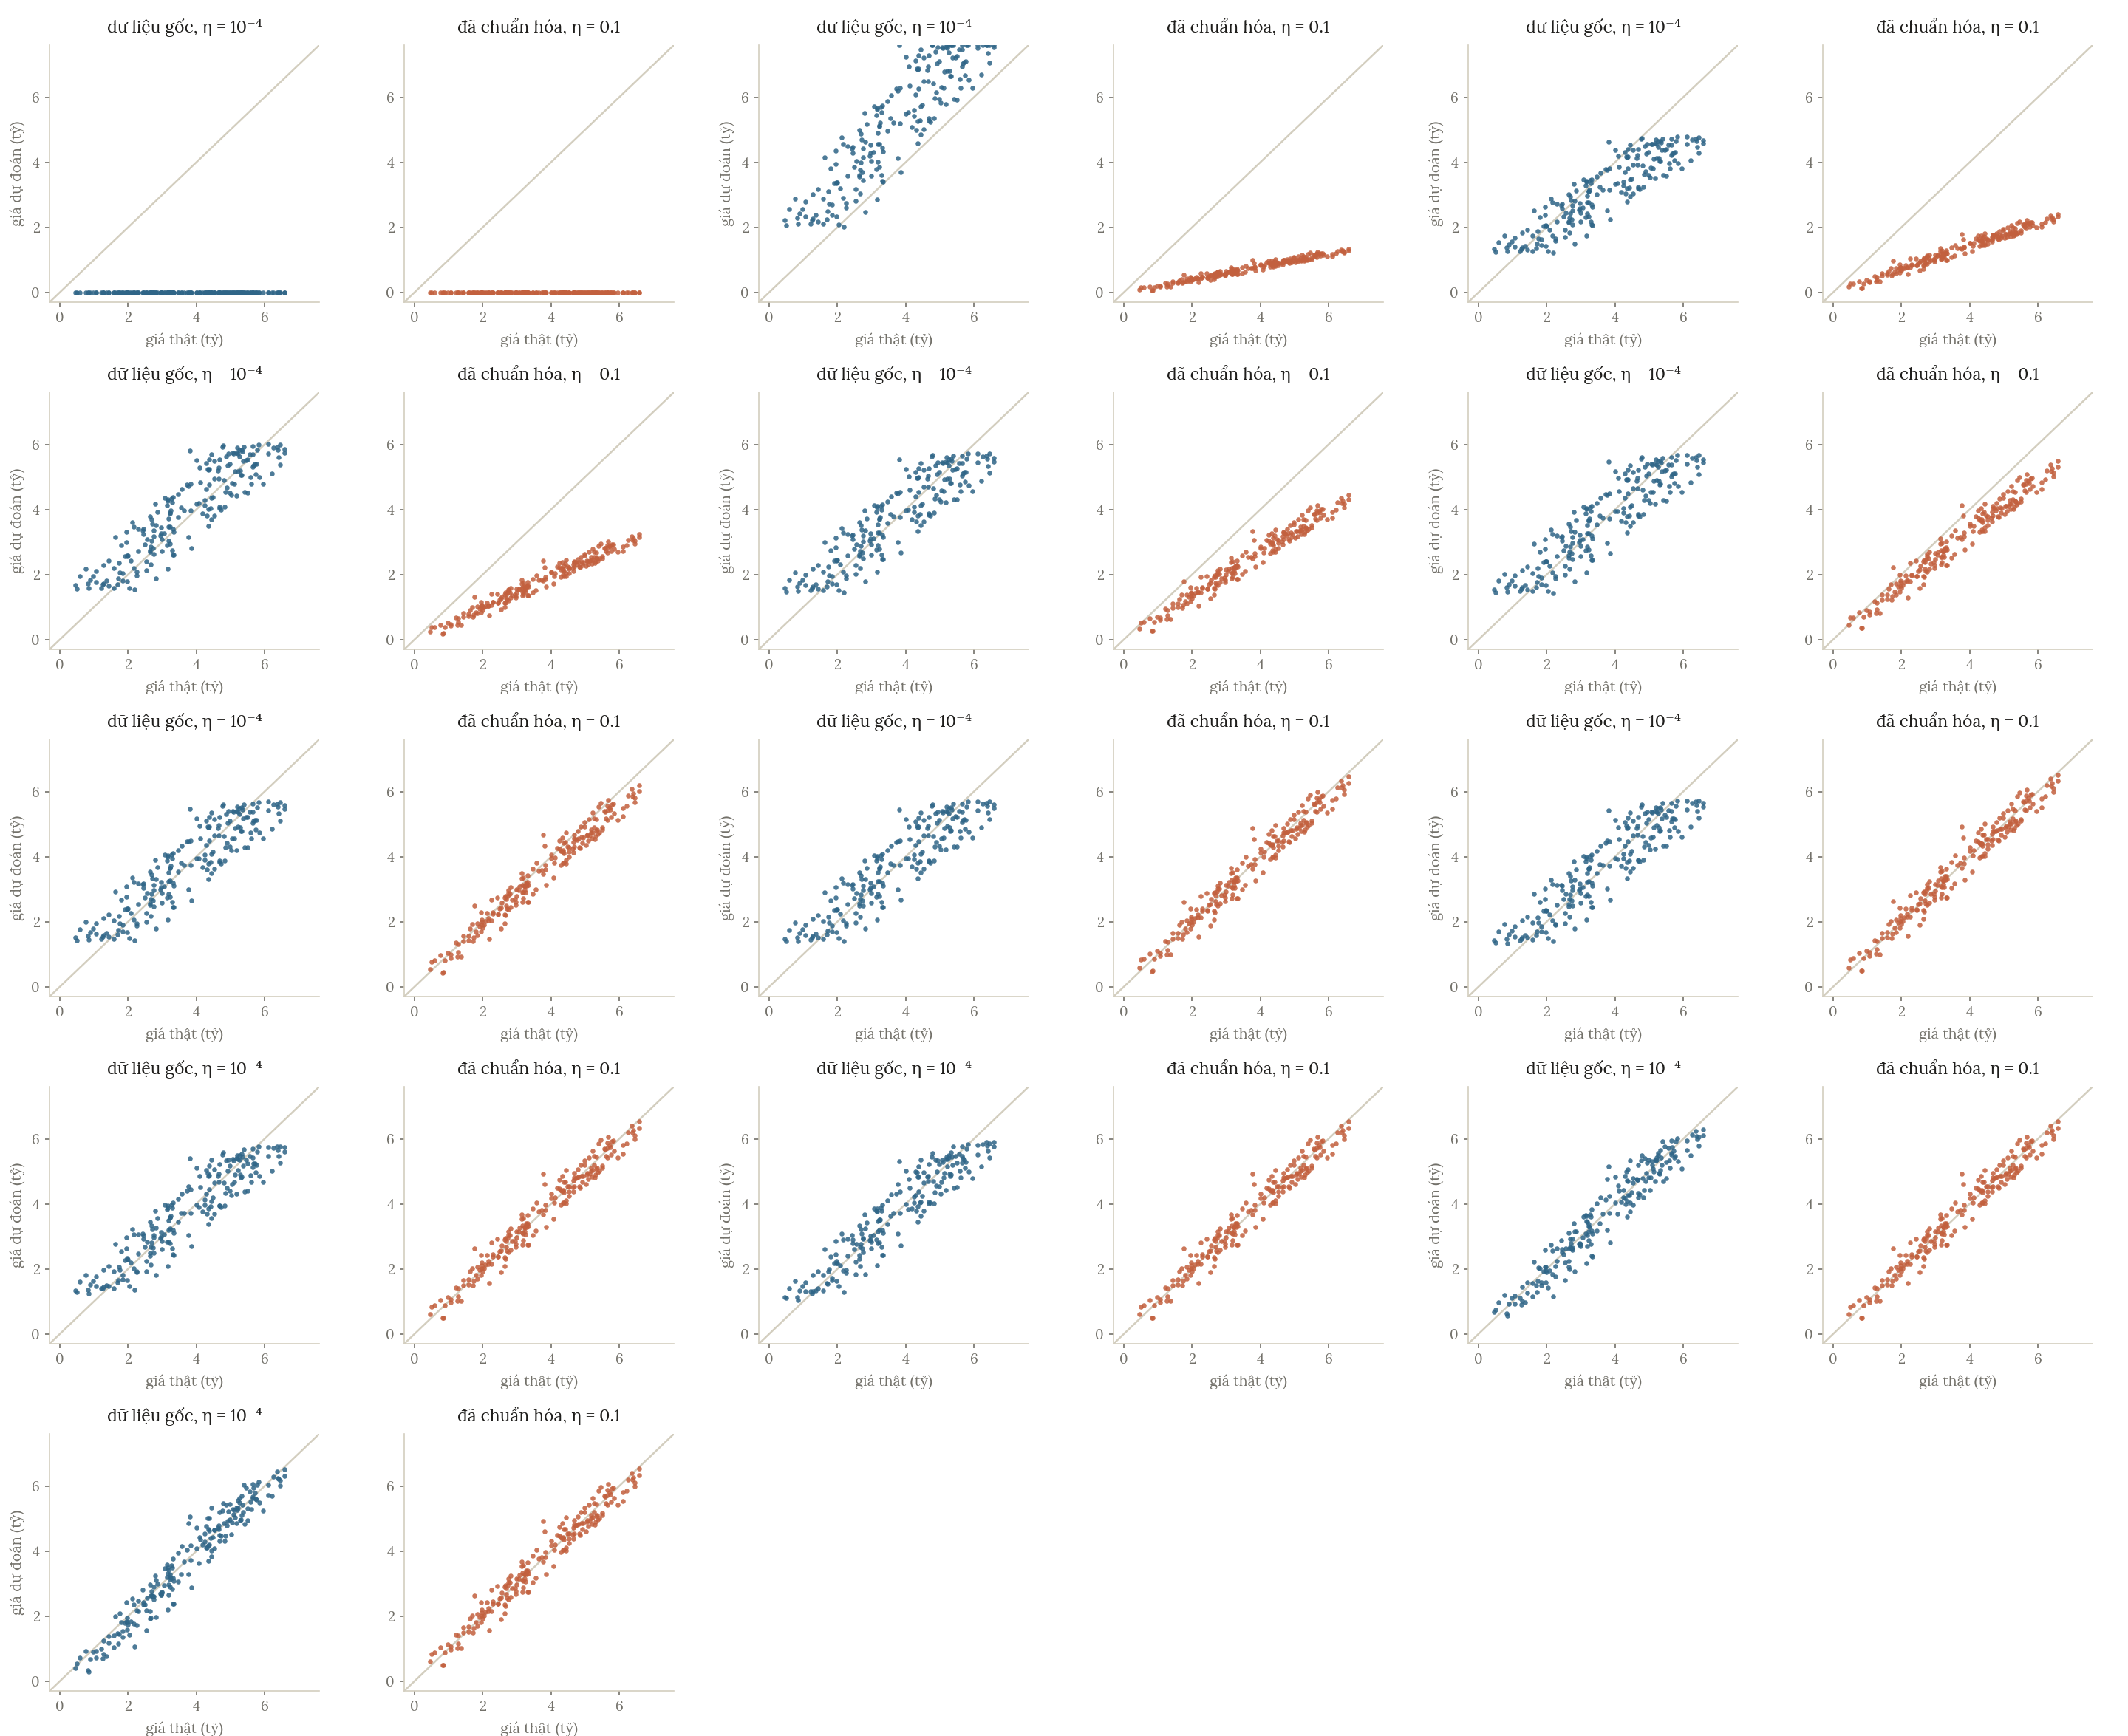
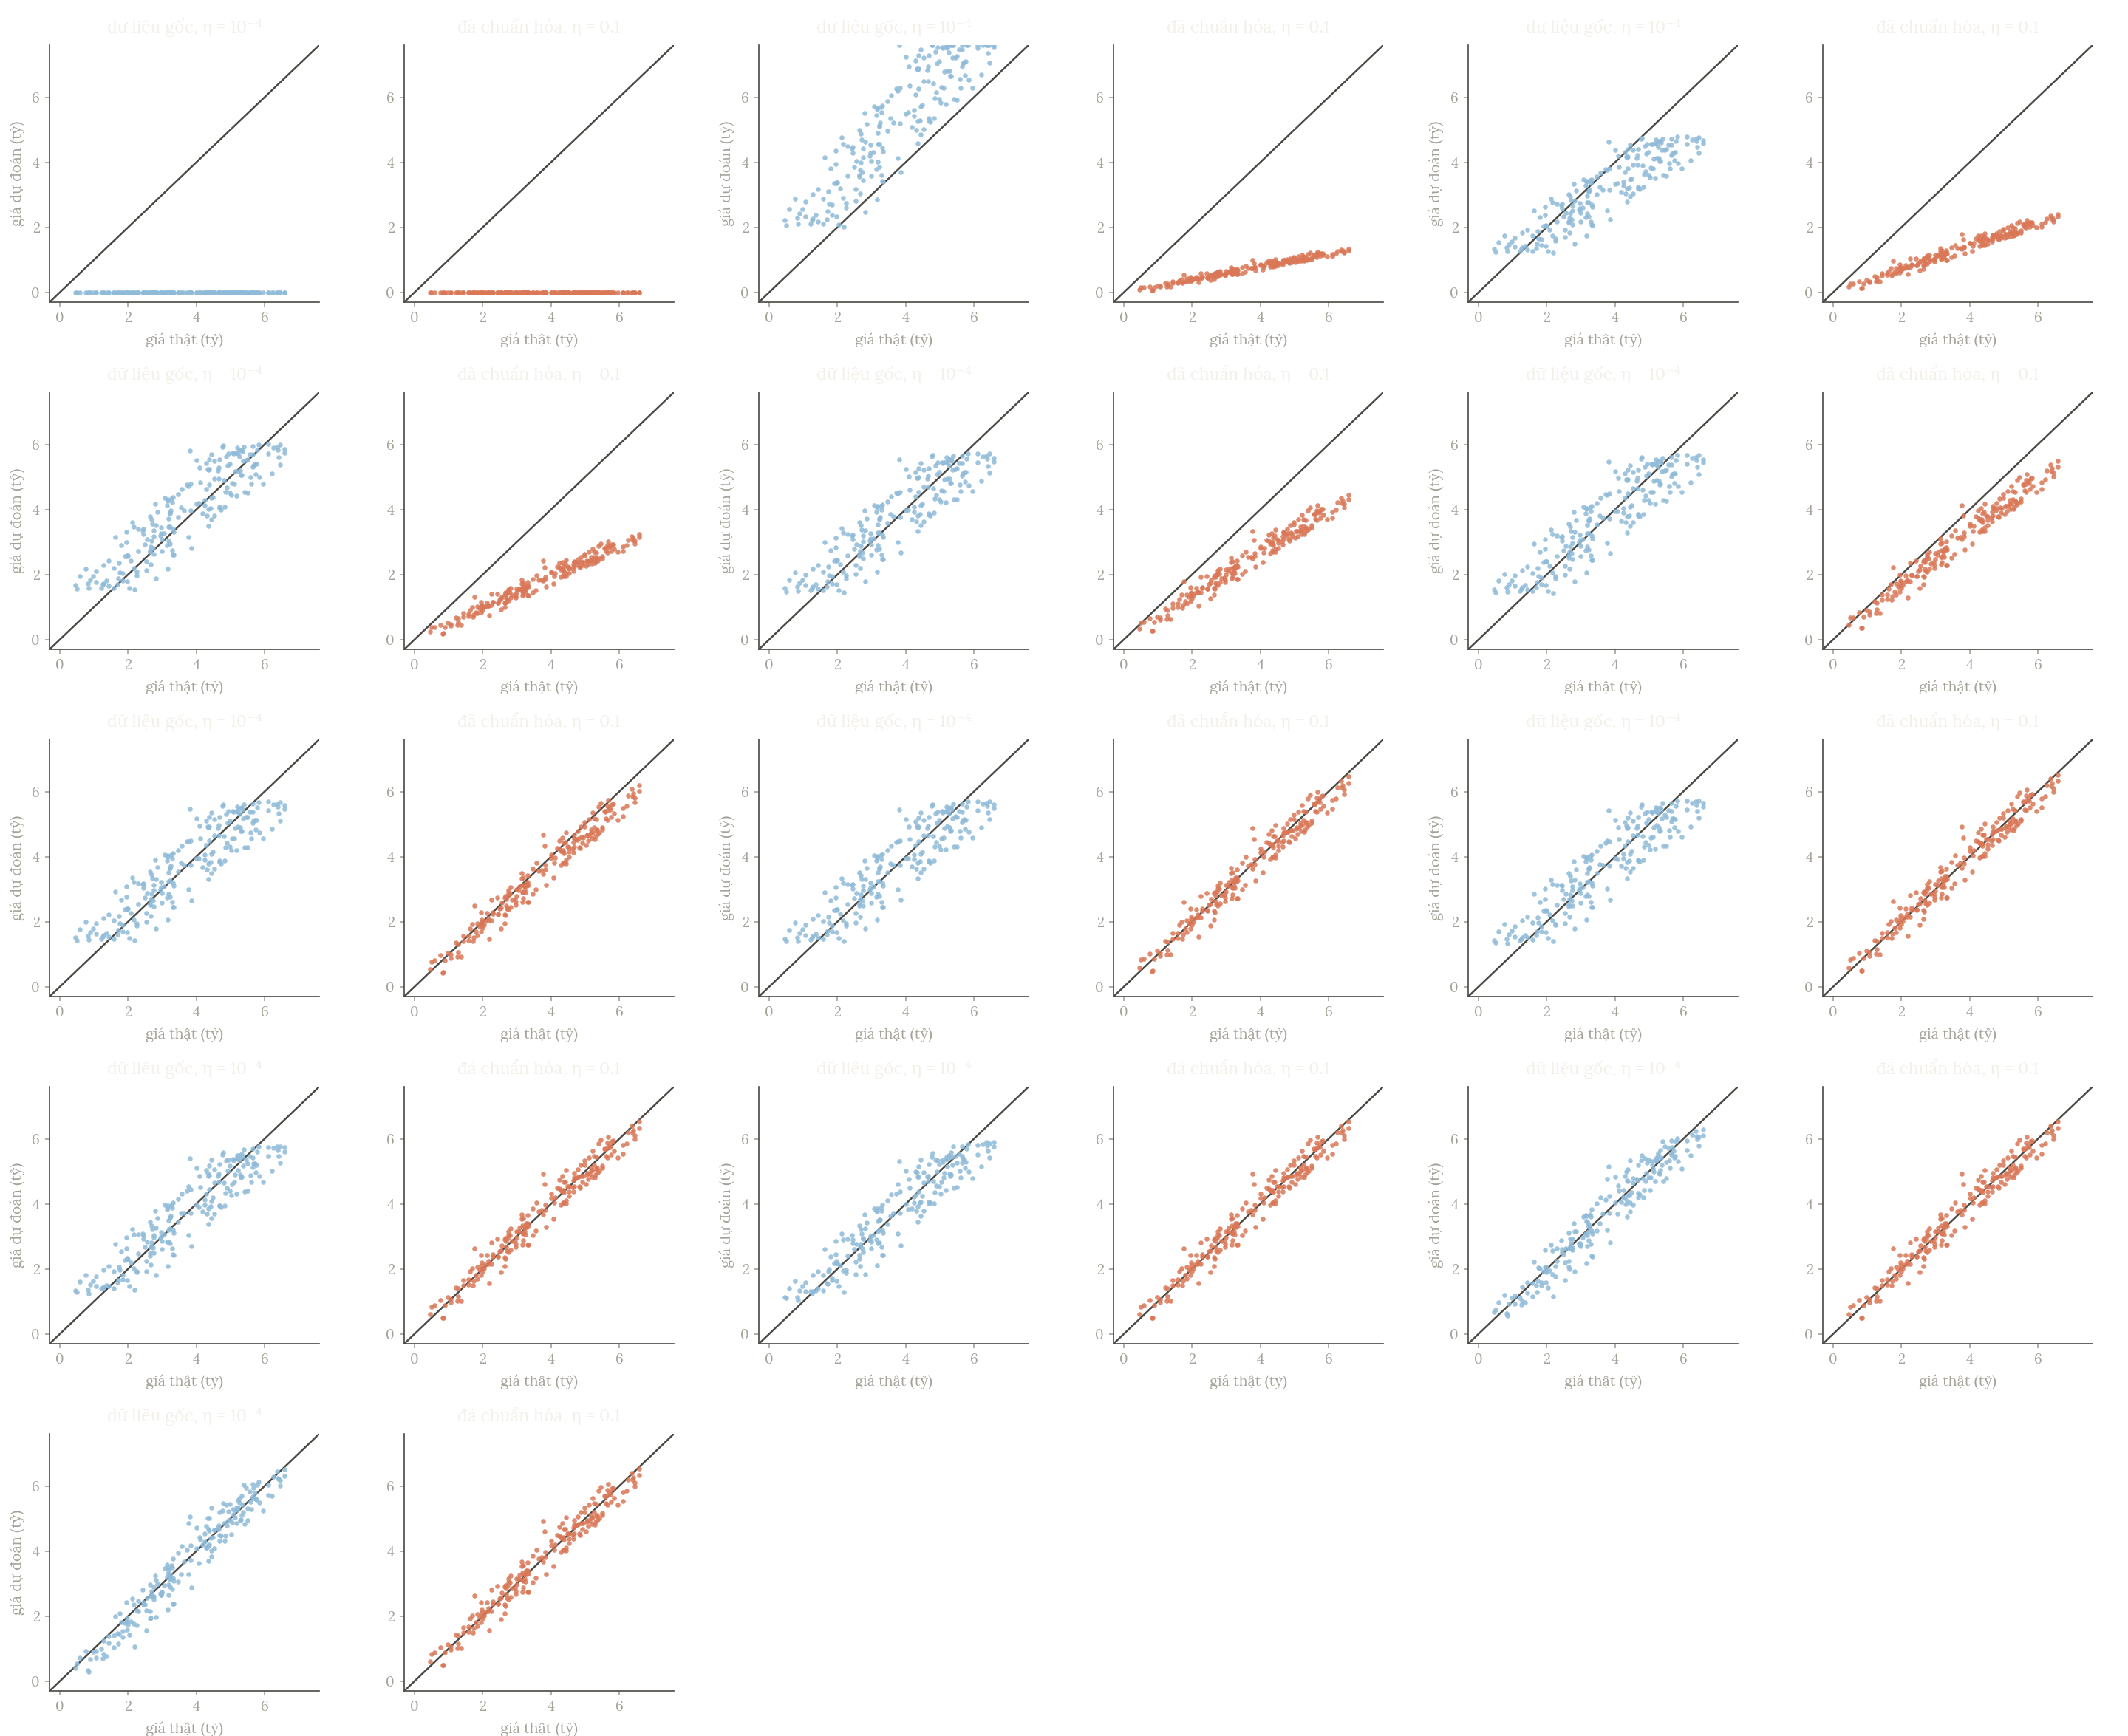
for lr in [1e-3, 2e-4, 1e-4]:
    theta_gd, hist = gd(X, y, lr, 1000)
    print(f"lr = {lr:g}: loss sau 1000 vòng = {hist[-1]:.4g}")
Kết quảlr = 0.001: loss sau 1000 vòng = nan
lr = 0.0002: loss sau 1000 vòng = inf
lr = 0.0001: loss sau 1000 vòng = 0.1541
Có đoán trước được không?
Hessian của J là hằng số H=n2X~⊤X~. Mỗi bước nhân sai số theo hướng ứng với trị riêng λ với (1−ηλ), nên cần
0<η<λmax2Dữ liệu căn hộ: ngưỡng =1.43⋅10−4, số điều kiện κ=λmax/λmin≈105.
Hỏi nhanh
Linear regression tối ưu MSE, loss qua các vòng là 15.9, 41.2, 260, 17 000, rồi NaN. Shape và công thức gradient đều đã kiểm. Ta nên thử gì trước?
Loss tăng theo cấp số nhân là dấu hiệu bước quá lớn, tức η>2/λmax. Feature chênh thang đo làm λmax phình to.
| Dữ liệu gốc | Đã chuẩn hóa | |
|---|---|---|
| Số điều kiện | 105 | 1.1 |
| Ngưỡng η | 1.4⋅10−4 | 0.95 |
| Số vòng tới sát đáy | ~180 000 | 28 |
μ,σ tính trên tập train, dùng lại cho test.
Hỏi nhanh
Chuẩn hóa feature rồi học lại cho tới khi MSE chạm đáy. So với mô hình học trên dữ liệu gốc, cái gì thay đổi?
Đổi biến tuyến tính không làm đổi tập mô hình, nên đáy vẫn cho cùng dự đoán. LinearRegression giải trực tiếp, không lặp, nên chẳng có gì để “hội tụ nhanh hơn”.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.2, random_state=0)
model = LinearRegression().fit(X_tr, y_tr)
print(model.score(X_tr, y_tr),
      model.score(X_te, y_te))
Kết quả0.9604123189943734 0.9689505848749018
Hai số là R2 train và test; hệ số trùng code tự viết.
Đọc hệ số cho đúng:
Hỏi nhanh
Linear regression cho hệ số dương giữa số kem bán ra và số vụ đuối nước mỗi tuần. Chỉ từ kết quả này, ta kết luận được gì?
Hệ số học từ dữ liệu quan sát chỉ nói hai đại lượng đi cùng nhau, không nói điều gì xảy ra nếu ta can thiệp.
“Tuyến tính” là theo tham số; đặc trưng có thể là x2, logx, x1x2.
Nếu t≈Cnk thì
logt=klogn+logCHồi quy trên trục log-log: hệ số góc ≈1.98, gợi tăng gần bậc hai trong miền đo. Với n=2⋅105: ngoại suy khoảng 38 giây; chưa là chứng minh Big-O.
Hỏi nhanh
Sau khi tạo thêm feature, mô hình nào không giải được bằng code linear regression của bài này?
Ba mô hình đầu tuyến tính theo w, chỉ cần tạo thêm cột. Ở mô hình cuối, w nằm trong hàm mũ.
LinearRegression trước để có mốc.Luyện đề 1
Với L(θ)=N−1∑n=0N−1(yn−θ⊤xn)2, gradient theo θ là gì?
Đạo hàm của bình phương cho hệ số 2, dấu theo hiệu dự đoán trừ target, rồi nhân với xn.
Luyện đề 2
Công thức nghiệm θ∗=(X~⊤X~)−1X~⊤y dùng được khi nào?
Cần X~⊤X~ khả nghịch, tức các cột của X~ độc lập tuyến tính. Cột diện tích theo dm² phá đúng điều kiện này.
Luyện đề 3
Hệ phương trình chuẩn của một bộ dữ liệu có số điều kiện cỡ 1010. Vì sao điều này đáng lo khi giải bằng máy?
κ cho biết sai số nhỏ ở đầu vào, kể cả sai số làm tròn, có thể bị phóng to bao nhiêu lần ở nghiệm. Với κ cỡ 1010, float64 chỉ còn khoảng 6 chữ số đáng tin, dù ma trận vẫn khả nghịch.
Linear regression cực tiểu MSE; nghiệm đóng là phép chiếu vuông góc.
Gradient descent cần η<2/λmax; chuẩn hóa đặc trưng làm bài toán dễ hơn nhiều.
Làm 10 câu kiểm tra cuối bài trên trang bài học.
Chạy notebook: đổi learning rate, thử bỏ bước chuẩn hóa, xem kết quả đổi ra sao.